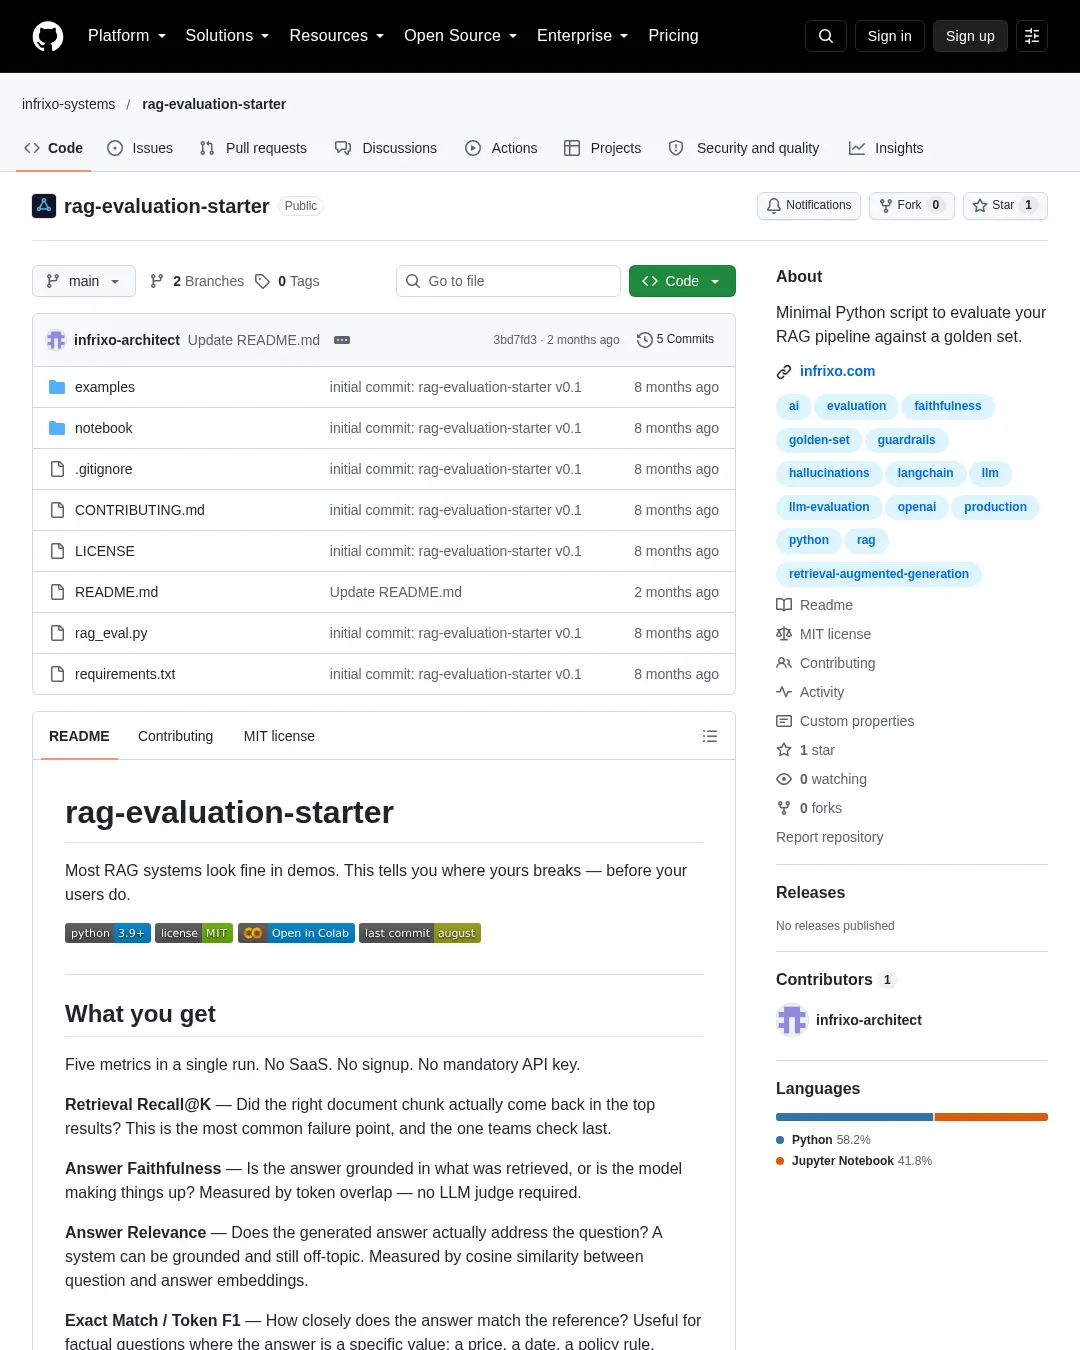
rag-evaluation-starter는 정답 세트(golden set)를 기준으로 검색 증강 생성(RAG) 시스템을 점검하는 파이썬 도구다. SaaS 가입이나 필수 API 키 없이 검색과 답변의 품질을 평가하며, 고정된 질문 묶음을 대상으로 한 시점의 진단에 쓰인다.
GitHub 저장소에는 예제 정답 세트와 Colab 노트북이 포함돼 있다. 빠른 실행에는 Python이 필요하며, Python 다운로드와 저장소의 MIT 라이선스를 참고할 수 있다.
설치와 실행
저장소를 복제하고 의존성을 설치한 뒤, 예제 정답 세트로 임베딩 기반 관련성 평가를 제외하고 실행할 수 있다.
git clone https://github.com/infrixo-systems/rag-evaluation-starter.git
cd rag-evaluation-starter
pip install -r requirements.txt
python rag_eval.py --golden examples/golden_set.json --no-embeddings
기본 실행은 몇 초 안에 색상으로 구분된 표를 터미널에 출력한다. 관련성 지표인 코사인 유사도까지 계산하려면 --no-embeddings를 빼면 된다. 이 경우 첫 실행 때 약 400MB 모델을 내려받는다.
자체 시스템을 연결하려면 검색기와 답변 생성기 함수를 제공한다. 아래 예시는 검색 결과에 text와 source_id를 담고, 검색 문맥을 이용해 답변을 생성하는 형태다.
from rag_eval import load_golden_set, evaluate, summarise, print_rich_table

# 1. Your retriever — returns [{text, source_id}, ...]
def my_retriever(question: str) -> list[dict]:
 results = my_vectorstore.similarity_search(question, k=3)
 return [{"text": r.page_content, "source_id": r.metadata["source"]} for r in results]

# 2. Your generator — returns an answer string
def my_generator(question: str, context: list[str]) -> str:
 ctx = "\n\n".join(context)
 response = openai_client.chat.completions.create(
 model="gpt-4o-mini",
 messages=[
 {"role": "system", "content": f"Answer using only this context:\n{ctx}"},
 {"role": "user", "content": question},
 ],
 )
 return response.choices[0].message.content

# 3. Run
golden = load_golden_set("examples/golden_set.json")
results = evaluate(golden, my_retriever, my_generator, k=3)
summary = summarise(results)
print_rich_table(results, summary)
embedder_fn은 선택 사항이며, 기본 임베더는 sentence-transformers/all-MiniLM-L6-v2다. 운영 환경에서 쓰는 임베딩과 일관성을 맞추려면 자체 임베더를 전달할 수 있다.
정답 세트와 지표
저장소는 지원 티켓을 살펴보고 최근 3개월 동안 어렵게 답했거나 오답을 낸 질문 30~50개를 뽑으라고 제안한다. 쉬운 사실 확인형, 여러 문서를 조합해야 하는 질문, 추론이 필요한 질문, 지식 베이스에 답이 없는 적대적 질문, 지식 범위의 경계에 있는 사례를 섞는다. 시작은 8개로 가능하지만, 8개보다 적으면 오답 하나가 지표를 12%포인트 움직일 수 있다고 설명한다. 예상 답은 짧고 구체적으로 쓰고, 문서가 바뀌면 정답 세트도 갱신해야 한다. 예제 파일 examples/golden_set.json은 가상의 결제 API를 다룬다.
도구는 한 번의 실행에서 다섯 종류의 지표를 제공한다.
Retrieval Recall@K는 관련 문서 조각이 상위 검색 결과에 포함됐는지 측정한다.- 답변 충실도는 답변이 검색된 내용에 근거하는지 토큰 중복으로 평가한다. 기본 방식에는 LLM 판정자가 필요하지 않다.
- 답변 관련성은 질문과 답변 임베딩 사이의 코사인 유사도로 계산한다.
- Exact Match와 Token F1은 답변이 기준 답안과 얼마나 일치하는지 본다. 특정 가격·날짜·정책처럼 답이 구체적인 사실 질문에 유용하다.
- 지연 시간과 비용은 질의 처리 시간과 LLM 판정 비용을 확인한다.
저장소는 Recall@K가 0.8~1.0이면 생성 품질에 집중하고, 0.5~0.8이면 청크 크기나 임베딩 모델을 조정하며, 0.5 미만이면 생성보다 검색을 먼저 고치라고 안내한다. 예를 들어 Recall@3이 0.6이면 질문의 40%에서 올바른 출처가 검색되지 않았다는 뜻이며, 이 경우 프롬프트 조정만으로 문제를 해결할 수 없다고 설명한다. 임계값은 시작점일 뿐 정답이 아니므로, 서비스 요구에 맞춰 rag_eval.py의 THRESHOLDS를 수정해야 한다.
기본 지표 외에 OpenAI 또는 Anthropic API 키를 설정하면 LLM 판정 기능을 쓸 수 있다. 판정자는 충실도와 관련성을 1~5점으로 평가하고 점수마다 한 문장 이유를 제시하며, 결과에는 [LLM-judged] 표시가 붙고 실행 뒤 비용 추정치가 나온다. 저장소는 GPT-4o-mini와 Claude Haiku의 위치·길이 편향 가능성을 지적하며, 판정 점수는 정답이 아닌 참고 신호로 보라고 안내한다.
한계와 추가 자료
이 도구는 고정된 정답 세트에 대한 시점별 진단용이며, 운영 환경에서 문제가 생기는 시점을 알려주는 지속 평가 도구는 아니다. 운영 문서가 바뀌었는데 정답 세트를 갱신하지 않으면 잘못된 확신을 줄 수 있다. Token F1은 의미가 같은 바꿔 쓰기를 낮게 평가할 수도 있다. 예를 들어 “authentication requires a Bearer token”과 “use Bearer token authentication”은 의미가 비슷해도 점수가 1.0보다 낮을 수 있다.
검색 재현율이 낮을 때는 256토큰 청크와 64토큰 겹침을 시도하거나, BAAI/bge-large-en-v1.5 같은 검색 중심 임베딩 모델, 재정렬기를 고려하라고 제안한다. 충실도가 낮으면 근거를 명시하는 시스템 프롬프트를 강화하고 max_tokens를 낮추거나 관련성 임계값으로 검색 결과를 거르는 방안을 안내한다. 관련성이 낮으면 재정렬기나 키워드·밀집 벡터를 결합한 하이브리드 검색을 고려할 수 있다.
지속 평가나 더 폭넓은 기능이 필요할 때 참고할 수 있는 도구로 Ragas, LangSmith, TruLens, DeepEval을 소개한다. 기여 방법은 CONTRIBUTING.md에 안내돼 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요