정규식 매칭은 단순하고 빠를 수 있다
*하지만 Java, Perl, PHP, Python, Ruby 등에서는 느릴 수 있다*
러스 콕스(Russ Cox) · 2007년 1월
정규식 처리에는 널리 쓰이는 재귀적 백트래킹 방식과, awk와 grep의 여러 구현이 사용하는 톰슨 NFA 방식이 있다. 병적인 정규식을 만나면 두 방식의 속도 차이가 크게 벌어진다. 이 글은 유한 오토마타에 기반한 정규식 처리 방법과 ANSI C로 작성한 구현을 설명한다.
백트래킹과 톰슨 NFA의 차이
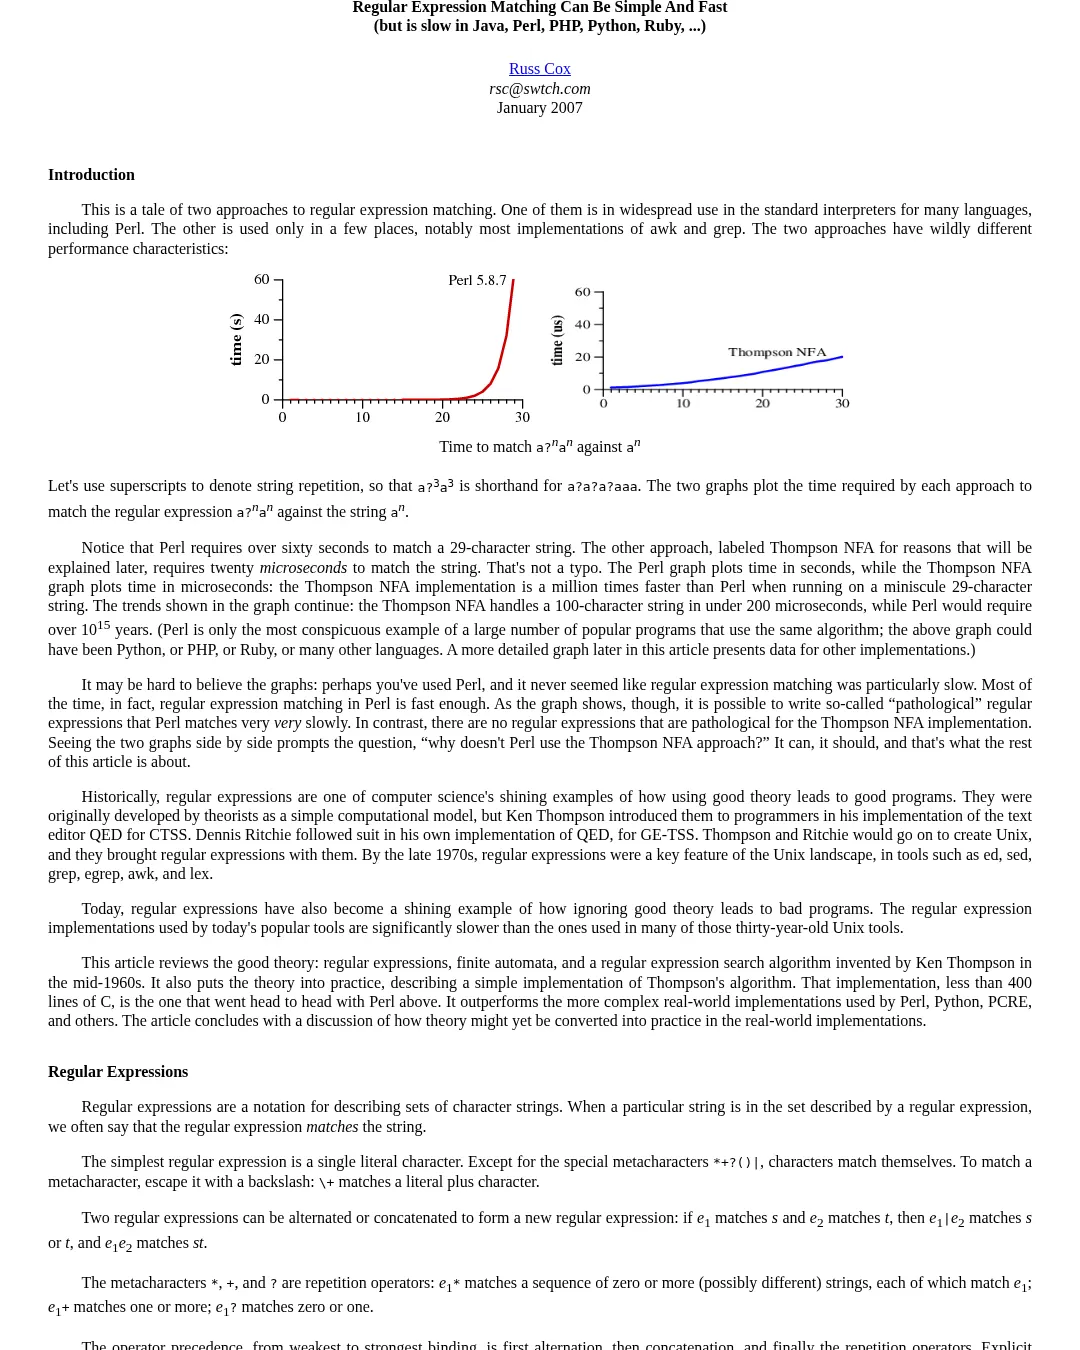
글에서 비교한 정규식은 a?를 n회 반복한 뒤 a를 n회 잇는 형태이며, 입력 문자열은 a를 n회 반복한 문자열이다. Perl은 길이 29자의 문자열을 처리하는 데 60초 넘게 걸린 반면, 톰슨 NFA 구현은 20마이크로초가 걸렸다. 글은 이 조건에서 두 구현의 차이가 백만 배라고 설명한다. 100자 문자열을 처리할 때 톰슨 NFA는 200마이크로초 미만이지만, Perl은 10¹⁵년 넘게 걸릴 것으로 제시됐다.
이는 모든 정규식에서 Perl이 느리다는 뜻은 아니다. 대부분의 경우 충분히 빠르지만, 특정 정규식에서는 실행 시간이 매우 길어질 수 있다. 글은 그런 정규식이 톰슨 NFA 방식에는 없다고 설명한다. Python, PHP, Ruby 등도 같은 알고리즘을 쓰는 경우가 있어 비슷한 문제가 생길 수 있다고 덧붙인다.
정규식은 문자열 집합을 나타내는 표기법이다. 리터럴 문자는 자기 자신과 일치하며, *, +, ?는 반복을 나타낸다. |는 선택, 이어 쓰기는 연결을 뜻한다. 연산자 우선순위는 선택, 연결, 반복 순이다. 예를 들어 ab|cd는 (ab)|(cd)와 같고 ab*는 a(b*)와 같다.
이 전통적인 문법은 정규 언어를 나타내기에 충분하다. 정규 언어는 고정된 양의 메모리만 사용해 텍스트를 한 번 훑으면서 매칭할 수 있는 문자열 집합으로 설명할 수 있다. Perl 계열 문법은 여러 연산자와 이스케이프 표기를 더했지만, 대개 표현을 간결하게 만들 뿐 전통 문법보다 더 강력한 기능을 주지는 않는다. Perl 정규식 문서
예외는 역참조(backreference)다. \1이나 \2는 앞서 괄호로 묶인 표현식이 매칭한 문자열과 똑같은 문자열을 요구한다. (cat|dog)\1은 catcat과 dogdog에는 매칭하지만 catdog에는 매칭하지 않는다. 역참조가 들어간 정규식은 이론적 의미의 정규식이 아니며, 최악의 경우 알려진 최선의 구현도 지수 시간 탐색을 요구한다. 따라서 역참조를 포함하지 않는 정규식에는 더 빠른 알고리즘을 쓸 수 있다.
유한 오토마타와 매칭
유한 오토마타는 상태를 오가며 문자열을 읽는 상태 기계다. 결정적 유한 오토마타(DFA)는 한 상태에서 입력 문자마다 다음 상태가 최대 하나로 정해진다. 비결정적 유한 오토마타(NFA)는 다음 상태가 여러 개일 수 있다. NFA는 가능한 경로 가운데 하나라도 입력 전체를 읽고 매칭 상태에 도달하면 문자열을 매칭한 것으로 본다. 입력을 소비하지 않고 이동하는 화살표도 둘 수 있다.
정규식과 NFA는 표현력이 같다. 글에서 설명하는 톰슨 구성법은 정규식의 하위 표현식마다 부분 NFA를 만들고, 연결·선택·반복 연산에 맞춰 결합한다. 마지막에 아직 연결되지 않은 화살표를 매칭 상태에 연결한다. 이 방법으로 만들어지는 NFA의 상태 수는 괄호를 제외한 정규식 길이보다 많지 않다.
NFA의 선택을 컴퓨터에서 흉내 내는 방법 가운데 하나는 한 경로를 택하고 실패하면 다른 경로를 시도하는 백트래킹이다. 이 방식은 같은 입력을 여러 차례 읽을 수 있고, 매칭에 실패하면 가능한 모든 경로를 살펴야 한다. 최악의 경우 경로 수가 지수적으로 늘어난다.
톰슨 방식은 선택 가능한 여러 상태를 동시에 추적한다. 각 입력 문자를 읽을 때 현재 상태 집합에서 해당 문자에 맞는 모든 이동을 진행한다. 매 단계에서 NFA의 모든 상태를 추적하더라도 상태 수는 정규식 크기에 비례해 제한되므로, 정규식 길이가 m이고 입력 길이가 n일 때 실행 시간은 O(mn)이다. 경로 자체는 지수적으로 많을 수 있지만, 어떤 경로로 각 상태에 도달했는지는 저장하지 않고 도달 가능한 상태 집합만 관리한다.
톰슨은 1968년 논문에서 여러 상태를 동시에 시뮬레이션하는 방식을 소개했다. 그의 구현에서는 NFA 상태를 기계어 명령어로 나타냈다. 이 글은 그 아이디어를 이식성 있는 ANSI C로 구현하며, 전체 소스는 400줄 미만이라고 설명한다. 소스 코드와 벤치마크 스크립트
구현 방식과 성능
정규식을 NFA로 바꾸는 구현은 먼저 중위 표기를 후위 표기로 바꾼다. 예를 들어 a(bb)+a는 abb.+.a.로 표현할 수 있다. 컴파일러는 후위 표현을 훑으며 스택에 NFA 조각을 쌓고, 연산자를 만나면 조각을 꺼내 연결하거나 선택 구조를 만든다. 각 조각은 시작 상태와 아직 연결되지 않은 화살표 목록으로 표현한다. 마지막 조각의 화살표를 매칭 상태에 연결하면 NFA가 완성된다.
시뮬레이션은 현재 상태 목록과 다음 상태 목록 두 개를 사용한다. 입력 문자를 하나씩 읽으며 현재 목록의 상태들을 진행시키고, 두 목록을 교환한다. 상태를 목록에 추가할 때는 이미 추가했는지 확인해 중복을 막는다. Split 상태라면 입력을 소비하지 않는 화살표를 따라 도달 가능한 상태를 목록에 넣는다. 목록을 매번 새로 할당하지 않도록 두 목록을 미리 준비해 번갈아 쓴다.
글은 a?를 n회 반복한 뒤 a를 n회 잇는 정규식이 a를 n회 반복한 문자열과 매칭되는 사례를 비교한다. 백트래킹 구현은 각 ?에 대해 매칭하거나 건너뛰는 선택을 해야 하며, 마지막 선택 조합에서야 매칭된다. 따라서 가능한 조합은 2ⁿ개이고 실행 시간은 O(2ⁿ)이다. 톰슨 방식은 정규식과 입력이 모두 길이 n인 이 사례에서 O(n²) 시간이 걸린다. 정규식을 고정하고 입력만 늘리는 일반 조건에서는 O(mn)이다.
벤치마크에서 Perl, PCRE, Python, Ruby는 재귀적 백트래킹을 사용하는 것으로 나타났다. PCRE는 n=23에서 최대 단계 수를 넘겨 중단하면서 올바른 답을 내지 못했다. Perl 5.6부터는 메모이제이션으로 재귀 탐색을 줄인다고 알려져 있지만, 글의 그래프에서는 역참조가 없는 정규식에서도 실행 시간이 지수적으로 증가했다. Java도 백트래킹 구현을 사용하지만 이 글의 벤치마크에는 포함되지 않았다. 글은 java.util.regex 인터페이스가 매칭 과정에 임의의 Java 코드를 끼워 넣을 수 있어 백트래킹 구현을 요구한다고 설명한다. PHP는 PCRE 라이브러리를 사용한다.
반면 awk, Tcl, GNU grep, GNU awk는 DFA를 미리 만들거나 실행 중 구성한다. 톰슨 알고리즘은 흔치 않은 예외 사례에만 유리하다는 반론에 대해, 글은 대부분의 입력에서는 빠르더라도 일부 입력에서 CPU 시간이 수년 이상 걸릴 수 있는 구현보다 입력 전반에서 예측 가능한 실행 시간을 내는 구현이 낫다고 주장한다. 실제 코드에서도 (.*)를 여러 차례 사용해 공백으로 구분된 필드를 나누거나, 흔한 경우를 선택지 앞에 두지 않은 정규식 등이 불필요한 비용을 만들 수 있다고 든다.
NFA 상태를 캐시해 DFA로 실행하기
DFA는 한 번에 한 상태에만 있으므로 NFA보다 실행이 효율적일 수 있다. NFA의 상태 집합 하나를 DFA의 상태 하나로 볼 수 있다. 톰슨 시뮬레이션은 각 문자를 처리할 때 다음 상태 집합을 계산하지만, 이를 버리지 않고 캐시하면 같은 전이를 다시 계산하지 않아도 된다. 글의 구현은 NFA 구현에 100줄 미만을 더해 필요할 때 DFA 상태를 만들어 저장한다.
이 방식은 검색 중 실제로 방문한 상태만 만든다. DFA 전체를 미리 구성하면 매칭이 조금 빨라질 수 있지만 시작 시간과 메모리 사용량이 늘어난다. 캐시가 너무 커지면 지금까지 만든 DFA를 버리는 정책도 둘 수 있다. 글에서 소개한 awk는 고정된 32개 상태 캐시를 사용하며, 이 때문에 앞선 그래프에서 n=28일 때 성능이 불연속적으로 변한다. NFA에서 같은 상태와 전이가 반복되는 경향이 있어 캐시는 유용하며, 이미 계산한 전이는 이후 메모리 접근 한 번으로 처리할 수 있다.
실제 정규식에서 고려할 기능
문자 클래스는 [0-9], \w, .처럼 여러 문자의 선택을 간결하게 나타낸다. 컴파일 중 선택 표현으로 풀 수도 있고, 별도의 NFA 상태로 나타낼 수도 있다. POSIX의 [[:upper:]]처럼 로케일에 따라 의미가 달라지는 클래스는 의미를 판별하는 과정이 까다롭지만, 그 의미를 NFA로 표현하는 일 자체는 어렵지 않다고 설명한다. 이스케이프 시퀀스는 \(처럼 메타문자를 문자 그대로 매칭하거나 \n처럼 입력하기 어려운 문자를 지정한다.
{n}, {n,m}, {n,} 같은 횟수 지정 반복은 역추적 방식에서는 반복문으로 구현할 수 있지만, NFA나 DFA 방식에서는 반복을 풀어 확장해야 한다. 예를 들어 e{3}은 eee, e{3,5}는 eee 뒤에 e?를 두 번 붙이는 형태로 바꿀 수 있다.
괄호로 묶은 하위 표현식이 입력의 어느 부분과 매칭됐는지 알아내는 하위 매칭 추출은 문자열을 나누거나 파싱할 때 유용하다. 이 기능은 재귀적 백트래킹을 선택하는 중요한 이유로 여겨져 왔지만, 글은 톰슨 알고리즘도 효율성을 유지하면서 하위 매칭 경계를 추적하도록 확장할 수 있다고 설명한다. 1985년 제8판 Unix의 regexp(3) 라이브러리는 그런 알고리즘을 구현했다.
입력 전체가 아니라 그 안의 부분 문자열을 찾는 비고정 검색도 하위 매칭 추출의 특수한 경우로 볼 수 있다. 전통적인 Unix 도구는 가장 왼쪽에서 시작하는 가장 긴 매칭 부분 문자열을 돌려준다. 탐욕적 반복 연산자는 전체 매칭을 유지하면서 가능한 한 많은 문자열을 소비하고, Perl의 비탐욕적 연산자는 가능한 한 적게 소비한다. 탐욕성은 전체 문자열의 매칭 여부를 바꾸지 않고 하위 매칭 경계만 바꾼다. 톰슨 알고리즘도 하위 매칭 추적을 확장해 비탐욕적 연산자를 지원할 수 있다.
^, $, \b 같은 단언은 주변 텍스트에 조건을 건다. 간단한 단언은 NFA에서 처리할 수 있고, 일반화된 전방·후방 탐색 단언은 더 어렵지만 원리상 NFA에 인코딩할 수 있다고 설명한다. 역참조를 효율적으로 구현하는 방법은 알려져 있지 않지만 불가능하다고 증명된 것도 아니다. 이 문제는 NP-완전 문제다. 역참조가 필요할 때만 백트래킹을 쓰고 그 밖의 정규식에는 톰슨 시뮬레이션을 쓰는 혼합 방식도 가능하다고 제안한다.
백트래킹의 메모이제이션은 지수적 증가를 막는 데 도움이 될 수 있지만, 텍스트 길이와 정규식 크기의 곱에 대략 비례하는 메모리를 요구한다. 백트래킹 호출 스택도 텍스트 길이에 따라 커지므로 긴 문자열에서는 스택 공간이 문제가 될 수 있다. 글은 다음 Perl 실행 사례에서 세그멘테이션 오류가 발생한다고 제시한다.
$ perl -e '("a" x 100000) =~ /^(ab?)*$/;'
Segmentation fault (core dumped)
$
현대의 정규식 구현은 유니코드처럼 큰 비ASCII 문자 집합도 다뤄야 한다. Plan 9 정규식 라이브러리는 NFA를 한 번에 유니코드 문자 하나씩 입력받아 실행하며, 입력 디코딩과 NFA 실행을 분리해 UTF-8과 와이드 문자 입력에 같은 매칭 코드를 사용한다. UTF-8 설명
역사와 결론
마이클 라빈(Michael Rabin)과 데이나 스콧(Dana Scott)은 1959년 비결정성과 NFA를 소개했고, 1976년 이 연구로 튜링상을 받았다. 정규식을 NFA로 바꾸는 구성법은 R. 맥노턴(R. McNaughton)과 H. 야마다(H. Yamada), 켄 톰슨(Ken Thompson)이 제시한 연구와 연결된다. 톰슨은 1968년 QED 편집기 구현에서 정규식을 사용했다. 이후 Unix의 egrep은 1979년 처음 등장하며 미리 계산한 DFA로 정규식을 처리했고, 1985년 제8판에서는 실행 중 DFA를 구성했다.
롭 파이크(Rob Pike)는 1980년대 초 sam 편집기를 만들며 하위 매칭 추적을 효율적인 NFA 시뮬레이션에 통합했다. 데이브 프레소토(Dave Presotto)가 이를 라이브러리로 분리했다. 헨리 스펜서(Henry Spencer)는 제8판 라이브러리 인터페이스를 재구현했지만 백트래킹을 사용했고, 이 구현은 Perl, PCRE, Python 등의 기반으로 널리 쓰였다. 파이크의 구현은 1992년 sam과 함께 공개됐지만 효율적인 검색 알고리즘은 널리 알려지지 않았다. 빌레 라우리카리(Ville Laurikari)는 1999년에 독립적으로 비슷한 알고리즘을 발견하고 이론적 기반을 발전시켰다.
이 글의 결론은 역참조를 제외하면 백트래킹 구현이 제공하는 기능 대부분을 오토마타 기반 구현으로 지원하면서 더 빠르고 일관된 성능을 낼 수 있다는 것이다. 다음 글인 정규식 매칭: 가상 머신 방식은 NFA 기반 하위 매칭 추출을 다루고, 실전의 정규식 매칭은 실제 구현을 살펴본다. 트라이그램 색인을 이용한 정규식 매칭은 Google Code Search의 구현을 설명한다.
참고 자료로는 톰슨의 1968년 논문과 논문 PDF, POSIX 정규식 규격, 역참조 관련 복잡도 설명을 들 수 있다. 전체 참고 문헌과 구현 자료는 원문 페이지에서 확인할 수 있다.
© 2007 Russ Cox. All Rights Reserved.
부록: 원문 예시
struct State
{
 int c;
 State *out;
 State *out1;
 int lastlist;
};
struct Frag
{
 State *start;
 Ptrlist *out;
};
Ptrlist *list1(State **outp);
Ptrlist *append(Ptrlist *l1, Ptrlist *l2);

void patch(Ptrlist *l, State *s);
State*
post2nfa(char *postfix)
{
 char *p;
 Frag stack[1000], *stackp, e1, e2, e;
 State *s;

 #define push(s) *stackp++ = s
 #define pop() *--stackp

 stackp = stack;
 for(p=postfix; *p; p++){
 switch(*p){
 /* compilation cases, described below */
 }
 }

 e = pop();
 patch(e.out, matchstate);
 return e.start;
}
int
match(State *start, char *s)
{
 List *clist, *nlist, *t;

 /* l1 and l2 are preallocated globals */
 clist = startlist(start, &l1);
 nlist = &l2;
 for(; *s; s++){
 step(clist, *s, nlist);
 t = clist; clist = nlist; nlist = t; /* swap clist, nlist */
 }
 return ismatch(clist);
}
int
ismatch(List *l)
{
 int i;

 for(i=0; i<l->n; i++)
 if(l->s[i] == matchstate)
 return 1;
 return 0;
}
void
addstate(List *l, State *s)
{
 if(s == NULL || s->lastlist == listid)
 return;
 s->lastlist = listid;
 if(s->c == Split){
 /* follow unlabeled arrows */
 addstate(l, s->out);
 addstate(l, s->out1);
 return;
 }
 l->s[l->n++] = s;
}
List*
startlist(State *s, List *l)
{
 listid++;
 l->n = 0;
 addstate(l, s);
 return l;
}
void
step(List *clist, int c, List *nlist)
{
 int i;
 State *s;

 listid++;
 nlist->n = 0;
 for(i=0; i<clist->n; i++){
 s = clist->s[i];
 if(s->c == c)
 addstate(nlist, s->out);
 }
}
struct DState
{
 List l;
 DState *next[256];
 DState *left;
 DState *right;
};
int
match(DState *start, char *s)
{
 int c;
 DState *d, *next;

 d = start;
 for(; *s; s++){
 c = *s & 0xFF;
 if((next = d->next[c]) == NULL)
 next = nextstate(d, c);
 d = next;
 }
 return ismatch(&d->l);
}
DState*
dstate(List *l)
{
 int i;
 DState **dp, *d;
 static DState *alldstates;

 qsort(l->s, l->n, sizeof l->s[0], ptrcmp);

 /* look in tree for existing DState */
 dp = &alldstates;
 while((d = *dp) != NULL){
 i = listcmp(l, &d->l);
 if(i < 0)
 dp = &d->left;
 else if(i > 0)
 dp = &d->right;
 else
 return d;
 }

 /* allocate, initialize new DState */
 d = malloc(sizeof *d + l->n*sizeof l->s[0]);
 memset(d, 0, sizeof *d);
 d->l.s = (State**)(d+1);
 memmove(d->l.s, l->s, l->n*sizeof l->s[0]);
 d->l.n = l->n;

 /* insert in tree */
 *dp = d;
 return d;
}
DState*
nextstate(DState *d, int c)
{
 step(&d->l, c, &l1);
 return d->next[c] = dstate(&l1);
}
DState*
startdstate(State *start)
{
 return dstate(startlist(start, &l1));
}
if(/([0-9]+-[0-9]+-[0-9]+) ([0-9]+:[0-9]+)/){
 print "date: $1, time: $2\n";
}
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요