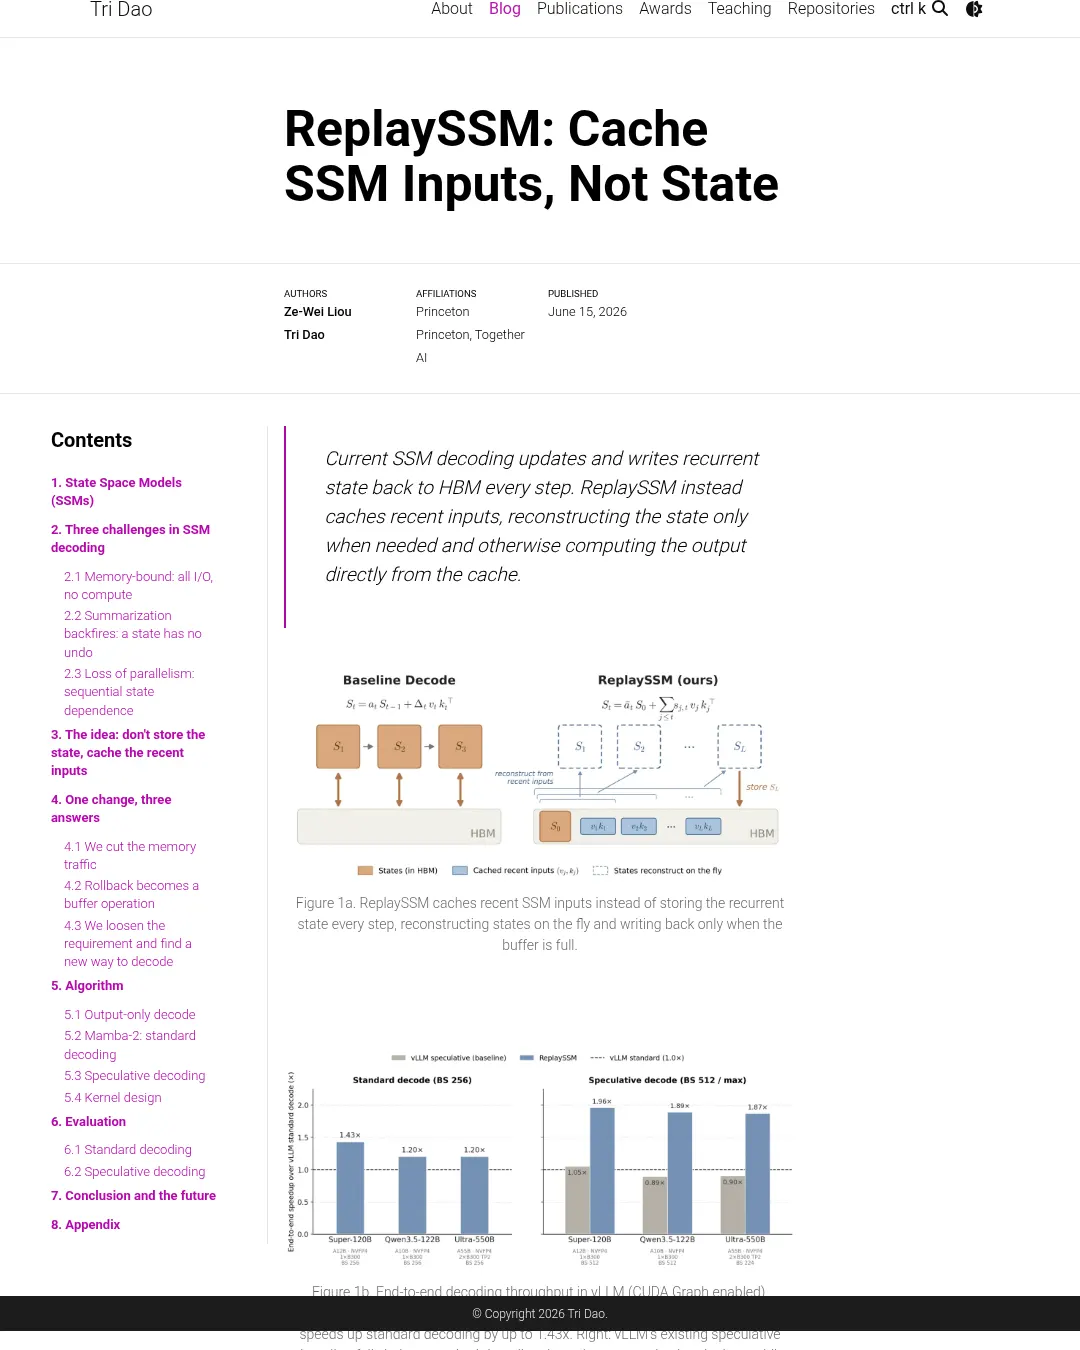
ReplaySSM은 상태 공간 모델(SSM)의 추론 과정에서 매 단계마다 갱신 상태를 메모리에 쓰는 대신 최근 입력을 저장하고, 필요할 때 상태를 재구성하는 방식이다. Tri Dao가 소개한 이 기법은 vLLM에 구현됐으며 표준 디코딩의 메모리 트래픽을 줄이고 추측 디코딩의 롤백을 간단하게 한다고 보고됐다.
ReplaySSM은 최근 입력을 작은 버퍼에 쌓고, 대부분의 단계에서는 체크포인트 상태와 버퍼를 이용해 출력만 계산한다. 버퍼가 차면 입력을 상태로 요약해 저장한다. 따라서 상태 저장은 버퍼를 비울 때만 발생한다. Mamba-2에서는 입력 벡터 쌍과 감쇠 계수를 저장하고, Gated DeltaNet(GDN)에서는 상태 갱신에 필요한 보정값을 저장한다. 원문은 이 방식이 부동소수점 오차 범위 안에서 기존 디코딩과 수학적으로 동등하다고 설명한다.
추측 디코딩에서는 거부된 초안 토큰에 해당하는 버퍼 항목을 제거하면 되므로, 토큰마다 상태 사본을 저장하고 복원할 필요가 없다. Mamba-2의 초안 출력은 각 토큰의 상태를 차례로 재구성하는 대신 출력만 계산해 병렬화한다. GDN은 학습에서 쓰는 청크 단위 병렬화 방식을 적용해 순차적인 상태 갱신을 삼각형 풀이로 대체한다.
vLLM에서 CUDA Graph를 켜고 평가한 결과, 표준 디코딩은 최대 1.48배 빨라졌으며 대형 MoE 모델에서는 최대 1.43배 빨라졌다. 추측 디코딩 처리량은 표준 디코딩 대비 1.87~1.96배였고, vLLM의 기존 추측 디코딩 경로 대비 최대 2.14배였다. 추측 디코딩 실험은 GSM8K 프롬프트, 초안 창 4, 온도 0 조건에서 진행했다. 고정 메모리 예산에서는 기존 추측 디코딩 경로보다 동시 요청을 3.0~3.3배 더 처리할 수 있었다.
평가는 Nemotron-3의 Mamba-2와 Qwen3.5의 GDN 계열을 대상으로 했으며, 모델 크기는 4B~550B였다. 표준 디코딩 속도 향상은 배치 크기 256에서 측정했고, 추측 디코딩 처리량 실험은 배치 크기를 최대 512까지 늘렸다. 결과는 ReplaySSM 구현을 vLLM에 적용한 평가이며, 다른 SSM 아키텍처로 확장하는 일은 향후 계획으로 제시됐다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요