TL;DR
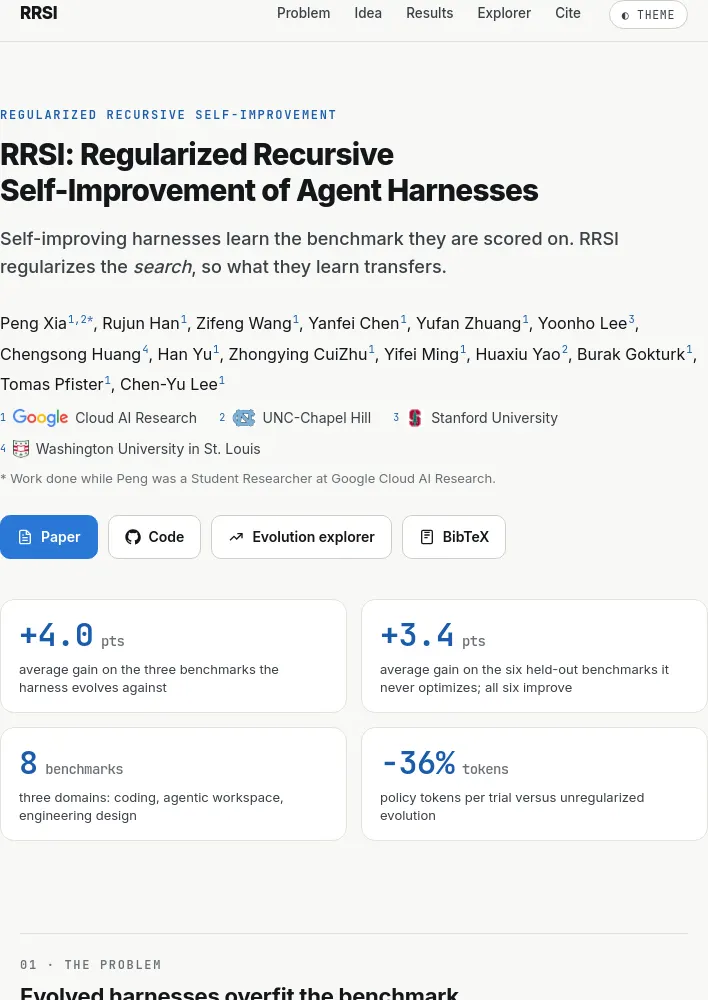
- RRSI(Regularized Recursive Self-Improvement)는 한 도메인의 벤치마크에서 진화한 에이전트 하니스가 다른 분포의 벤치마크에서도 개선되도록 하며, 진화에 사용한 분할에 과적합하지 않음.
- 기존 방법은 진화 세트에서 큰 성능 향상을 보이지만 벤치마크가 바뀌면 향상이 줄거나 사라지며, 두 방법은 시작 하니스보다도 낮은 점수를 기록함.
- RRSI는 하니스 구성 요소가 아니라 이를 수정하는 탐색 루프를 규제하며, 편집 예산·증거 기반 기록·정보 누출 검사·잡음 조정 기준·비용 규칙·가지치기를 적용함.
- 미사용 벤치마크 전반에서 성능을 높이고, 선행 방법 평균보다 최대 22.9% 높은 점수를 기록하며, 진화된 하니스 중 추론 토큰 비용도 가장 낮음.
- 네 가지 실제 실행의 후보 제안, 비평, 선택·탈락 이유, 정확한 변경 사항을 라운드별로 확인할 수 있으며 최종 하니스 변경 사항도 비교할 수 있음.
01 · 문제
- 진화된 하니스는 평가받는 벤치마크에 과적합되는 경향이 있음. RRSI는 분포 외 평가로 성능 향상을 이전함.
- RRSI는 진화에 사용한 분할에 과적합하지 않으면서 모든 분포 외 벤치마크를 개선함. 기존 방법은 반대로 진화 세트에서 큰 향상을 보인 뒤 벤치마크가 바뀌면 향상이 줄거나 사라지며, 두 방법은 시작 하니스보다 낮은 성능을 기록함.
- (a) 방법별 점 하나로 표시한 진화 분할 성능 향상과 분포 외 성능 향상 비교임. RRSI만 분포 외에서 향상 폭이 더 커짐.
- (b–d) 진화하지 않은 하니스 H0, 기존 방법 평균, RRSI의 홀드아웃 점수 비교임. RRSI는 기존 방법 평균을 최대 22.9% 앞섬.
02 · 아이디어
하니스가 아니라 탐색을 정규화
- 모든 하니스 구성 요소는 계속 편집 가능함. RRSI는 이를 편집하는 루프를 제약하며, 한 번의 제안이 바꿀 수 있는 범위와 실제 측정된 향상 중 유지할 항목을 통제함.
- RRSI 한 라운드에서는 제안자가 줄어드는 편집 예산을 사용하고 전체 기록을 확인함. 비평자는 점수 측정 전에 정보 누출 여부를 검사하며, 게이트는 후보가 잡음 바닥을 넘고 토큰 비용을 상쇄할 때만 채택함.
- 아래는 개략도이며 실제 라운드는 탐색기에서 확인할 수 있음.
제안 측면: 탐색 역량의 배분 방식
- 점감형 편집 예산(Annealed edit budget): 초기 라운드에는 메커니즘을 찾기 위해 몇 가지 조정된 변경을 함께 제안할 수 있고, 후반 라운드에는 원인을 구분할 수 있는 변경 하나만 허용함.
- 증거 인식형 기여도(Evidence-aware credit): 모든 후보의 가설, 차이점, 점수, 비용 변화를 기록하므로 제안자는 효과가 있었던 변경을 이어가고 실패한 변경의 재시험을 중단함.
- 구조화된 탐색(Structured exploration): 진행이 잡음 범위 안에서 멈추면, 예산을 아직 한 번도 건드리지 않은 구성 요소로 돌림.
선택 측면: 어떤 향상을 영구 반영하는가
- 정보 누출 비평자(Leakage critic): 작업 이름, 개체, 정답 또는 벤치마크별 로직이 포함된 후보는 점수를 측정하기 전에 거부함.
- 잡음 조정 기준(Noise-adjusted floor): 향상은 변경하지 않은 기본 하니스에서 측정한 분산을 넘어야 함.
- 비용 규칙(Cost rule): 추가 추론 토큰은 측정된 성능 향상으로 상쇄되어야 함.
- 가지치기(Pruning): 더는 기여하지 않는 구성 요소를 삭제 대상으로 표시함.
03 · 결과
모든 홀드아웃 벤치마크에서 성능 향상
- 도메인마다 한 개의 스위트에서 진화시킨 뒤, 하니스를 변경하지 않은 채 나머지 모든 벤치마크에서 실행함. H0와 동일한 도구, 평가자, 시험 횟수, 시간 구간을 사용하며 정책 모델은 Claude Opus 4.8임.
- 코딩 스위트는 통과율, Harvey LAB·JobBench·APEX-Agents는 모델 평가 루브릭 점수, GDPval은 인간 전문가 대비 승률, EngDesign·Frontier-Eng는 고정 시뮬레이터를 사용함.
- 비교 항목은 기존 방법, 절제 실험, 정책의 견고성, 보지 못한 백본임.
비용도 더 낮음
- 각 최종 하니스의 시험당 정책 토큰 수를 해당 하니스의 분포 외 평균과 비교함. RRSI는 진화된 하니스 중 토큰 사용량이 가장 적고, H0보다 1점 넘게 높은 성능을 내는 유일한 방법임.
- 비용에 직접 작용하는 규칙은 두 가지임.
- 비용 규칙은 후보를 제안할 때 성능 향상으로 상쇄되지 않는 비용 증가를 거부함.
- 가지치기는 시간이 지나 비용을 상쇄하지 못하게 된 변경을 제거함.
- 기존 방법에는 두 규칙이 모두 없음.
04 · 진화 탐색기
- 네 가지 실제 실행의 모든 후보를 라운드별로 확인할 수 있으며, 제안 내용, 비평자의 의견, 게이트가 후보를 유지하거나 버린 이유, 정확한 변경 사항을 보여줌.
- 항목을 선택해 살펴보고 왼쪽·오른쪽 화살표로 이동할 수 있음.
- 정규화 과정에서 하니스가 어떻게 적응했고 어떤 변경이 차단됐는지 확인할 수 있음.
- 최종 하니스 변경 사항(H0 → HT)을 표시할 수 있음.
05 · 인용
BibTeX
- 논문 정보: Xia, Peng, Han, Rujun, Wang, Zifeng, Chen, Yanfei, Zhuang, Yufan, Lee, Yoonho, Huang, Chengsong, Yu, Han, CuiZhu, Zhongying, Ming, Yifei, Yao, Huaxiu, Gokturk, Burak, Pfister, Tomas, Lee, Chen-Yu가 작성함.
- 학술지 정보: arXiv 사전 공개 논문, arXiv:2609.24972, 2026년임.
- 인용 키:
xia2026rrsi임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요