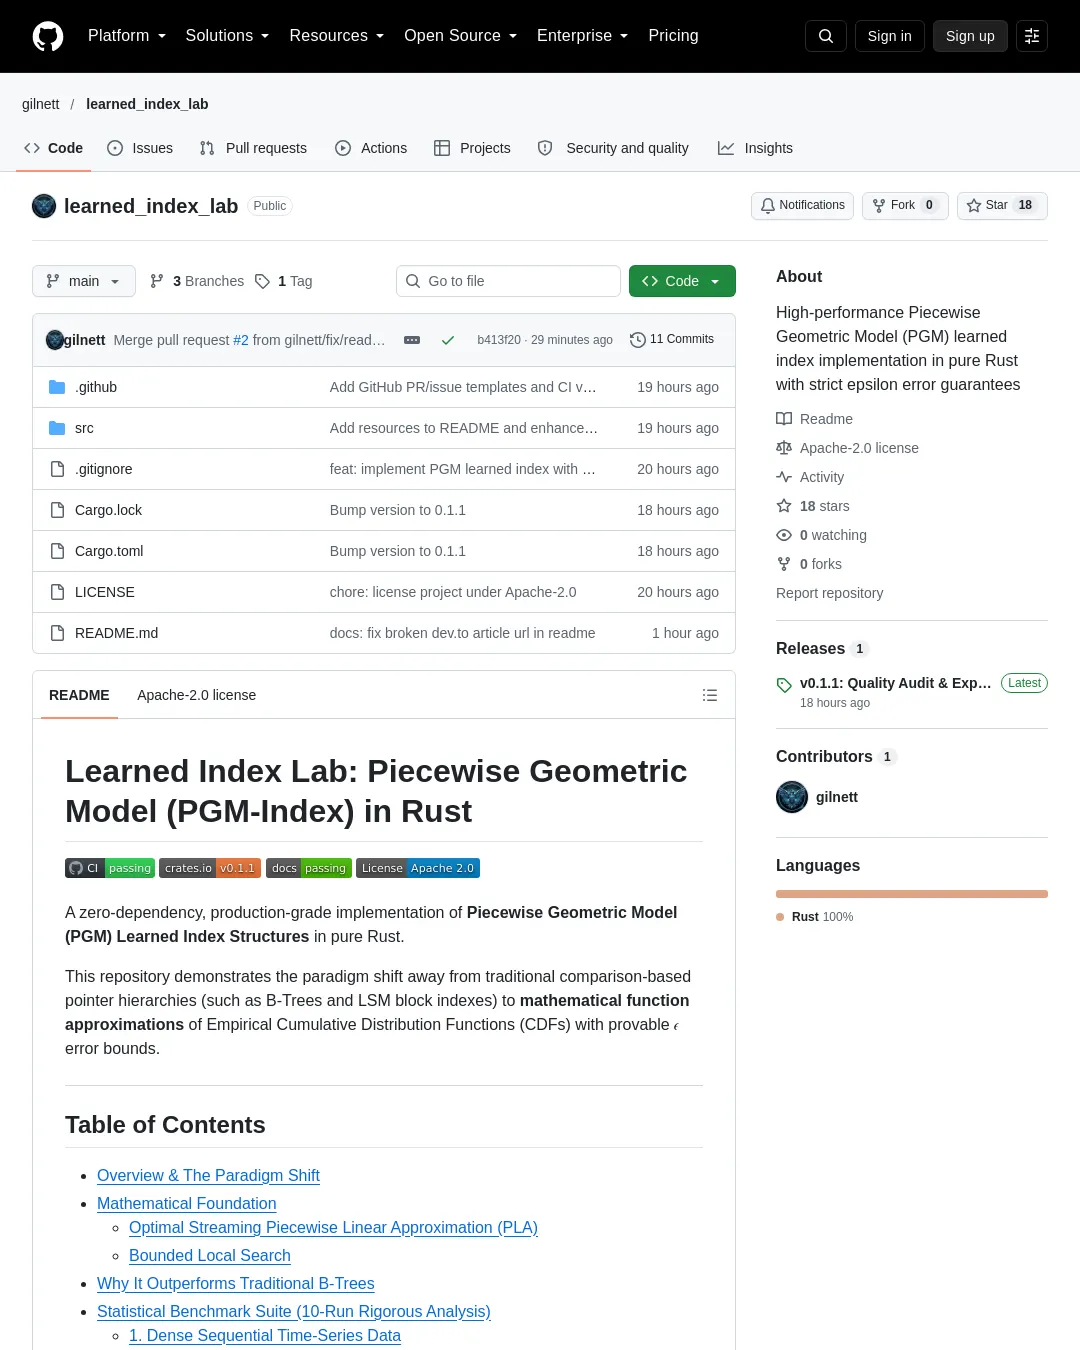
Rust로 구현한 learned_index_lab은 기존 B트리 대신 조각별 기하 모델(PGM) 학습 인덱스를 사용하는 저장소다. 저장소는 자체 벤치마크에서 100만 개 키를 대상으로 데이터 분포에 따라 인덱스 메모리를 99.89~99.99% 줄이고, 평균 조회 속도를 약 3배 높였다고 보고한다.
구조와 조회 방식
이 저장소는 외부 의존성이 없는 순수 Rust 구현체라고 소개한다. PGM 인덱스는 정렬된 키의 위치를 경험적 누적분포함수(CDF)의 근사값으로 계산한다. 데이터 전체에 포인터 기반 트리 노드를 만드는 대신, 키와 위치의 관계를 선형 함수 구간으로 나눈다. 각 구간의 위치 오차는 지정한 허용치 ε 이내로 제한한다고 설명한다.
인덱스 구축기는 데이터를 한 번 훑으며 구간을 만든다. 저장소 설명에 따르면 이 과정은 O(N) 시간과 O(1) 추가 공간을 사용한다. 구간의 시작점이 (x₀, y₀)일 때, 새로 관측한 점들은 허용 오차 ε 안에서 가능한 기울기 범위를 좁힌다. 가능한 기울기 범위가 더는 겹치지 않으면 기존 구간을 확정하고 다음 구간을 시작한다.
키를 찾을 때는 먼저 구간 배열을 이진 탐색해 해당 구간을 찾는다(O(log S), S는 구간 수). 이어 선형 함수로 위치를 추정하고, 추정 위치에서 ε만큼 떨어진 범위 안에서 다시 이진 탐색해 정확한 항목을 찾는다. 저장소는 조회 복잡도를 O(log S + log ε), 공간 복잡도를 O(S)로 제시하며, 정확 일치에서 오탐과 미탐이 없다고 설명한다.
저장소의 벤치마크
벤치마크는 저장소 설명에 따르면 x86_64 하드웨어에서 Rust 1.99의 --release 모드로 수행했다. 각 시나리오는 서로 다른 무작위 시드로 10회 연속 실행해 CPU 스케줄링 잡음과 캐시 효과를 줄이려 했다. 각 실행은 64비트 정수 키 100만 개와 조회 10만 건을 사용했고, 조회의 절반은 존재하는 키, 절반은 존재하지 않는 키였다. 아래 수치는 저장소가 보고한 결과이며, 별도 환경에서 검증한 결과는 아니다.
밀집된 순차 시계열 데이터에는 ε = 32를 적용했다. 10회 실행의 빌드 시간, 적중 조회 시간, 미적중 조회 시간은 각각 BTree와 PGM 순서로 다음과 같다.
- 실행 01: 77.7 ms / 3.1 ms; 288.3 ns / 116.2 ns; 14.1 ns / 0.9 ns; 적중 속도 향상 2.48배; 구간 93개
- 실행 02: 77.4 ms / 3.3 ms; 262.6 ns / 84.0 ns; 8.6 ns / 0.7 ns; 3.13배; 구간 84개
- 실행 03: 72.4 ms / 3.1 ms; 263.4 ns / 70.0 ns; 8.7 ns / 0.6 ns; 3.76배; 구간 81개
- 실행 04: 79.8 ms / 4.4 ms; 322.7 ns / 119.7 ns; 11.6 ns / 0.8 ns; 2.70배; 구간 83개
- 실행 05: 77.2 ms / 3.1 ms; 282.8 ns / 78.2 ns; 10.8 ns / 0.6 ns; 3.62배; 구간 84개
- 실행 06: 73.0 ms / 3.1 ms; 311.0 ns / 102.8 ns; 8.8 ns / 0.7 ns; 3.03배; 구간 81개
- 실행 07: 75.4 ms / 4.6 ms; 323.7 ns / 103.5 ns; 17.9 ns / 0.9 ns; 3.13배; 구간 81개
- 실행 08: 72.9 ms / 3.1 ms; 286.6 ns / 87.8 ns; 8.5 ns / 0.7 ns; 3.26배; 구간 80개
- 실행 09: 76.1 ms / 3.6 ms; 309.3 ns / 126.6 ns; 9.0 ns / 1.2 ns; 2.44배; 구간 83개
- 실행 10: 73.9 ms / 3.4 ms; 265.4 ns / 108.5 ns; 8.6 ns / 1.0 ns; 2.45배; 구간 82개
- 평균: 빌드 75.57 ms / 3.49 ms; 적중 291.6 ns / 99.7 ns; 미적중 10.7 ns / 0.8 ns; 적중 조회 3.00배 향상; 구간 83개
저장소는 이 분포에서 키 100만 개를 선형 구간 83개로 표현해 12,048배 압축했다고 보고한다. 인덱스 메모리는 BTreeMap의 45.78 MB에서 PGM의 3.1 KB로 줄었으며, 적중 조회는 평균 3.00배, 미적중 조회는 13.3배 빨라졌다고 제시한다.
균등한 희소 무작위 키에는 ε = 16을 적용했다. 저장소가 보고한 평균값은 다음과 같다.
| 측정 항목 | BTreeMap | PGM-Index | 개선 결과 |
|---|---|---|---|
| 평균 빌드 시간 | 76.01 ms | 3.34 ms | 22.8배 빠름 |
| 인덱스 메모리만 측정 | 45.78 MB | 48.1 KB | 메모리 99.89% 감소 |
| 구간 수 | 수천 개 노드 | 1,406개 구간 | 711배 압축 |
| 평균 적중 지연 시간 | 264.6 ns/op | 89.4 ns/op | 2.98배 빠름(최소 73.2 ns, 최대 109.9 ns) |
| 평균 미적중 지연 시간 | 251.7 ns/op | 81.6 ns/op | 3.08배 빠름 |
| 검증 | 일치율 100.0% | 일치율 100.0% | 10회 실행에서 불일치 없음 |
군집형 중꼬리 로그정규 분포에도 ε = 16을 적용했다. 저장소는 웹 트래픽 요청, 금융 거래 규모, 파일 크기 분포를 모사하는 시나리오라고 설명한다.
| 측정 항목 | BTreeMap | PGM-Index | 개선 결과 |
|---|---|---|---|
| 평균 빌드 시간 | 75.04 ms | 3.24 ms | 23.1배 빠름 |
| 인덱스 메모리만 측정 | 45.78 MB | 12.1 KB | 메모리 99.97% 감소 |
| 구간 수 | 해당 없음 | 455개 구간 | 2,197배 압축 |
| 평균 적중 지연 시간 | 260.2 ns/op | 81.3 ns/op | 3.21배 빠름(최소 69.2 ns, 최대 92.1 ns) |
| 평균 미적중 지연 시간 | 68.7 ns/op | 42.0 ns/op | 1.64배 빠름 |
| 검증 | 일치율 100.0% | 일치율 100.0% | 10회 실행에서 불일치 없음 |
적용 사례로 제시한 분야와 사용법
저장소는 정렬된 대량 데이터를 다루는 컬럼형 OLAP 데이터베이스(ClickHouse, DuckDB, Parquet)에서 레코드 오프셋을 찾는 용도, RocksDB·ScyllaDB·LevelDB 같은 LSM 저장 엔진의 불변 SSTable에서 희소 블록 인덱스를 대체하는 용도 등을 예로 든다. 파일 인덱싱·카탈로그와 고속 네트워크 라우팅의 전달 정보 기반(FIB)도 적용 분야로 언급한다. 이 내용은 저장소가 제시한 활용 가능성이다.
사용하려면 Cargo.toml에 learned_index_lab을 추가하거나 pgm.rs를 프로젝트에 직접 포함한다. 다음 예시는 정렬된 데이터를 준비하고, 최대 오차 16으로 인덱스를 만든 뒤 키를 찾고 인덱스 메모리 정보를 확인하는 저장소의 코드다.
use pgm::PgmIndex;

fn main() {
 // 1. Prepare sorted data
 let data: Vec<u64> = vec![
 100, 105, 110, 115, 120, 250, 500, 1000, 1500, 2000, 5000, 10000
 ];

 // 2. Build the PGM index with maximum error epsilon (e.g. 16 or 32)
 let pgm = PgmIndex::build(data, 16);

 // 3. Point lookup (O(log S + log epsilon))
 match pgm.find(1500) {
 Some(index) => println!("Found key at position: {}", index),
 None => println!("Key not present in dataset"),
 }

 // 4. Inspect memory overhead
 println!("Total segments created: {}", pgm.segments.len());
 println!("Index-only memory: {} bytes", pgm.index_only_bytes());
}
테스트와 10회 벤치마크를 직접 실행하려면 다음 명령을 사용한다. 저장소는 단위 테스트가 경계 사례, 간격, 중복을 다룬다고 설명한다.
# Clone the repository
git clone https://github.com/gilnett/learned_index_lab.git
cd learned_index_lab

# Run unit tests covering edge cases, gaps, and duplicates
cargo test

# Execute the 10-run release benchmark suite
cargo run --release
자료와 라이선스
- 프로젝트 저장소
- 기술 설명 글: CPU 캐시, 메모리 장벽, CDF 근사와 시스템 적용을 다룬다.
- Kraska 외, 2018년 SIGMOD 논문 The Case for Learned Index Structures
- Ferragina와 Vinciguerra, 2020년 VLDB 논문 The PGM-index: a data-structure with a guarantee on space and time efficiency
- 참고용 C++ PGM 구현
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요