TL;DR
- 자기 경험에 대한 설명만으로 미세 조정하는 회고 전용 미세 조정(Retrospection-Only Fine-Tuning, ROFT)은 Qwen3.5-4B의 소프트웨어 엔지니어링 성능을 향상시키며, 검증기나 보상 기반 정책 업데이트 없이 GRPO보다 적은 업데이트로 더 높은 해결률을 기록함.
- ROFT는 에이전트가 작업을 시도하고 피드백을 확인한 뒤 회고 설명을 생성하며, 설명 토큰에만 다음 토큰 예측 손실을 적용하는 온라인 절차임.
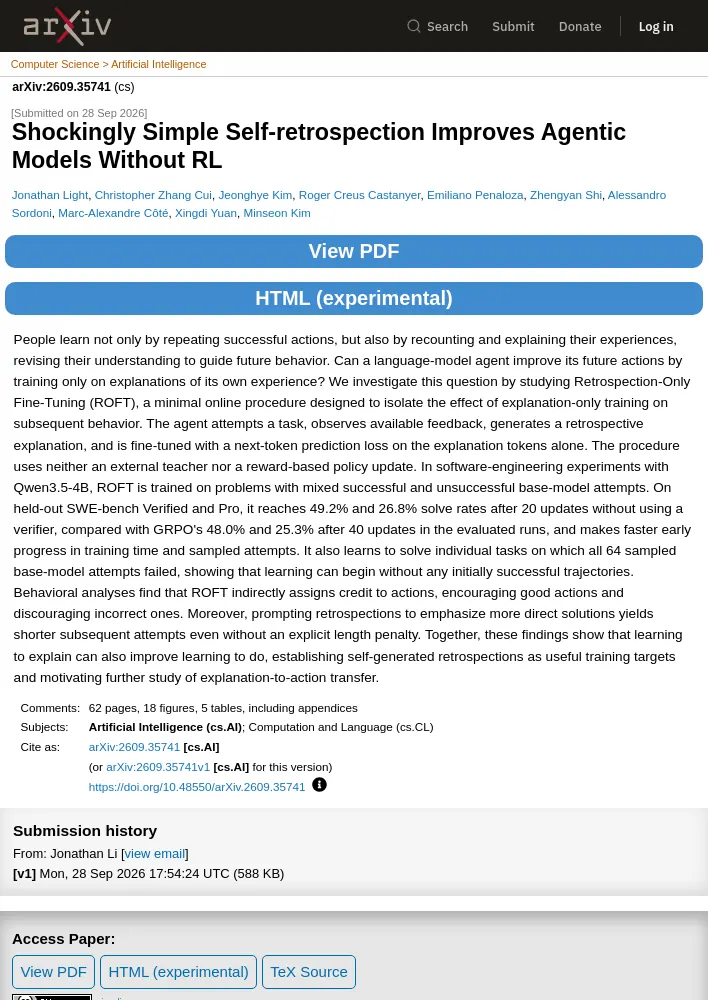
- 학습에 성공·실패 시도가 섞인 문제를 사용하며, 검증 데이터인 SWE-bench Verified와 Pro에서 각각 49.2%, 26.8%의 해결률을 달성함.
- 평가된 실행에서 GRPO는 업데이트 40회 후 48.0%, 25.3%를 기록한 반면, ROFT는 업데이트 20회 후 해당 성능에 도달하며 학습 초기 속도와 샘플링 시도 횟수에서도 더 빠른 진전을 보임.
- ROFT는 기본 모델의 시도 64회가 모두 실패한 개별 과제도 해결하며, 직접적인 해법을 강조하는 회고를 유도하면 명시적 길이 페널티 없이 후속 시도가 짧아짐.
연구 질문과 방법
- 사람은 성공한 행동을 반복하는 것뿐 아니라 경험을 되짚고 설명하며 이해를 수정해 이후 행동을 이끎. 이 연구는 언어 모델 에이전트가 자기 경험에 대한 설명만으로 학습해 이후 행동을 개선할 수 있는지 조사함.
- 회고 전용 미세 조정(ROFT)은 설명만을 이용한 학습이 후속 행동에 미치는 효과를 분리해 살펴보도록 설계된 최소한의 온라인 절차임.
- 절차는 에이전트의 작업 시도, 이용 가능한 피드백 관찰, 회고 설명 생성, 설명 토큰만을 대상으로 한 다음 토큰 예측 손실 기반 미세 조정으로 구성됨.
- 외부 교사 모델과 보상 기반 정책 업데이트를 모두 사용하지 않음.
소프트웨어 엔지니어링 실험 결과
- Qwen3.5-4B를 대상으로 성공과 실패가 섞인 기본 모델 시도에서 ROFT를 학습함.
- 보정 데이터와 분리된 SWE-bench Verified 및 SWE-bench Pro에서 업데이트 20회 후 각각 49.2%, 26.8%의 해결률을 달성함. 검증기는 사용하지 않음.
- 비교 대상인 GRPO는 평가된 실행에서 업데이트 40회 후 각각 48.0%, 25.3%의 해결률을 기록함.
- ROFT는 학습 시간과 샘플링된 시도 횟수 기준으로 학습 초기부터 더 빠른 진전을 보임.
- 기본 모델의 샘플링된 시도 64회가 모두 실패한 개별 과제도 학습을 통해 해결함. 처음부터 성공한 궤적이 없어도 학습이 시작될 수 있음을 보이는 결과임.
행동 분석과 시사점
- 행동 분석 결과, ROFT는 행동에 간접적으로 크레딧을 배정해 좋은 행동은 장려하고 잘못된 행동은 억제하는 양상을 보임.
- 더 직접적인 해결책을 강조하도록 회고를 유도하면 명시적인 길이 페널티가 없어도 이후 시도가 짧아짐.
- 설명하는 법을 학습하는 것이 수행하는 법의 학습도 향상할 수 있음을 보이며, 자기 생성 회고를 유용한 학습 목표로 제시하고 설명에서 행동으로의 전이를 추가 연구할 근거를 제공함.
논문 정보
- 제목: *Shockingly Simple Self-retrospection Improves Agentic Models Without RL*
- 저자: Jonathan Light, Christopher Zhang Cui, Jeonghye Kim, Roger Creus Castanyer, Emiliano Penaloza, Zhengyan Shi, Alessandro Sordoni, Marc-Alexandre Côté, Xingdi Yuan, Minseon Kim.
- 제출일: 2026년 9월 28일. 분야: 인공지능(cs.AI), 계산 및 언어(cs.CL). arXiv 식별자: arXiv:2609.35741.
- DOI: https://doi.org/10.48550/arXiv.2609.35741
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요