TL;DR
- 4,668개 이모지를 대상으로 한 의미 검색에서는 임베딩 검색이 Jev보다 빠르고 저렴하며, 일부 검색에서는 더 나은 결과를 냄.
- 임베딩 검색은 알려진 항목 집합과의 매칭에 적합하고, 이모지 검색에서는 브라우저 내 모델로도 구현 가능함.
- 테스트에서 Jev의 품질은 임베딩보다 근소하게 높았지만 비용은 1,000~10,000배, 지연 시간은 약 2배 높음.
- Jev는 전체 카탈로그를 입력으로 받아야 하므로 매 검색마다 58,187개 입력 토큰이 필요하며, 먼저 후보를 좁히면 사실상 임베딩 검색을 구축한 셈임.
- 알려진 레이블의 분류에는 소형 분류기나 미세 조정 모델이 더 저렴하고 정확하며, 맥락이나 지식에 기반한 추론이 필요한 결정에는 Jev가 적합함.
의미 기반 이모지 검색
- 최근 Jev에 대한 관심이 높으며, 새로운 활용 방식과 낮은 비용 등 장점이 있지만, 분류 작업을 모두 Jev로 해결하려는 접근은 적절하지 않음.
- Jev는 결정에 대형 언어 모델(LLM)의 추론이 필요할 때 사용하는 것이 적합함.
- Gergely Orosz는 Linear가 이모지 선택기에 Jev를 통합한 점을 높이 평가했으며, Google Docs의 이모지 선택기는 약 20년 동안 불편한 상태로 남아 있고 무료·유료 계정 모두에서 ✅ 아이콘을 찾기 어렵다고 언급함.
- 이 사례를 비판하려는 의도는 없지만, Jev를 이모지 검색에 적용한 선택은 적절하지 않다고 봄. 2년 전에 LLM 없이 임베딩만으로 의미 기반 이모지 검색을 만들었으며, Jev보다 빠르고 저렴했고 때로는 더 나은 결과를 냄.
- 데이터베이스와 임베딩 모델 또는 제공자를 설정하는 일은 Jev를 바로 사용하는 것보다 수고가 더 듦. 2년 전이라면 Vercel의 Slack 이모지를 수집하고 검색 기능을 구현하기 위해 Opus 3/GPT-4-turbo를 사용하는 대신 Jev를 택했을 것임.
- 하지만 현재는 모델이 작업을 자율적으로 수행할 역량을 충분히 갖춰, 구현 부담이 과거와 같지 않음.
Slack 이모지 수집
- Slack의
admin.emoji.list를 사용하려면 관리자 권한이 필요했음. - 일반 Slack 정회원은 대체로 ‘이모지 사용자 지정’ 페이지에 접근할 수 있으므로, LLM으로 브라우저 개발자 도구에 붙여 넣을 스크립트를 작성해 웹페이지를 탐색하고 이모지를 노트북에 내려받음.
벤치마크 결과
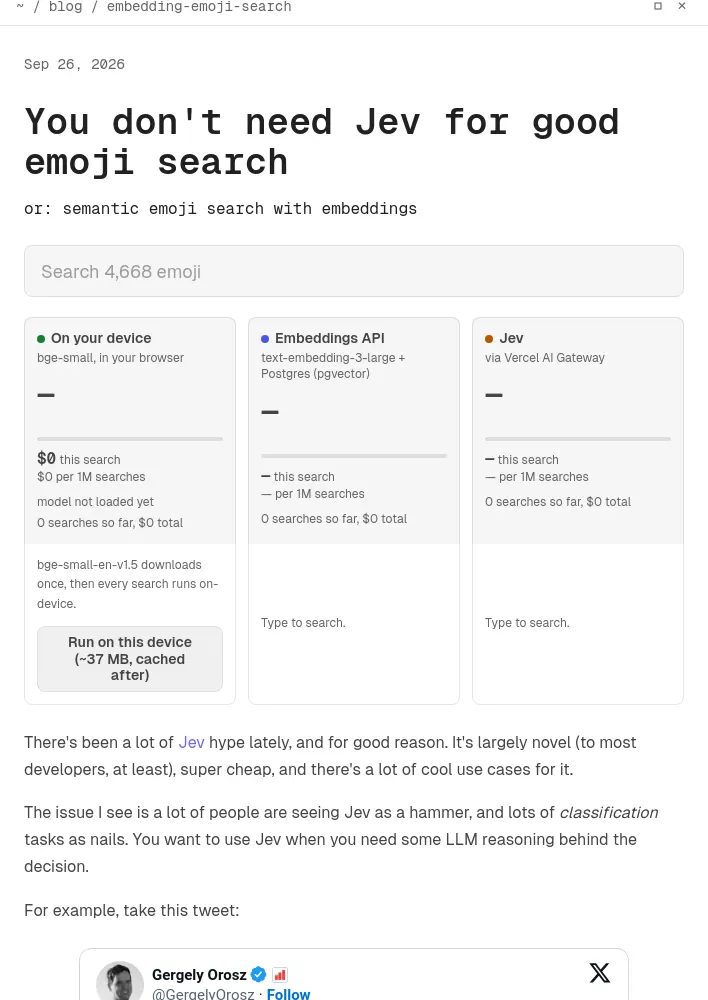
- 글을 작성하고 다른 일을 처리한 약 한 시간 동안 Claude가 Vercel AI Gateway에서 사용할 수 있는 여러 임베딩 모델과 Jev의 벤치마크를 실행함.
- Jev의 품질은 근소하게 더 높았지만, 비용은 1,000~10,000배, 지연 시간은 약 2배 높았으며 입력 토큰 수에 따라 차이가 큼.
- Claude가 위 데모를 만들었으며, 추가로 바이너리 임베딩을 사용하는 브라우저 내 로컬 모델도 구현함.
측정 방식과 유의 사항
- 검색 대상: 표준 유니코드 이모지 1,914개와 slackmoji의 커뮤니티 맞춤 이모지 2,754개를 합친 총 4,668개이며, 대규모 Slack 워크스페이스를 대변하는 데이터임.
- 품질 측정: 이름, ‘hallowelen’ 같은 오타, ‘lgtm’이나 ‘greatest of all time’ 같은 의도를 포함한 쿼리 56개를 직접 라벨링함. 모든 검색 엔진이 같은 카탈로그를 검색하고 같은 라벨로 평가되지만, 라벨은 개인의 판단에 기반함.
- 지연 시간: Postgres 데이터베이스(Neon)와 가까운 iad1의 Vercel 함수 안에서 계산 시간을 측정함. 네트워크 시간은 서버 검색 항목 두 가지에 추가되며 데모에서 별도로 표시됨. 기기 내 검색 시간은 하드웨어에 따라 달라짐.
- 제공자: 임베딩은 AI Gateway를 통한 OpenAI의
text-embedding-3-large이며, 차원 수는 1,024임. 7개 모델을 시험한 뒤 재현율을 기준으로 선택했으며, 약 50밀리초로 가장 빨랐던 모델은 적절한 이모지를 훨씬 덜 자주 찾음. - Jev는 AI Gateway를 통한
typesafe-ai/jev이며, TypeSafe와 DigitalOcean 배포 사이에서 라우팅됨. 테스트 중 한동안 두 제공자 모두 503 오류를 반환해 해당 검색은 실패함. - Jev의 입력 범위: Jev는 주어진 선택지 안에서만 고를 수 있어 매 검색마다 이모지 이름 4,668개 전체를 전달하며, 입력 토큰은 58,187개로 두 요청에 나뉨. 먼저 후보를 좁히면 이 문제를 피할 수 있지만, 그 시점에는 이미 임베딩 검색을 구축한 셈임.
- 설명 생성: 이모지 이름이 간결하므로 저렴한 모델인 Gemini Flash Lite가 각 이모지의 사용 방식을 한 줄로 작성했으며, 맞춤 이모지는 이미지도 확인함. 일회성 비용은 1.67달러였고, 생성한 설명은 두 임베딩 엔진에 모두 적용됨.
- Jev에는 이름만 전달함. 설명을 프롬프트에 포함한 초기 실험은 결과가 더 나빴고 비용은 2.5배 높았음.
- 캐싱: 이미 실행된 검색은 Vercel Runtime Cache 또는 CDN에서 반환되므로 모델, 데이터베이스, Jev를 다시 호출하지 않음. 표시되는 시간과 비용은 최초 계산 당시의 값임.
- 기기 내 모델은 첫 다운로드 후 브라우저에 캐시되며, 이후 방문에서는 자동으로 로드됨.
- 기기 내 구성:
bge-small-en-v1.5(35MB)를transformers.js와 Web Worker로 실행함. 각 이모지는 빠른 후보 선별용 384비트와 순위 산정용 384바이트로 저장되며, 전체 데이터 크기는 2.1MB임.
Jev를 사용할 상황
- 이모지나 문서처럼 알려진 집합에서 대상을 찾는 작업에는 임베딩을 사용함.
- 레이블이 정해진 분류 작업에는 소형 분류기나 미세 조정 모델이 더 저렴하고 정확하며, Opus 5.5 같은 모델로 쉽게 학습할 수 있음.
- 정답이 맥락에 좌우되거나 임베딩 공간에 담기지 않는 지식이 필요한 추론에는 Jev를 사용함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요