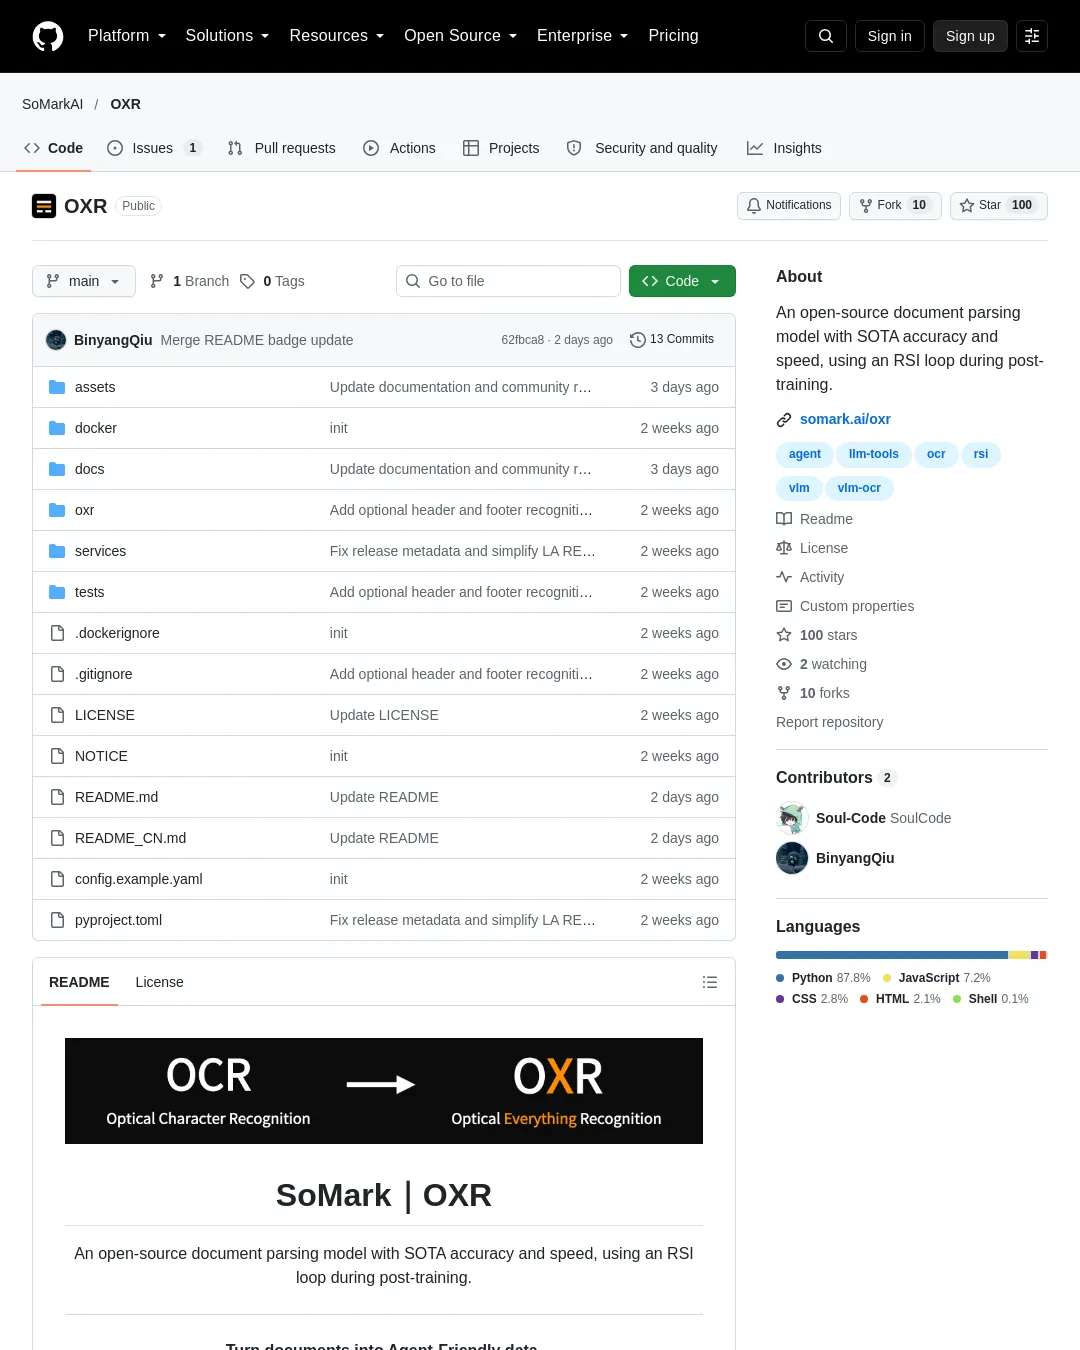
SoMark 팀이 PDF와 문서 이미지를 마크다운이나 JSON으로 변환하는 오픈소스 모델 OXR-1.0을 공개했다. 팀은 매개변수 13억 개 규모인 이 모델이 olmOCR-Bench, OmniDocBench, DocParsingBench에서 1위를 기록했고 속도도 앞선다고 밝혔다.
OXR은 문서 요소 13종을 인식하고 위치 좌표와 읽기 순서를 포함한 결과를 낸다. 수식은 LaTeX, 표는 HTML 또는 마크다운으로 출력할 수 있으며 화학식·화학 구조·코드 블록도 지원한다. SoMark 팀은 사후 학습에 재귀적 자기 개선(RSI) 과정을 적용해 모델이 잘못 처리하거나 취약한 샘플을 겨냥했으며, 사람의 주석 없이 성능을 개선했다고 설명한다. 벤치마크 결과와 재현 방법은 저장소의 평가 문서에 공개돼 있다.
레이아웃 분석 모델은 OXR의 인식·읽기 순서 처리 모델과 분리돼 있어, 사용자가 자체 모델로 교체할 수 있다. SoMark 팀은 이 설계가 문서 분야별로 다른 레이아웃 요구에 맞춰 적용하기 쉽다고 설명한다.
온라인 데모와 무료 API는 가입이나 API 키 없이 시험할 수 있다. 다만 무료 API는 요청이 대기열에 들어가 처리 속도가 달라질 수 있으며, 서비스 안정성을 보장하지 않아 운영 환경에는 권장되지 않는다. SoMark 팀은 운영 비용을 감당할 수 없을 때까지 무료 API를 제공한다고 밝혔다.
직접 실행하려면 Linux와 BF16을 지원하는 NVIDIA GPU가 필요하다. 낮은 동시성으로 시작할 때 단일 GPU 메모리 24GB, 긴 문서나 높은 동시성에는 48GB 이상을 권장하며, NVIDIA 드라이버는 CUDA 13.0과 호환돼야 한다. 모델은 Hugging Face와 ModelScope에서 받을 수 있다. OXR은 Apache 2.0에 추가 조건을 둔 별도 라이선스로 배포된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요