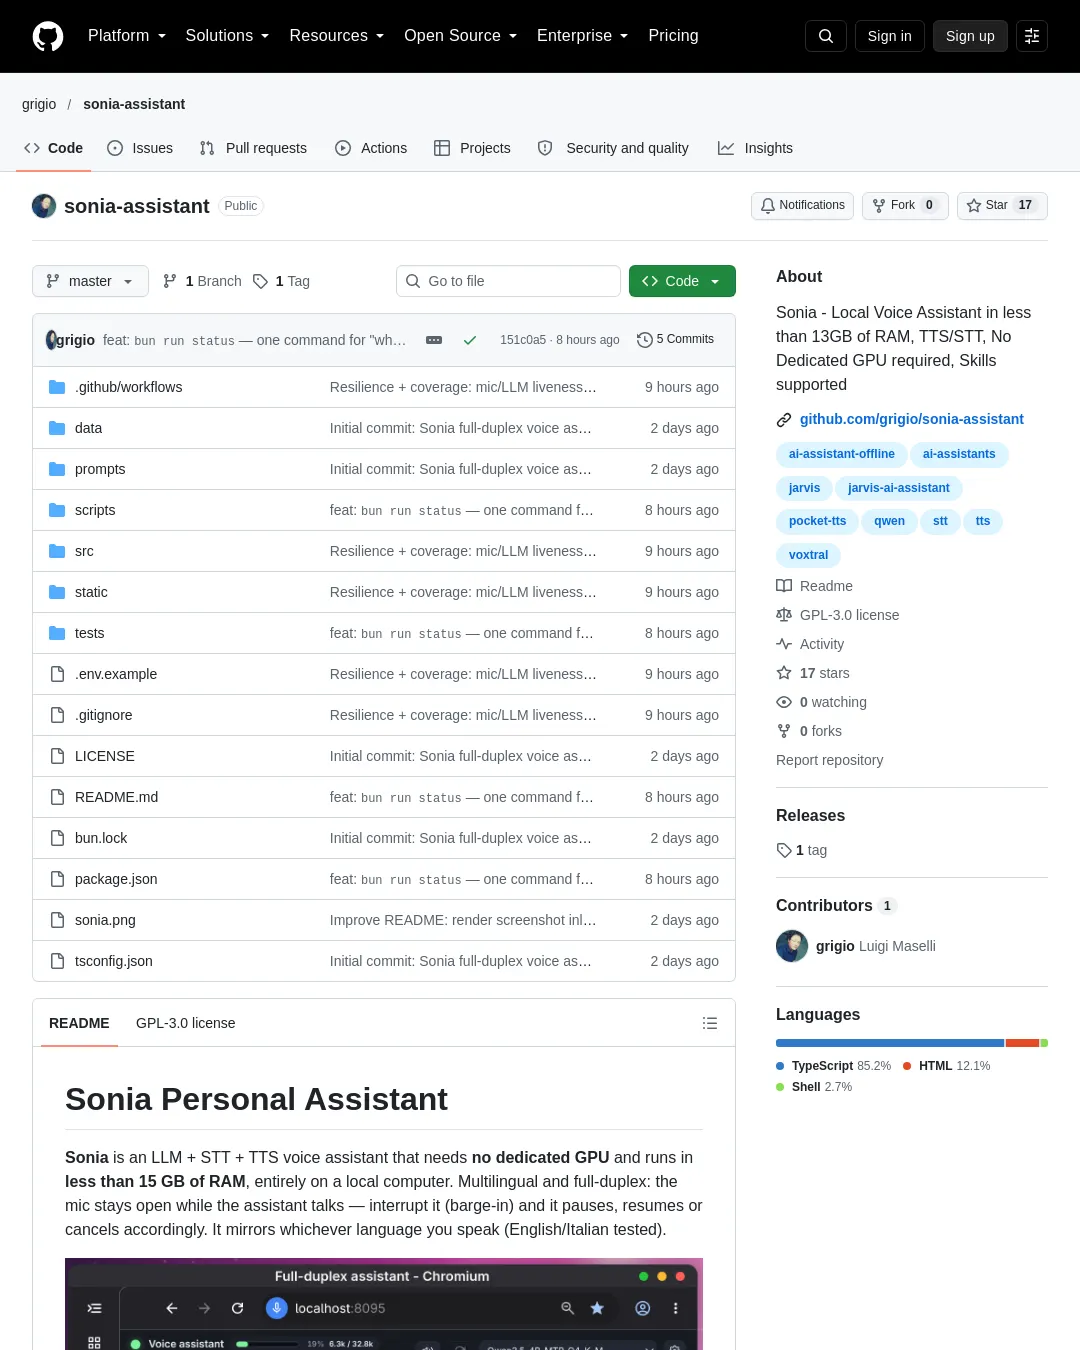
Sonia는 전용 GPU 없이 로컬 컴퓨터에서 실행되는 음성 비서다. 마이크를 계속 열어 둔 채 사용자가 말하면 음성을 끊고 대답을 멈추거나 다시 이어가며, 15GB 미만의 RAM을 사용한다고 프로젝트는 설명한다.
음성 인식(STT), 대규모 언어 모델(LLM), 음성 합성(TTS)을 결합한 프로젝트다. 영어와 이탈리아어를 시험했으며, 사용자가 말한 언어에 맞춰 답한다. 모든 기능은 로컬에서 실행된다. 다만 기본 구성에서는 별도로 실행 중인 OpenAI 호환 엔드포인트가 필요하다. 이 엔드포인트는 로컬에서 실행할 수 있지만, Sonia가 관리하지 않는 런타임 의존성인 llama-server다. 실험적 선택 사항으로, 엔드포인트 대신 기존 pi 실행 파일을 사용할 수도 있다.
주요 기능과 사용 방식
Sonia는 음성 대화 중에도 마이크를 닫지 않는다. 사용자는 답변 도중 끼어들 수 있다. 음성이 겹치거나 짧은 맞장구가 들리면 답변을 재개하고, 실제 발화가 3단어 이상이면 진행 중인 답변을 취소하며 이미 말한 부분을 대화 기록에 남긴다. 발화 중에는 스트리밍 음성 인식 결과가 부분 텍스트로 표시된다.
발화가 끝났는지는 Silero VAD, 무음 구간, Smart Turn 분류기를 함께 사용해 판단한다. 일시 정지가 모호할 때는 4토큰짜리 LISTEN/REPLY 프롬프트를 LLM에 보내 판단한다. 다국어 기능은 영어와 이탈리아어를 지원한다. 모델은 매 대화 차례마다 사용자의 언어를 따라가며, LOCALE=it|en 설정은 UI, 음성 응답, 도구 결과의 언어를 지정한다. 타이머 알림과 취소 칩은 UI 언어가 아니라 타이머를 설정한 요청의 언어를 사용한다.
도구 기능에는 get_datetime, set_timer, start_watch/stop_watch, 메모 추가·목록·삭제·전체 삭제, list_skills, read_skill, run_command가 포함된다. 한 차례의 대화에서 도구를 최대 6번 호출할 수 있다. 도구 게이트는 저렴한 판정 모델로 각 도구 호출 제안을 사용자의 실제 발화와 대조한다. 프로젝트는 이 기능이 4B 모델이 모호한 후속 발화만으로 불필요한 도구를 실행하는 일을 막도록 설계됐다고 설명한다.
셸 명령은 CMD_MODE=off|ask|auto로 제어한다. 위험한 명령은 음성 또는 클릭으로 승인해야 실행되며, 안전한 명령과 스킬 디렉터리의 명령은 자동으로 실행된다. 스킬은 프로젝트가 제공하거나 소유하지 않는다. SKILLS_DIR을 기존 SKILL.md 패키지 디렉터리로 지정하고, UI 설정에서 대화 차례마다 사용할 스킬을 활성화한다. 이 경로는 pi 코딩 에이전트나 opencode가 사용하는 디렉터리, 또는 다른 에이전트 도구의 디렉터리일 수 있다.
기본 LLM 연결은 OpenAI 호환 엔드포인트다. 실험적 선택 사항으로 기존 pi 실행 파일을 대신 사용할 수 있으며, LLM_VIA_PI=1로 설정하거나 실행 중 체크박스로 전환한다. 이 모드에서는 하네스 도구를 사용할 수 없다. 브라우저 앱 창 UI 외에도 --cli와 --text 터미널 모드를 제공한다.
채팅 상단 배너에는 아직 울리지 않은 타이머, 실행 중인 명령, 확인 중인 감시 작업이 각각 남은 시간과 함께 표시된다. 각 항목의 ✕는 다른 작업에 영향을 주지 않고 해당 타이머의 알림을 끄거나, 셸 프로세스 그룹을 종료하거나, 감시를 멈춘다. start_watch는 읽기 전용 명령을 5초 이상의 간격으로 반복 실행한다. match 조건을 지정하면 출력에 해당 텍스트가 나타날 때까지 알리지 않다가 한 번 알린다. 예를 들어 다운로드가 끝났을 때 알려 달라고 요청할 수 있다. 조건을 지정하지 않으면 배터리 상태처럼 확인할 값을 매번 보고한다. 감시는 해당 항목의 ✕ 또는 stop_watch로 중단한다. 전체 대화를 지우는 🧹 동작은 타이머처럼 감시 작업을 중단하지 않는다.
각 대화 줄에는 마우스를 올렸을 때 체크포인트로 되돌리는 ⟲ 버튼이 나타난다. 선택한 줄과 그 이전 내용은 유지하고, 그 뒤의 대화와 모델 기록에서 차지하던 문맥은 제거한다. 선택한 줄 자체는 답하지 않은 질문이라도 삭제되지 않는다. 대화 기록에는 해당 줄의 체크포인트가 유지되며, 엄격한 교대 형식을 요구하는 템플릿에 맞추기 위해 모델에 보낼 때만 다음 질문을 그 줄에 이어 붙인다. 제거한 대화 줄에 도구 결과가 딸려 있으면 해당 호출과 답변은 함께 유지된다. 더는 존재하지 않는 체크포인트를 선택하면 잘못된 위치에서 자르는 대신 요청을 거부하고 알린다. ⟲를 사용해도 대기 중인 타이머와 감시는 유지된다.
재시작 후에도 대화 기록, 모델 자체의 기록, 각 줄의 체크포인트 ID가 data/chat.json에 저장돼 이어진다. 🧹와 ⟲로 바꾼 내용도 파일에 반영된다. 이전처럼 시작할 때마다 빈 대화로 열려면 CHAT_PERSIST=0을 설정한다.
구성과 모델
TypeScript 허브 프로세스 하나가 32ms 프레임 루프, 큐, 상태 머신을 관리하며 네 모델이 연결된다. 음성 스택은 audio.cpp 서버 세 개로 구성된다. LLM은 외부 llama-server를 사용하고 VAD는 프로세스 안에서 실행된다.
mic (32 ms frames) │ ├─► Silero VAD (in-process, ONNX) [src/vad.ts] ▼ audio.cpp :8091 streaming ASR ── partial + final transcript ▼ HARNESS src/harness/harness.ts — turn-end decision: │ pause ≥200ms → Smart Turn (:8093) ≥0.5 ⇒ end · pause ≥900ms + "not finished" │ → 4-token LLM prompt LISTEN/REPLY (prompts/decision.txt) ▼ LLM leg (src/clients/llm.ts / pi.ts — one interface, two backends) │ A) llama-server :8080 (OpenAI API) B) `pi -c` CLI (experimental, optional) │ + tools: get_datetime, set_timer, start_watch/stop_watch, notes, skills, run_command │ + tool gate (prompts/tool-gate.txt) filters each round ▼ streamed text → SentenceSplitter → sentences ▼ audio.cpp :8092 TTS ── SSE PCM16 → paced Player (20 ms slices) ▲ barge-in: pause / resume / flush within ~one buffer
| 포트 | 서비스 | 실행 방법 |
|---|---|---|
:8080 | OpenAI 호환 LLM llama-server(외부) | systemctl --user start llama-server로 직접 실행 |
:8091 | audio.cpp ASR(Vulkan, iGPU) | scripts/start-audio-servers.sh start |
:8092 | audio.cpp TTS(CPU) | 위와 동일 |
:8093 | audio.cpp Smart Turn(CPU) | 위와 동일 |
:8095 | 하네스 웹 UI: GET /, GET /ws(JSON 이벤트와 양방향 바이너리 PCM) | bun run start(scripts/run.ts) |
코드는 Bun과 TypeScript로 작성됐으며 src/에 약 6.5k LOC가 있다.
| 영역 | 파일과 구성 |
|---|---|
| 진입점 | cli.ts(--web/--cli/--text/오프라인 WAV), web.ts(node:http 및 ws), config.ts(모든 설정은 환경 변수), i18n.ts |
| 이벤트 루프 | harness/harness.ts(프레임 루프, 끼어들기, 취소), harness/assistant.ts(상태, 기록, 시스템 프롬프트, 상태 확인), harness/{turn,barge-in,sentences,queues,text}.ts |
| 모델 클라이언트 | clients/audiocpp.ts(양방향 raw-socket ASR, SSE TTS, Smart Turn), clients/llm.ts / pi.ts / sse.ts / think.ts |
| 기능 | tools.ts와 command-policy.ts, shell-runner.ts, skills.ts, vad.ts |
| 오디오와 UI | audio/{mic,player,wav}.ts, 단일 파일 바닐라 UI인 static/index.html(현지화 지원) |
| 프롬프트 | prompts/system.txt(페르소나), prompts/decision.txt(대화 차례 판정), prompts/tool-gate.txt |
진입점 연결 코드는 scripts/run.ts와 scripts/stop.ts에 있다. Bun을 사용하며 이전의 run.sh/stop.sh를 대체한다. 셸 연결 스크립트는 scripts/start-audio-servers.sh다. 의존성은 onnxruntime-node와 ws다.
| 모델 | 역할 | 실행 위치와 장치 | 크기 |
|---|---|---|---|
Qwen3.5-4B-MTP(Q4_K_M) | 답변, 도구, 대화 차례 판정, 도구 게이트를 담당하는 주 LLM | 외부 llama-server :8080, Vulkan | 2.7 GiB(이 저장소에서 내려받지 않음) |
Voxtral Mini 4B Realtime 2602(q4_k) | 스트리밍 ASR | audio.cpp :8091, Vulkan(B390 iGPU) | 2.9 GB |
Pocket TTS(bf16, 언어 팩 5종, 음성 26개) | 스트리밍 TTS | audio.cpp :8092, CPU | 팩당 약 209 MiB |
Smart Turn v3.2(f32) | 대화 차례 종료 분류기 | audio.cpp :8093, CPU | 31 MB |
Silero VAD v5(onnx) | 음성 활동 감지 | 프로세스 내, CPU | 2.3 MB |
실험적·선택 사항: pi --list-models에 나오는 임의의 ID | 대체 LLM 연결(LLM_VIA_PI=1); OpenAI 호환 엔드포인트 대신 이미 설치된 pi 실행 파일을 호출 | pi CLI 하위 프로세스 | — |
음성 모델은 bun run models-download로 models/에 내려받는다. 전체 용량은 약 3.3 GiB이며, 중단 후 재개할 수 있고 반복 실행도 가능하다. 모델은 audio.cpp GGUF 미러에서 받는다. LLM .gguf 파일은 이 저장소에서 내려받지 않으며 외부 llama-server가 담당한다.
전용 GPU는 필수가 아니다. ASR은 사용 가능한 Vulkan 장치에서 실행되며 iGPU도 사용할 수 있고, ASR_BACKEND=cpu로 CPU를 지정할 수도 있다. TTS, Smart Turn, VAD는 CPU 전용이고 LLM은 4비트 양자화 모델이다. 프로젝트는 전체 작업 메모리가 15GB 미만이라고 설명한다.
설치와 실행
필요한 항목은 Bun 1.x 이상(런타임과 테스트, 빌드 단계 없음), :8080에서 응답하는 외부 llama-server(저장소가 실행하지 않으며 /health에 응답해야 함), vendor/audio.cpp를 한 번 빌드하기 위한 cmake·Ninja·Vulkan SDK다. Vulkan 장치가 없다면 -DENGINE_ENABLE_VULKAN=OFF로 빌드하고 ASR_BACKEND=cpu를 설정한다. 브라우저 UI에는 PATH에 Chromium이 필요하지만, 선택 사항인 --no-browser를 쓰고 다른 브라우저를 이용할 수 있다. --cli 모드에서 마이크와 스피커를 쓰려면 PipeWire가 필요하며, 브라우저 모드는 탭의 오디오를 사용한다.
# 1. 의존성
bun install

# 2. 설정
cp .env.example .env # git-ignored; keys mirror src/config.ts fields
# …set SKILLS_DIR to the skills folder you already use (see "Skills" below)
# …set LLM_BASE_URL / LLM_MODEL, or LLM_VIA_PI=1 to use an existing `pi` executable

# 3. 최신 audio.cpp 릴리스를 내려받아 컴파일(한 단계)
bun run fetch-and-compile-audio.cpp # vendor/audio.cpp is git-ignored; re-runs are incremental
# …same by hand:
# git clone --depth 1 --branch <tag> https://github.com/0xShug0/audio.cpp vendor/audio.cpp
# cmake -S vendor/audio.cpp -B vendor/audio.cpp/build -G Ninja \
# -DCMAKE_BUILD_TYPE=Release -DENGINE_ENABLE_VULKAN=ON
# cmake --build vendor/audio.cpp/build --target audiocpp_server
# …or point AUDIOCPP_SERVER=/path/to/audiocpp_server at an existing binary

# 4. 음성 모델 다운로드(약 3.3 GiB, 재개 가능)
bun run models-download
bun run models-download --check # verify only: ✓/✗ per file, exit 1 if missing

# 5. LLM 시작(외부, 사용자가 직접 설정한 유닛/설정)
systemctl --user start llama-server

# 6. 모든 서비스 응답 확인
bun run runtime-check
audio.cpp의 공식 사전 빌드 바이너리 대신 직접 컴파일하는 이유는 upstream의 0xShug0/audio.cpp가 릴리스마다 Ubuntu/macOS/Windows 바이너리를 제공하지만, 이 바이너리는 AVX-512 CI 러너에서 ENGINE_ENABLE_NATIVE_CPU=ON(즉, -march=native)으로 빌드되기 때문이다. 그 결과 ggml_cpu_init 자체에 AVX-512 명령이 포함된다. AVX-512가 없는 CPU(모든 Intel 12세대+)에서는 Vulkan 초기화 직후 SIGILL로 프로세스가 종료된다. CPU 백엔드도 항상 등록되므로 backend: vulkan과 backend: cpu 모두 영향을 받는다.
저장소는 릴리스 v0.9.1에서 이를 확인했다고 밝힌다. gdb에서 ggml_cpu_init+607: vpbroadcastd %edx,%ymm17을 확인했으며, 이는 AVX-512VL 명령이다. 로컬 빌드는 -march=native가 일반 AVX2/AVX-VNNI를 뜻하므로 작동한다고 설명한다. Mesa나 드라이버 문제는 아니라는 근거도 제시한다. 어느 바이너리에도 드라이버는 포함되지 않고 호스트의 ICD를 사용하는 libvulkan.so.1만 링크하며, 공식 바이너리도 충돌 전에는 iGPU를 제대로 열거했다는 것이다.
upstream이 기준 ISA 바이너리(예: GGML_NATIVE=OFF 또는 -DENGINE_ENABLE_CPU_ALL_VARIANTS=ON)를 배포하면 이 문제를 다시 검토할 예정이다. 그때는 AUDIOCPP_SERVER=에 내려받은 릴리스 경로를 지정해 vendor/audio.cpp 복제본(1.2 GB)을 없앨 수 있다고 설명한다.
실행 명령은 다음과 같다.
bun run start # scripts/run.ts — prints the audio.cpp version, then starts the three
# audio servers + the harness → ✅ ready → http://127.0.0.1:8095/ (browser UI)
bun run stop # scripts/stop.ts --audio — harness + its window + the audio servers
bun run start --no-browser # same as start, print the URL only
bun run start --cli # terminal through PipeWire mic/speaker
bun run start --text # typed input
bun run scripts/stop.ts # …only the harness + its Chromium window
bun run stop --all # …plus llama-server (the systemd unit)
bun run stop --status # what is running right now
run.ts는 llama-server를 확인한 다음 세 audio.cpp 서버를 시작하고 /health 응답을 기다리며 실행 중인 audio.cpp 버전을 출력한다. 이어 하네스(src/cli.ts)를 실행한다. 하네스 PID는 data/run/harness.pid에 저장된다. 준비 완료를 알리기 전에 LLM, TTS 속도, ASR Vulkan 그래프를 예열하므로 모델을 처음 불러올 때는 몇 분이 걸릴 수 있다.
비공개 정보 또는 다시 생성할 수 있는 파일은 Git에서 제외되는 data/에 저장한다. data/run/에는 PID 파일, 서버 설정, 브라우저 프로필이 있고, 로그는 data/logs/*.log에 있다. 메모, 스킬, 음성 선택, 대화 기록(chat.json, 기능 14 참조), pi/ 대화도 이곳에 저장된다.
개발용 명령과 테스트 조건은 다음과 같다.
bun run test # 301 tests (pretest = tsc --noEmit, strict)
bun run typecheck
bun run runtime-check # are llama-server + ASR + TTS + turn + harness up?
scripts/ui-test.sh # browser-UI suite (headless Chromium)
bun run stop --status # what is running right now
CI(.github/workflows/ci.yml)는 타입 검사와 bun test tests/unit을 실행한다. 이 테스트 묶음은 음성 모델이나 실행 중인 llama-server가 필요 없는 환경에서 돌아간다. 모델이 필요한 WebSocket 테스트는 저장소 변수 WITH_MODELS=true로 활성화하는 별도 작업이다.
전체 환경 변수 설정은 .env.example에 있고 기본값은 src/config.ts에 있다. UI의 ⚙ 설정 창에서 일부 값을 실행 중 바꿀 수 있다.
스킬과 보안
스킬은 지침과 scripts/를 담은 일반 SKILL.md 패키지이며, 단일 디렉터리에서 읽는다. Sonia는 스킬을 제공하거나 소유하지 않는다. .env의 SKILLS_DIR을 다른 도구에서 이미 사용하는 폴더로 지정한다.
| 도구 | 스킬 경로 |
|---|---|
pi 코딩 에이전트 | 기본값은 ~/.pi/agent/skills |
| opencode | opencode의 스킬/플러그인 디렉터리 |
| 다른 에이전트 도구 | <name>/SKILL.md가 있는 임의의 디렉터리 |
활성 스킬은 .env가 아니라 UI 설정 창에서 세션별로 고르며, 선택 내용은 data/skills.json에 저장된다. 비활성 스킬은 프롬프트에 포함되지 않으며 read_skill로도 읽을 수 없다.
기본적으로 모든 기능은 localhost에만 열리고 로그인이나 TLS를 제공하지 않는다. 자체 보호 장치 없이 루프백이 아닌 주소에 --host를 지정하지 말아야 한다. run_command는 샌드박스 없이 현재 사용자 권한으로 bash -c를 실행한다. src/command-policy.ts의 정책은 읽기 전용 명령을 안전한 것으로 분류한다. 셸 메타문자와 .ssh, 키, .env 같은 민감한 경로는 CMD_MODE=ask에서 항상 승인 요청을 멈춘다.
앱의 제어 채널인 /ws WebSocket은 서버 자체의 출처에서 온 연결만 허용한다. 이 출처 검사는 src/web.ts의 originAllowed에서 이뤄진다. 브라우저는 WebSocket에 같은 출처 정책을 적용하지 않기 때문에, 검사가 없다면 방문한 웹페이지가 ws://127.0.0.1:8095/ws에 연결해 대화 기록을 읽고 명령을 보낼 수 있다. 다른 곳에서 제공된 페이지는 연결 업그레이드 단계에서 거부되며 ⛔ ws refused로 기록된다. 같은 앱을 두 번째 창에서 열면 단일 클라이언트 자리를 넘겨받고, 첫 번째 창에는 session_taken 이벤트를 보내 입력이 조용히 무시되는 상태로 남지 않게 한다.
외부 스킬의 검증은 이 프로젝트의 범위 밖이며 사용자가 책임져야 한다. SKILLS_DIR로 지정한 외부 디렉터리의 스킬은 신뢰된 것으로 간주한다. 그 안의 명령은 허용 목록과 승인 절차를 모두 건너뛰고 현재 사용자 권한으로 자동 실행된다. 스킬을 활성화하기 전에 SKILL.md가 모델에 무엇을 하도록 지시하는지, 어떤 CLI 명령을 어떤 보조 스크립트로 호출하는지 확인해야 한다. Sonia는 해당 지시를 전달할 뿐이다. 검토하지 않은 스킬은 검토하지 않은 셸 스크립트와 똑같이 취급하고, 새 스킬을 시험할 때는 CMD_MODE=ask를 사용하는 편이 좋다고 프로젝트는 안내한다.
라이선스와 구성 요소
Sonia는 GNU General Public License v3.0(GPL-3.0-only)으로 배포된다. 저작권 표시는 2025년 fullduplex-assistant authors 명의다. 재배포와 수정은 자유 소프트웨어 재단이 발표한 GPLv3 조건을 따른다.
| 구성 요소 | 위치 | 라이선스 |
|---|---|---|
audio.cpp(ASR/TTS/차례 판정/VAD 서버) | scripts/fetch-and-compile-audio-cpp.ts가 vendor/에 내려받음 | Apache-2.0 |
llama-server(주 LLM 연결) | 외부, 사용자가 직접 실행 | MIT |
onnxruntime-node, ws(런타임 의존성) | package.json을 통해 node_modules/에 설치 | MIT |
typescript, @types/*, 전이 의존성(개발용) | node_modules/ | TypeScript는 Apache-2.0, 그 밖에는 MIT, ISC, BSD-3-Clause, CC0-1.0 |
| Voxtral Mini 4B Realtime 2602(ASR) | bun run models-download로 models/에 저장 | Apache-2.0(Mistral AI) |
| Pocket TTS(TTS, 음성 팩) | models/ | MIT(kyutai-labs/pocket-tts) |
| Smart Turn v3.2(차례 분류기) | models/ | BSD-2-Clause(pipecat-ai) |
| Silero VAD v5(음성 활동 감지) | models/ | MIT(snakers4/silero-vad) |
Qwen3.5-4B-MTP(주 LLM .gguf) | 이 저장소에서 내려받지 않으며 외부 llama-server가 사용 | 모델 카드 참조 |
pi CLI(LLM_VIA_PI=1 모드) | 외부 실행 파일 | pi 프로젝트 참조 |
SKILLS_DIR로 지정한 스킬 | 저장소 외부 | 각 스킬의 조건 적용 |
위 모델 라이선스는 upstream의 조건이다. models/ 아래의 .gguf 파일은 해당 모델을 미러링해 재배포한 것이므로, 재배포 전 모델 카드와 미러 양쪽의 조건을 확인해야 한다. 설치된 모든 npm 패키지의 SPDX 라이선스를 로컬에서 확인하는 명령은 다음과 같다.
find node_modules -maxdepth 3 -name package.json -not -path '*/node_modules/*/node_modules/*' \
 -exec node -e 'const p=require(require("path").resolve(process.argv[1]));console.log((p.license||"?").padEnd(18),p.name+"@"+p.version)' {} \; | sort -u
의존성 라이선스가 사용 목적에 맞지 않으면 검토하거나 교체할 대상은 이 프로젝트가 아니라 해당 구성 요소라고 저장소는 설명한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요