전문성 수준: 지침.
지난 글에서 밝혔듯이, 이 글의 실험자는 모델 개발 전문가가 아니며 설명 일부가 부정확할 수 있다고 전제한다. 부족한 전문성을 보완하려고 주의 깊게 정량화하려 했다고 덧붙였다.
strands-decider-2B를 출시한 뒤, 왜 인코더(encoder)가 아니라 수정된 LLM을 사용했느냐는 질문이 나왔다. 인코더는 각 토큰의 표현을 앞뒤 토큰을 모두 이용해 만들지만, 인과적(causal) 구조는 앞에 나온 토큰만 이용한다. 이런 양방향 처리가 분류 작업에서 인코더가 널리 쓰이는 이유이기도 하다. 실험자는 이 질문이 타당하다며, strands-decider가 디코더를 인코더처럼 활용하는 셈이라고 설명했다.
비교한 모델과 결과
실험에서는 다섯 가지 설계를 비교했다.
- v19는 Qwen3.5를 기반으로 한 strands-decider의 최종 설계다. 자세한 내용은 이전 글과 strands-decider README에 소개돼 있다.
- b1은 원래 Transformer와 같은 인코더-디코더 구조다. T5Gemma 2를 기반으로 인코더와 디코더 매개변수가 각각 1B이며, LM head를 빼고 포인터 head를 더했다. b2는 b1과 같지만 인코더와 디코더가 각각 4B+다.
- e1a는 T5Gemma 2가 아닌 T5Gemma의 인코더 부분만 사용한 2.6B 모델이다. e1b는 e1a를 지연 시간에 맞게 최적화한 모델로, 마스킹된 상태 캐시를 사용한다. 덕분에 여러 질문을 서로 간섭 없이 병렬로 평가하고 상태 캐시를 재사용할 수 있다.
state는 전체state에 양방향으로 주의를 기울이고, 각 질문은state와 자기 자신에 주의를 기울인다.1
실험자는 ModernBERT와 ettin-encoder-1b도 고정된 상태로 측정했다. 두 모델은 매개변수 수를 고려했을 때 T5Gemma보다 성능이 낮아 추가 학습은 진행하지 않았다.
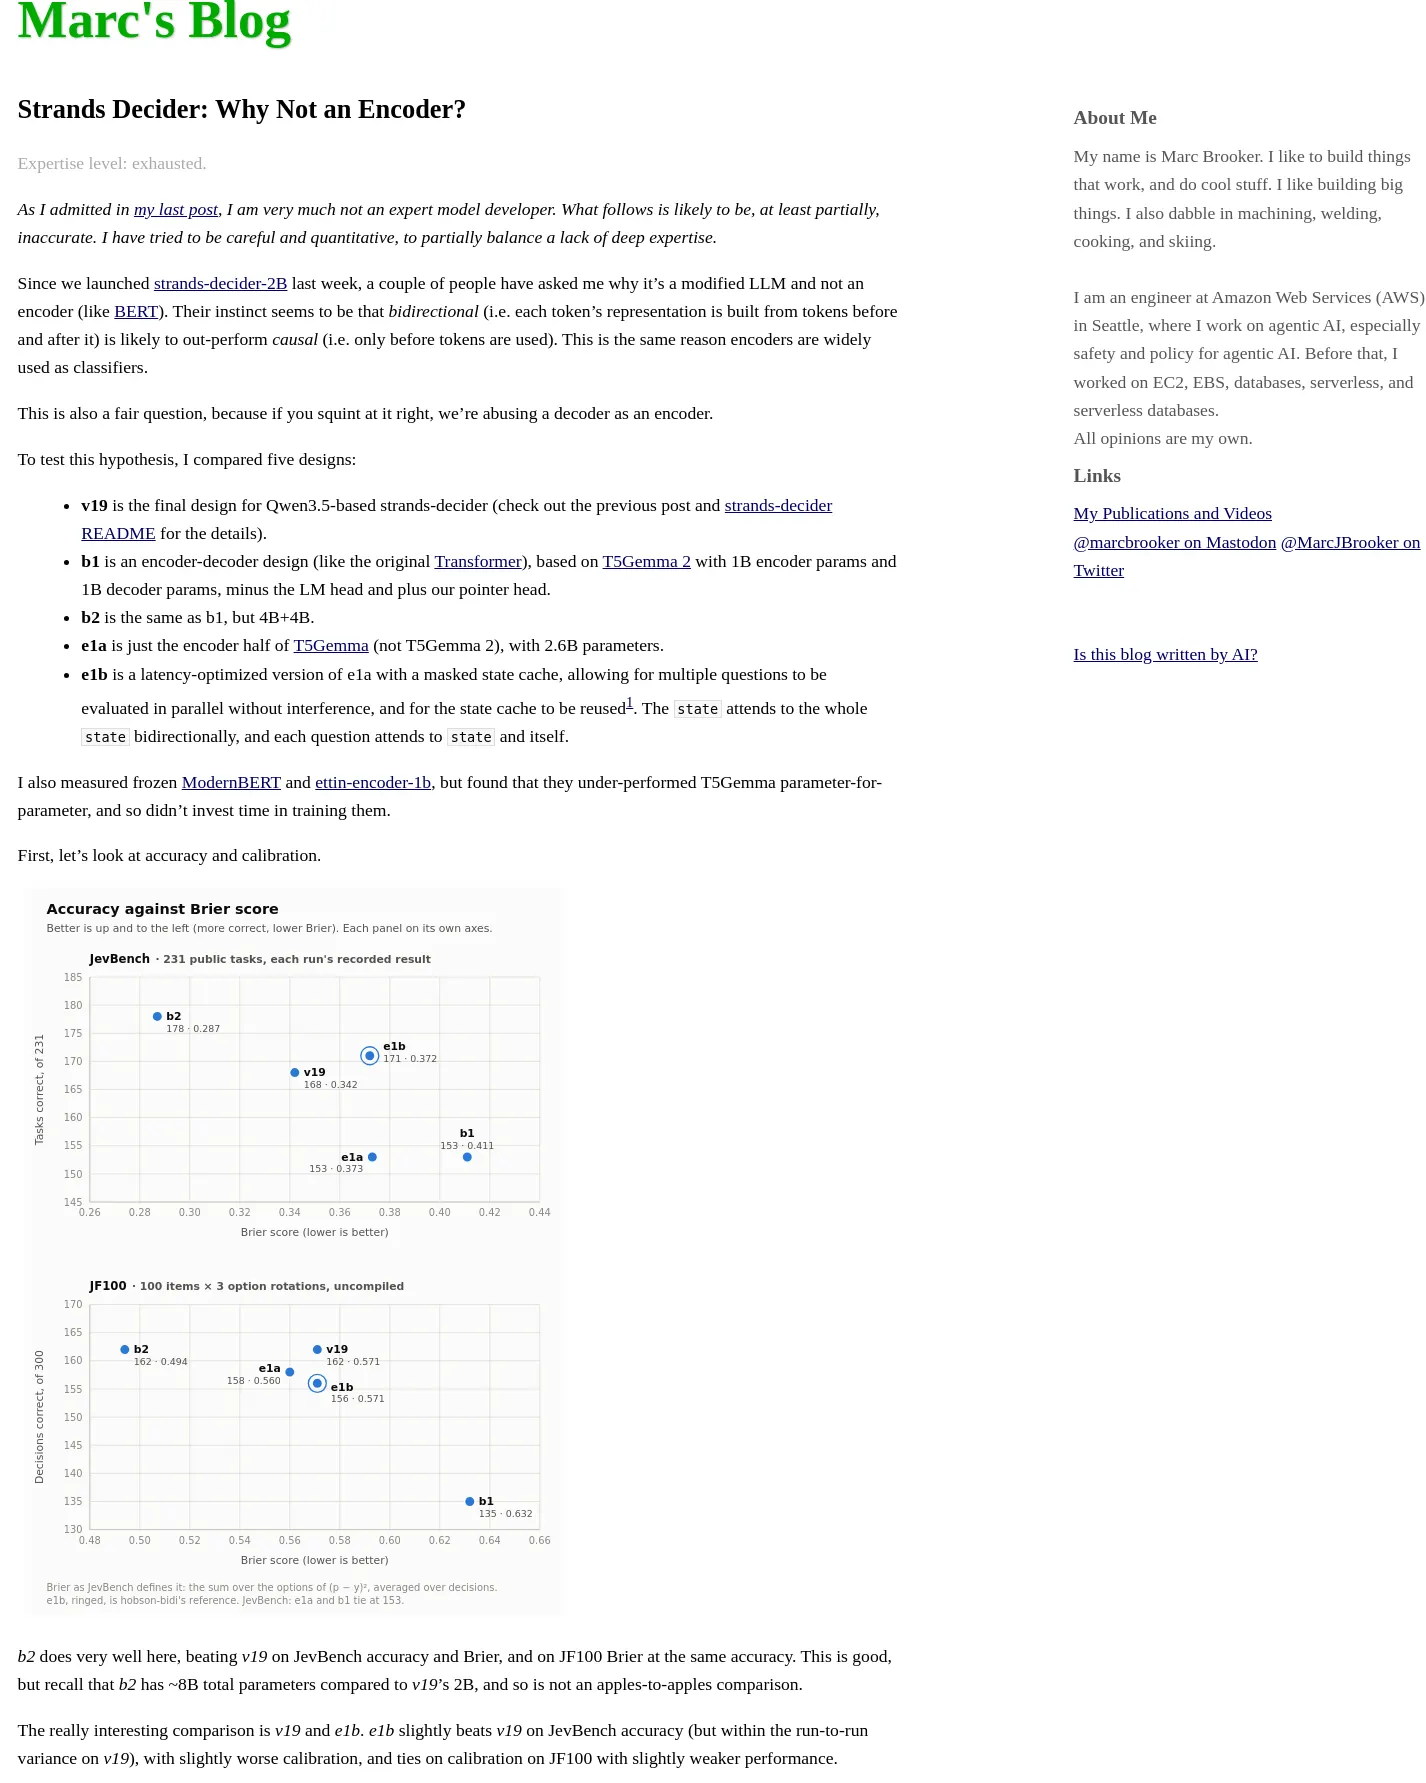
정확도와 보정(calibration)에서는 b2가 JevBench 정확도와 Brier 점수에서 v19를 앞섰고, JF100에서는 정확도가 같은 수준이면서 Brier 점수가 더 좋았다. 다만 b2는 전체 매개변수가 약 8B로 v19의 2B보다 훨씬 많아 직접 비교하기 어렵다.
e1b와 v19의 비교가 더 의미 있다. e1b는 JevBench 정확도에서 v19를 조금 앞섰지만, 그 차이는 v19의 실행 간 변동 범위 안에 있었다. 보정은 약간 나빴다. JF100에서는 보정이 같았고 성능은 조금 낮았다.
지연 시간과 입력 길이
인코더 전용 모델은 지연 시간에서 뚜렷한 우위를 보였다. 중앙값은 약 35ms로 v19의 65ms보다 짧았다. 인코더-디코더 모델은 가장 느렸다. 성능이 비슷하면서 지연 시간이 절반인 e1b가 유리해 보이지만, 입력 길이에 따라 결과가 달라졌다.
e1b는 프롬프트가 짧을 때 크게 앞섰지만, 프롬프트가 길어질수록 지연 시간이 더 빠르게 증가했다. 이는 중앙값이 좋은 결과와도 일치한다. 이 차이가 중요한지는 실제 작업에서 짧은 프롬프트와 긴 프롬프트가 얼마나 섞이는지에 달려 있다. JF100과 JevBench는 모두 짧은 입력이 많은 편이라 e1b에 유리하다.
이런 차이는 두 모델의 연산 비용에서 비롯된다. e1b에는 전체 주의를 사용하는 층이 26개 있어 연산량이 입력 길이의 제곱에 비례한다. 반면 v19는 층의 75%가 선형 연산량을 갖는 Gated DeltaNet을 사용한다. 이 층은 고정 비용이 더 높지만 입력이 길어질 때 연산 비용이 더 유리해, 지연 시간의 바닥값은 더 높다.2
e1a와 일반화
e1a는 평가 세트 9개 중 7개에서 v19를 앞섰고, 나머지 2개에서는 근소하게 뒤졌다. 하지만 JevBench에서는 153점으로 v19의 168점보다 낮았고, JF100에서도 158점으로 v19의 162점보다 약간 낮았다. 실험자는 e1b처럼 마스킹을 적용하지 않으면 인코더의 일반화 성능이 더 낮을 가능성을 제기했다. 상태를 처리할 때 질문을 함께 참조하는 것이 오히려 약점인지도 질문으로 남겼다.
| 평가 세트 | v19 | e1a | Δ |
|---|---|---|---|
| 제외된 짧은 작업 | 0.647 | 0.695 | +0.048 |
| MuSiQue | 0.882 | 0.948 | +0.066 |
| ContractNLI | 0.873 | 0.864 | −0.009 |
| BoardgameQA | 0.820 | 0.884 | +0.064 |
| HotpotQA (제외 데이터) | 0.719 | 0.748 | +0.029 |
| 생성 데이터, v16 | 0.857 | 0.851 | −0.006 |
| 생성 데이터, v18 | 0.777 | 0.786 | +0.009 |
| 적절성, HelpSteer2 | 0.722 | 0.761 | +0.039 |
| 적절성, 생성·균형 데이터 | 0.788 | 0.821 | +0.033 |
이번 실험만으로 인코더와 디코더 중 어느 쪽이 더 낫다고 결론 내리기는 어렵다. 아키텍처와 기반 모델, 지시 튜닝 여부 등 여러 변수가 함께 달라져 결과를 분리해 해석하기 어렵기 때문이다. 다만 이 규모의 작업에서 어느 한쪽이 확실한 승자라고 보기는 어렵다는 점은 확인했다.
실험 코드는 현재 별도 브랜치에 있다. 당장은 strands-decider의 기본 코드에 합칠 필요가 없어 보이지만, 추가 개발에 따라 달라질 수 있다.
각주:
- 디코더의 KV 캐시와 접두부 캐시도 같은 이유로 비슷한 방식을 쓴다. 증분 계산 결과를 저장하는 방식이 성능에 도움이 된 것은 이번이 처음이 아니다. KV cache
- 작은 데이터에서는 O(N²) 알고리즘이 O(N) 알고리즘보다 빠른 경우가 이번이 처음은 아니다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요