TL;DR
- 3D 액션 게임의 NPC가 대형 언어 모델(LLM) 기반 이벤트 구동 시스템으로 자극에 반응하며, 대부분의 추론을 2초 미만에 마침.
- NPC의 지각 시스템은 게임 틱마다 관측 데이터를 모으고, 휴리스틱으로 흥미로운 변화를 감지해 추론을 시작함.
- 매 추론 턴마다 새로 구성되는 프롬프트는 YAML로 작성되며, 최근에 알아챈 개체와 요약된 이벤트 기록을 담음.
- NPC는 자극에 대한 단기 계획으로 보통 3~5개 행동을 생성하고, 계획을 스트리밍해 응답이 완성되기 전부터 행동을 시작함.
- 장기 상호작용에서 세부 정보가 사라지는 메모리 문제와 감지할 수 있는 자극 및 수행 가능한 행동의 제한이 남은 과제임.
실시간을 향한 탐구
- 지능형 NPC를 만들려는 목표는 캐릭터가 실제처럼 반응하는 시뮬레이션 세계인 *Star Trek*의 홀로덱에 가까움.
- 역장 홀로그램이나 물질 복제는 당장 실현되지 않더라도, 스스로 생각하는 캐릭터와 실시간으로 상호작용하는 것이 목표임.
지능
- 현재 기술의 제약 안에서 사려 깊고 비결정적인 행동을 구현하기 위해 NPC의 두뇌로 대형 언어 모델(LLM)을 선택함. LLM은 문맥을 인식하는 난수 생성기와 본질적으로 비슷함.
- 타당한 응답에는 문맥이 중요하며, 원시 게임 상태를 텍스트로 변환하고 긴 플레이 시간 동안 문맥의 초점을 유지하는 일이 과제임.
- 추론에 수 초가 걸릴 수 있다는 점은 실시간 게임에서 큰 제약임.
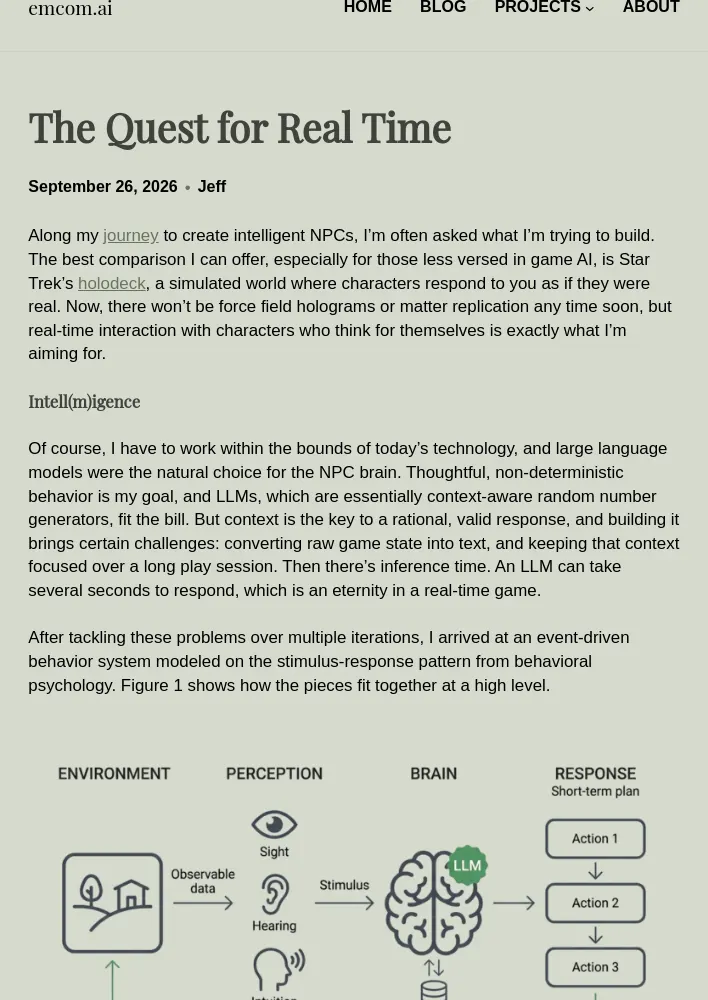
- 여러 차례 개선을 거쳐 행동 심리학의 자극-반응 패턴을 모델로 한 이벤트 구동 행동 시스템을 구성함.
자극적인 경험
- NPC가 행동할 이유는 자극 파이프라인에서 비롯됨. 여러 게임 틱에 걸쳐 관측 가능한 데이터를 모아 NPC의 지각 시스템에 전달하고, 휴리스틱으로 흥미로운 사건이 발생했는지 판단함.
- 흥미로운 변화가 감지되면 두뇌에 신호를 보내 사고 턴을 시작함. 자극은 NPC가 알고 있는 다른 정보와 함께 고려하는 최신 상황이 됨.
- 자극은 다른 캐릭터를 처음 발견하는 것처럼 단순할 수 있음.
- 직관은 NPC가 보고 듣는 것을 분석해 얻는 나머지 신호를 포괄함. 예를 들어 누군가 빠르게 달려 지나가는 상황은 위치와 속도만으로 포착할 수 있음.
두뇌
- 신호를 받으면 LLM 기반 두뇌가 추론을 수행해 단기 계획을 만듦.
- 프롬프트 구조는 일반적인 인지 아키텍처를 느슨하게 따름. 캐릭터가 세계에 들어올 때부터 알고 있는 정보를 담는 장기 기억과, 현재 세션의 원시 게임 상태 및 이벤트로 구성되는 작업 기억을 함께 사용함.
- 개체 속성과 이벤트를 포함해 모델이 접하는 모든 정보는 엔진 데이터에서 간결하고 평이한 텍스트로 변환됨.
- 매 턴 프롬프트를 단일 메시지로 처음부터 다시 구성하므로, 다시 넣지 않은 정보는 다음 턴으로 이어지지 않음.
- 실시간 성능을 좌우하는 첫 번째 요소는 응답 시간이며, 이를 위해 간결하고 읽기 쉬운 YAML로 프롬프트를 작성하고 NPC가 최근에 알아챈 개체만 포함함.
- 이벤트는 누적 로그에 쌓이고, 로그가 길어지면 항목을 요약으로 접어 최근에 발생한 내용만 남김. 이로써 NPC는 모든 세부 정보를 유지하지 않으면서도 과거의 흐름을 파악함.
응답 능력
- 사고 턴의 결과는 자극에 대한 NPC의 응답인 계획이며, 순서대로 수행할 몇 가지 행동으로 구성됨.
- 행동은 NPC가 다루는 가장 작은 행동 단위지만 발걸음이나 한 번의 휘두르기만큼 작지는 않음. 가까운 지형지물로 이동하거나 대사를 말하는 등 몇 초 분량의 의도에 가까움.
- 새 자극이 계획을 중단하지 않는 한 NPC는 계획을 끝까지 수행함. 실시간 세계에서는 중단이 자주 발생하므로 기존 계획의 남은 부분은 폐기되고 새 계획이 이어받음.
- 계획은 단기 목표만 다루며 보통 3~5개 행동을 넘지 않음. 덕분에 출력이 작고, 대부분의 추론은 2초 미만에 완료됨.
- 계획은 스트리밍 방식으로 전달되므로 응답 전체를 기다리지 않고 도착하는 행동부터 꺼내 씀. 나머지 계획이 작성되는 동안 NPC는 이미 움직이기 시작함.
- 짧은 계획과 빠른 실행 시작이 캐릭터가 반응하는 상태와 플레이어를 기다리게 하는 상태를 가르는 요소임. 행동은 다시 세계에 반영되어 주변에서 관찰 가능한 데이터가 되고, 순환이 다시 시작됨.
실제 동작 보기
- 영상은 실제 게임플레이를 보여줌. 로봇이 비밀 기지로 이어지는 구불구불한 길을 지키고, 플레이어가 그 길을 올라감.
- 영상에는 두 번의 사고 턴이 담김. 첫 자극은 로봇이 플레이어를 발견하는 것이며, 뒤이어 나온 계획은 플레이어가 달려 지나가면서 중단됨.
앞으로의 과제
- 아직 완성되지 않은 부분이 많으며, 가장 분명한 공백은 메모리임. 장기 기억은 캐릭터가 누구인지, 작업 기억은 지금 무슨 일이 일어나는지를 다루지만 그 사이의 기억은 없음.
- 누적 로그는 NPC가 현재 상황을 파악하게 하고 요약으로 접으면 크기를 줄일 수 있지만, 각 요약은 이전 요약을 바탕으로 만들어져 반복할수록 세부 정보가 희미해짐.
- 상호작용이 길어지면 세션 초반의 세부 정보가 조용히 사라질 수 있음. 세션에서 중요한 정보를 선별해 의도적으로 보존하는 방법이 필요함.
- NPC의 상호작용 범위는 감지할 수 있는 자극과 수행할 수 있는 행동이라는 두 집합으로 제한됨. 체크포인트를 빠르게 지나가는 상황을 감시하지 않으면 NPC는 이를 지각하지 못하며, 대응 행동이 없으면 그 행동을 할 수도 없음.
- 캐릭터가 할 수 있는 일은 두 집합의 조합으로 결정되며, 두 집합 모두 확장 여지가 있음. 다만 규모가 클수록 반드시 더 좋은 것은 아님.
- 음계에는 단 여덟 개의 음이 있지만 멜로디는 아직 고갈되지 않음. 작은 집합도 규모에서 예상되는 것보다 흥미로운 플레이를 만들어냈으며, 핵심은 그럴듯함을 위한 충분한 범위와 멜로디를 압도하지 않는 균형임.
- 실시간 제약이 이 탐구의 모든 결정을 좌우함. NPC가 스스로 생각하게 하는 것과 플레이어가 사고 과정을 알아차리지 못할 만큼 빠르게 생각하게 하는 것은 서로 다른 문제임.
- 홀로덱은 아직 먼 목표지만, 이번 시스템은 그 방향으로 나아가는 한 걸음임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요