TL;DR
- Supabase의
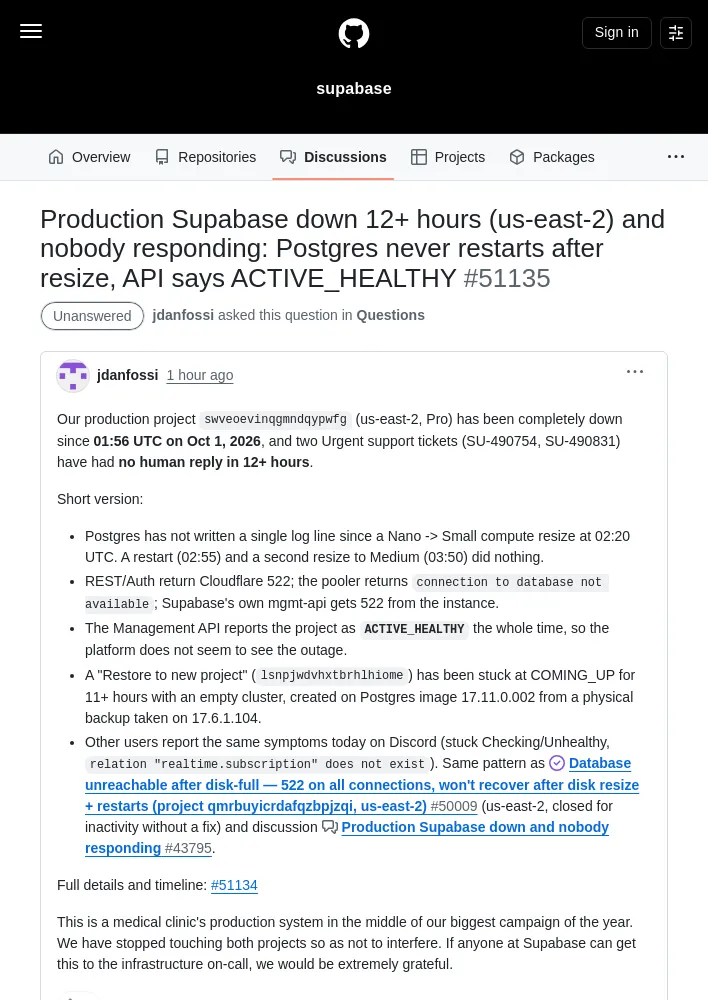
us-east-2프로덕션 프로젝트가 2026년 10월 1일 01:56 UTC부터 12시간 넘게 중단됐지만, 관리 API는 계속ACTIVE_HEALTHY로 표시함. - Nano에서 Small로 컴퓨팅 크기를 조정한 뒤 Postgres 로그가 전혀 기록되지 않았고, 재시작과 Medium으로의 추가 조정에도 복구되지 않음.
- REST와 Auth는 Cloudflare
522를 반환하고, 풀러는 데이터베이스 연결 불가를 표시하며, Supabase 관리 API도 해당 인스턴스에서522를 수신함. - 새 프로젝트로 복원하는 작업도 11시간 넘게
COMING_UP상태에 머물렀으며, 비어 있는 클러스터가 Postgres 이미지17.11.0.002로 생성됨. - 의료 클리닉의 연중 최대 캠페인 기간에 발생한 장애로, 운영자는 두 프로젝트에 추가 조작을 중단했으며 긴급 지원 티켓 두 건에 12시간 넘게 담당자의 답변이 없다고 밝힘.
장애 현황
us-east-2의 Pro 프로덕션 프로젝트swveoevinqgmndqypwfg가 2026년 10월 1일 01:56 UTC부터 완전히 중단된 상태임.- 긴급 지원 티켓
SU-490754와SU-490831에 12시간 넘게 담당자의 답변이 없었음. - 프로젝트 번호는
#51135이며, 게시자는jdanfossi, 게시 시점은 2026년 10월 1일임.
복구 시도와 증상
- Postgres는 02:20 UTC에 컴퓨팅 크기를 Nano에서 Small로 조정한 뒤 로그를 단 한 줄도 기록하지 않음.
- 02:55 UTC 재시작과 03:50 UTC Medium으로의 두 번째 조정도 복구에 효과가 없었음.
- REST와 Auth는 Cloudflare
522를 반환하고, 풀러는connection to database not available을 반환함. - Supabase 관리 API도 해당 인스턴스에서
522를 수신함. - 장애가 이어지는 동안 Management API는 프로젝트 상태를 계속
ACTIVE_HEALTHY로 표시해, 플랫폼이 장애를 감지하지 못하는 것으로 보임.
새 프로젝트 복원 및 유사 사례
- 새 프로젝트
lsnpjwdvhxtbrhlhiome로 복원하는 작업이 11시간 넘게COMING_UP상태에 머물렀으며, 클러스터는 비어 있는 상태임. - 복원 프로젝트는 Postgres 이미지
17.11.0.002로 생성됐고, 물리 백업은17.6.1.104에서 가져온 것임. - 같은 날 Discord의 다른 사용자들도
Checking또는Unhealthy상태에서 멈추고relation "realtime.subscription" does not exist오류가 나타나는 유사 증상을 보고함. - 디스크 용량 부족 뒤 데이터베이스에 접근할 수 없고, 모든 연결에서
522가 발생하며, 디스크 크기 조정과 재시작 후에도 복구되지 않는 이전 사례와 같은 패턴임. 해당 사례는us-east-2프로젝트qmrbuyicrdafqzbpjzqi의#50009이며, 해결 없이 비활성 상태로 종료됨. - 비슷한 논의로
#43795, 「프로덕션 Supabase 중단 및 무응답」이 언급됨. - 전체 세부 내용과 시간표는
#51134에 있음.
운영 영향 및 요청
- 해당 시스템은 의료 클리닉의 프로덕션 시스템이며, 연중 최대 규모 캠페인이 진행되는 중임.
- 운영자는 두 프로젝트에 간섭하지 않도록 추가 조작을 중단했으며, Supabase 담당자가 인프라 온콜 담당자에게 상황을 전달해 주기를 요청함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요