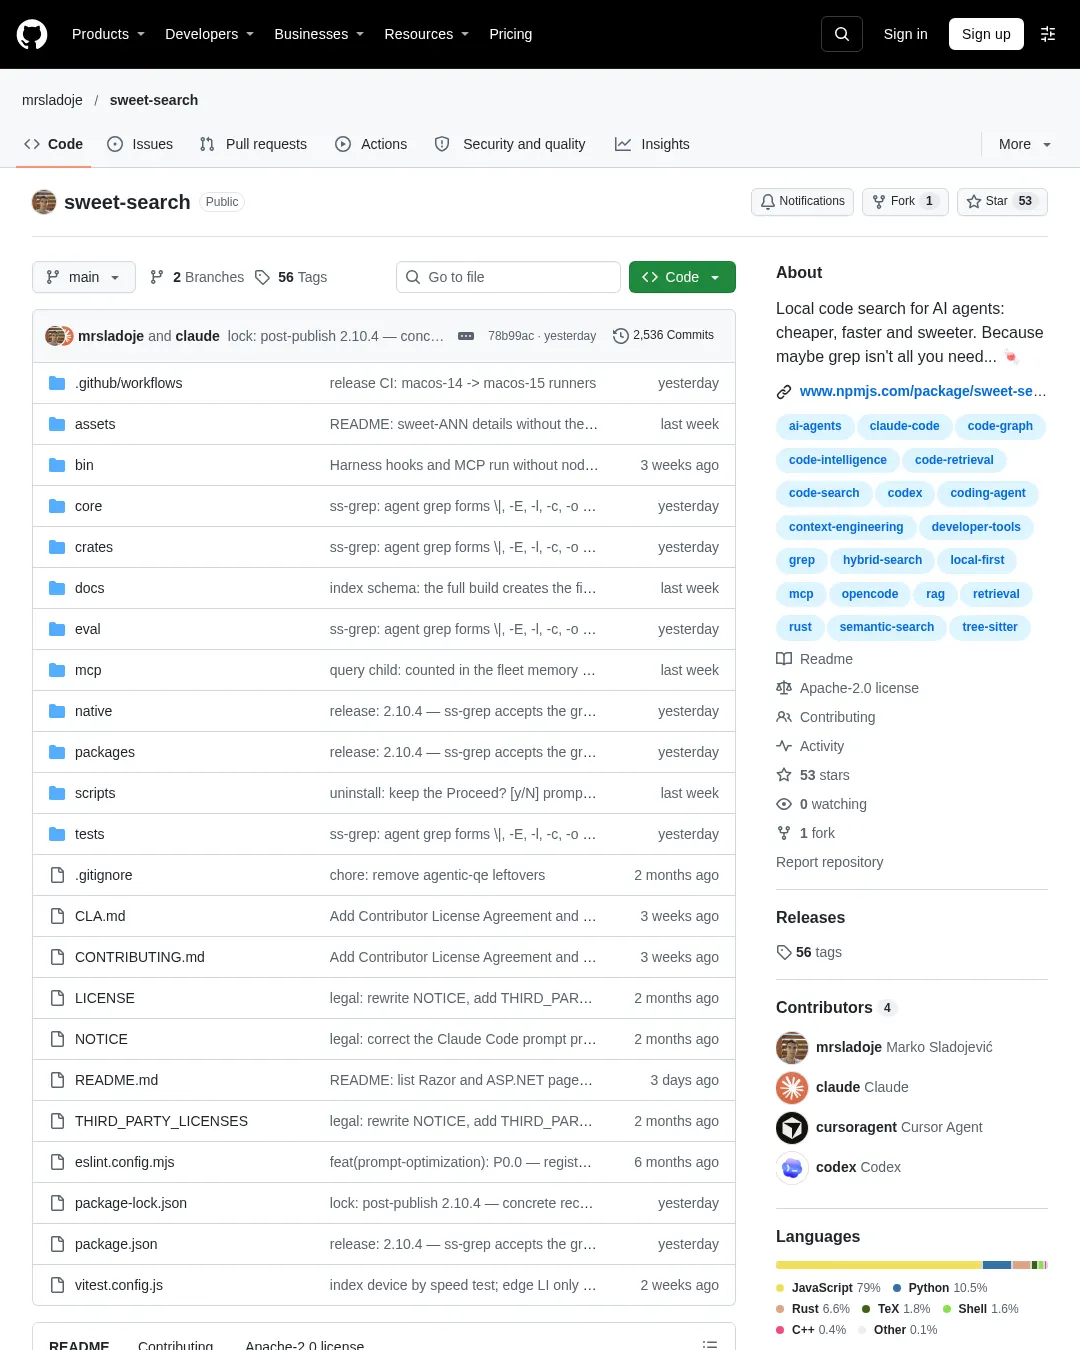
sweet-search는 Claude Code, Codex, opencode 등 코딩 에이전트가 저장소 코드를 검색하도록 돕는 로컬 도구다. 제작자는 200개 실제 엔지니어링 과제에서 기본 검색 도구를 쓴 경우와 비교해 해결 과제 수는 같았고(각 481건), 설정별 비용은 5~33% 낮았다고 밝혔다. 다만 모델·에이전트별 결과가 다르고 일부 설정에서는 정확도가 떨어져, 절감률만으로 효과를 일반화하기는 어렵다.
설치와 적용 조건
Node.js 22 이상이 필요하다. npm으로 설치한 뒤 저장소에서 초기화하고 색인을 만든다. 기본 초기화는 Claude Code를 설정하며, --codex, --opencode 등으로 대상 에이전트를 고를 수 있다.
npm install -g sweet-search

cd your-repo
sweet-search init # one-time: wires up Claude Code
 # Codex: --codex · opencode: --opencode
 # several: --claude --codex --opencode

sweet-search index # builds the index — GPU-accelerated where available

sweet-search "where do we validate JWT tokens?"
초기 색인 뒤에는 작업 중 변경 사항을 백그라운드 데몬이 반영한다. 커밋되지 않은 수정도 색인 대상이다. sweet-search init --wizard는 하드웨어를 확인해 모델 등급을 추천하고, --skip-models는 모델 다운로드를 첫 색인 시점으로 미룬다. 메모리가 제한된 장치에는 --li-model edge를 지정할 수 있다. 모델은 ~/.cache/sweet-search/models/에 저장되며 장치 안에서만 실행된다. CPU 전용 구성은 INT8 모델로 수백 MB, GPU 구성은 약 1.2GB가 추가되며, M3 이상 맥에서는 Neural Engine용 CoreML 구성이 선택 사항으로 약 3.2GB를 더 쓴다.
초기화 대상은 --claude, --codex, --opencode, --agents, --gemini, --cursor 등의 옵션으로 조정한다. 예를 들어 sweet-search init --codex --opencode는 Codex와 opencode를 설정하고, sweet-search init --claude --codex는 두 에이전트를 함께 설정한다. --agents는 다른 AGENTS.md 지원 도구를 위한 안내 파일도 만든다. --mcp를 지정하면 MCP 서버도 등록하지만, 기본 인터페이스는 CLI다. 설치 후 Claude Code에서는 새 세션을 시작해야 한다.
sweet-search init --wizard # interactive: shows your hardware, recommends a model tier
sweet-search init --skip-models # download the models at the first index, not now (CI)
sweet-search init --li-model edge # compact late-interaction model for constrained machines
sweet-search init --codex # Codex only (per-project config, nothing under .claude/)
sweet-search init --codex --opencode # Codex and opencode
sweet-search init --claude --codex # Claude Code and Codex
sweet-search init --agents # Claude Code plus AGENTS.md for other AGENTS.md-reading tools
sweet-search init --no-claude --agents # streamlined AGENTS-only configuration
sweet-search uninstall --dry-run # preview cleanup for the current repo
설정은 프로젝트별 파일에 기록된다. Claude Code의 기존 CLAUDE.md는 수정하지 않고 .claude/ 아래에 에이전트·규칙·스킬을 설치한다. Codex는 프로젝트를 신뢰하기 전까지 .codex/를 읽지 않으므로 초기화 과정에서 신뢰 설정 방법을 안내한다. opencode의 기존 opencode.json 또는 .jsonc는 주석을 보존하며 수정한다. 색인 과정에서 .gitignore를 따르고 node_modules, 빌드 디렉터리, 축소 파일, 1MB 초과 파일은 건너뛴다. 추가 제외 규칙은 .sweet-search-ignore에 넣을 수 있다.
지원 플랫폼은 macOS(Apple Silicon·Intel), glibc 기반 Linux x64·arm64, WSL2를 통한 Windows다. Alpine 등 musl 환경과 다른 CPU도 지원하지만 느릴 수 있다. 네이티브 Windows 실행은 아직 지원하지 않는다. Node.js 22 이상이 모든 플랫폼에서 필요하다. 최근 중급 이상 사양의 장치를 권장하며, RAM이 8GB 이하인 약한 장치에서는 벤치마크하지 않은 더 작은 모델을 쓰므로 제작자는 사용을 권장하지 않는다. 기본 언어 지원에는 JavaScript, TypeScript, Python, Go, Rust, Java, C, C++ 등 여러 언어가 포함되며, 웹·설정·빌드·셰이더·문서 파일도 다룬다.
검색 도구와 색인
sweet-search는 하나의 색인을 공유하는 여섯 도구를 제공한다. ss-search는 의미 기반 검색, ss-grep은 정확한 문자열 검색, ss-find는 정규식 결과를 의미에 따라 다시 정렬한다. ss-semantic은 지정한 파일 안에서 관련 코드 구간을 찾고, ss-trace는 심벌의 호출자·피호출자·변경 영향 경로를 보여준다. ss-read는 파일의 특정 줄을 읽는다. CLI와 MCP에서도 검색·추적·읽기 기능을 사용할 수 있다.
ss-search는 키워드 검색과 코드 임베딩 검색을 결합하고, 재정렬을 거쳐 코드 블록을 반환한다. 검색어가 순수 키워드이거나 파일 경로를 지정하면 벡터 검색을 건너뛴다. sweet-search "<query>"로 CLI에서 실행하며, 더 긴 답변은 --full 또는 --xl, 검색 방식을 고를 때는 --mode lexical|semantic|hybrid|pattern을 쓴다. ss-grep은 정규식 검색을 지원하지만 고정 문자열이 없는 정규식(예: \w+\d)은 색인 가속을 활용하지 못하고 색인 파일을 모두 훑는다.
ss-semantic은 파일 전체 대신 기본적으로 상위 5개 코드 구간과 줄 번호를 반환한다. 각 구간은 디스크에서 다시 읽어 수정 중인 현재 내용을 반영하고, 구간 양쪽의 두 줄을 함께 제공한다. 색인되지 않은 파일은 일반 읽기로 대체된다. ss-trace는 코드 그래프를 이용해 호출 관계와 영향 경로를 찾지만, 문자열 기반 호출이나 메타프로그래밍이 많은 동적 코드에서는 호출 관계를 놓칠 수 있다. 영향 경로의 기본 깊이는 3홉이며 1~4로 바꿀 수 있다. ss-read도 디스크에서 읽으므로 최신 코드를 보여주며, 축소 파일과 생성 파일은 거부한다.
MCP 서버는 search, trace, read, read-semantic, index, health, repo-map, vocab-prewarm 등 8개 도구와 리소스 2개, 프롬프트 2개를 제공한다. 검색 도구는 읽기 전용이며 멱등적으로 선언된다. repo-map은 PageRank 순위의 심벌 개요를 토큰 예산에 맞춰 반환해 하위 에이전트에게 저장소 정보를 전달할 수 있다.
색인은 코드 변경을 감지해 갱신한다. 파일 감시자는 저장 시 데몬을 깨우며, 보통 수정 사항은 수초 안에 검색할 수 있다. 함수 하나를 수정하면 파일 전체가 아니라 해당 청크만 다시 임베딩한다. 갱신은 원자적으로 공개돼 검색이 반쯤 갱신된 색인을 보지 않도록 설계됐다. 전체 스캔은 시작 시, 10분 간격의 안전 점검 때, Git 또는 제외 설정 파일이 바뀔 때 실행된다. 데몬은 낮은 우선순위로 CPU에서 작업하고, 모델 프로세스는 필요할 때 시작해 유휴 상태가 되면 종료한다. sweet-search reconcile status와 sweet-search reconcile inspect <path>로 상태를 확인하고, sweet-search reconcile pause와 resume으로 자동 갱신을 멈추거나 재개할 수 있다. 환경 변수 SWEET_SEARCH_RECONCILE_V2=0으로 자동 갱신을 끌 수도 있으며, sweet-search index --full은 색인을 새로 만든다.
기본 색인은 GPU가 있으면 Metal·CUDA를 활용하고, CPU에서는 ONNX Runtime INT8 경로를 쓴다. M3 이상 맥에는 CoreML Neural Engine 경로가 선택 사항으로 제공된다. 제작자는 4비트 토큰 벡터 압축으로 후기 상호작용 색인 크기를 약 3분의 1로 줄였으며 검색 품질의 측정 가능한 손실은 없었다고 설명한다. 이 제품의 구현·성능 설명은 제작자가 제시한 내용이다.
벤치마크와 한계
제작자는 서로 다른 네 종류의 평가를 공개했다. 실제 에이전트의 코드 검색 평가에서는 개발에 쓰지 않은 공개 저장소 11곳의 질문 200개를 사용했다. 질문은 쉬운 문제 103개와 어려운 문제 97개로 나뉘며, 다단계 검색·호출 흐름·존재하지 않는 항목 확인 등을 포함한다. 각 설정에서 sweet-search와 기본 도구를 비교했고, 질문별 3회 실행과 3인 심사 패널의 중앙값으로 채점했다. 설정은 Claude Code와 Sonnet 5.5·Opus 5.5, opencode와 Sol 6.1, Codex와 Sol 6.1 조합이다.
이 검색 평가에서 청구 비용은 Claude Code + Sonnet 5.5 high에서 7.6% 감소했고, Claude Code + Opus 5.5 medium·high에서는 각각 9.5% 감소했다. opencode + Sol 6.1 high는 50.2%, Codex + Sol 6.1 high는 7.7% 감소했다. 정확도는 Sonnet 설정에서 2.4% 증가했지만, opencode에서는 2.8%, Codex에서는 2.5% 낮았다. 이는 모두 기본 검색 방식 대비 상대 변화다. Sol 6.1 설정에서는 sweet-search가 정확도를 약 2.5~3% 낮췄다는 점을 제작자도 한계로 적었다. 검색 시간 추정치는 opencode에서 34.4% 줄었지만 Codex에서는 8.0% 늘었다.
실제 과제 완료 평가는 SWE-rebench의 엔지니어링 과제 200개를 사용했다. 각 과제는 코드를 찾아 수정하고 숨겨진 테스트를 통과해야 한다. 다섯 설정에 걸친 1,000개 과제 비교에서 sweet-search와 기본 방식은 각각 481개를 해결했다. 따라서 제작자가 제시한 결과는 해결 수가 늘었다는 것이 아니라, 해결 수가 같은 조건에서 비용이 달라졌다는 것이다. 설정별 청구 비용 감소율은 Sonnet 5.5에서 10.8%, Opus 5.5 medium에서 5.4%, Opus 5.5 high에서 7.4%, opencode + Sol 6.1에서 18.6%, Codex + Sol 6.1에서 33.3%였다. 모든 실행은 구독 환경에서 이뤄져 비용은 실제 청구서가 아닌 토큰 목록 가격을 기준으로 환산했다.
이 과제 평가에는 반복 실행이 한 번뿐이었다. 제작자는 같은 조건에서도 한 셀의 해결 수가 3/3, 1/3, 2/3으로 달라진 사례가 있어 해결 수를 점 추정치로 봐야 한다고 밝혔다. Opus 5.5 high의 해결 수는 기본 방식 115건, sweet-search 109건으로 기본 방식에 유리한 방향이었지만 통계적으로 유의하지 않았고(p=0.11), 전체 설정의 해결 수는 같았다. Codex의 과제 비용 절감은 프롬프트 캐시가 있을 때만 나타났다. 테스트 실행과 대기까지 포함하면 Codex는 테스트 대기 시간이 79초 길어져 벽시계 기준 실행 시간은 10.5% 늘었다. 검색 도구 자체가 테스트를 실행하지 않으며, 테스트는 벤치마크에서 부하가 걸린 상태로 실행돼 모델 시간 추정에서는 제외됐다.
비용 절감 폭은 저장소와 과제 종류에 따라 달랐다. 과제 평가에서 Go·TypeScript·Java는 설정 평균 17~18% 감소로 절감 폭이 컸고, Python은 9%로 작았다. 저장소가 21,000줄 미만에서 58,000줄 초과로 커질 때 Codex의 절감률은 15%에서 43%로 커졌지만, 이는 해당 평가의 관찰이다. 작은 하위 집단의 결과는 변동성이 크다고 명시돼 있다. 검색 평가에서는 큰 여섯 언어 집단과 부재 여부를 묻는 질문에서 비용이 모든 설정에서 감소했지만, PHP는 다섯 설정 중 세 곳, Ruby는 두 곳에서 비용이 증가했다. Swift에서는 Sol 6.1의 정확도가 8~12포인트 떨어졌다. 저장소 11곳은 모두 중간 규모(파일 540~1,433개)였으므로 저장소 크기에 따른 결론을 낼 수 없다.
논문용 코드 검색 벤치마크에서는 전체 후보 문서를 대상으로 한 MRR@10을 공개했다. 제작자는 CoSQA에서 65.4, M2CRB에서 54.4를 보고했으며, 두 수치 모두 제시한 비교 기준과 프로토콜에 한정해 해석해야 한다. CoSQA에는 알려진 라벨 노이즈가 있어 절대 점수에 주의가 필요하다. GenCodeSearchNet의 held-out 점수는 86.5지만, 기존 논문 기준은 99개 방해 문서만 대상으로 한 반면 이 평가는 6,000개 문서 전체를 검색하므로 직접 비교할 수 없다. CrossCodeEval은 자연어 코드 검색과 다른 과제이며 점수 0.18을 기록했다고 함께 밝혔다. CoIR, CoSQA+, CLARC는 평가 프로토콜이 맞지 않아 결과를 주장하지 않았다.
엔진 단위 테스트에서는 M3 Max에서 ss-grep이 1,600개 쿼리 중앙값 기준 ripgrep 15.1보다 종단 간 2.46배 빨랐다고 보고했다. 다만 고정 문자열이 없는 정규식은 색인을 이용하지 못한다. 벡터 검색은 M3 Max에서 최대 100만 벡터까지 정확도의 99%를 유지하는 조건에서 경쟁 도구보다 최대 5배 빠르다는 제작자 측 결과다. 이 수치는 하드웨어와 색인 크기 등 평가 조건에 따라 달라진다.
설치 해제와 참고 자료
현재 저장소에서 sweet-search uninstall을 실행하면 sweet-search가 만든 규칙·에이전트 파일과 설정 항목, 훅, 스킬, MCP 등록, 색인 디렉터리 등을 제거한다. 사용자 작성 내용은 보존하며 공유 모델 캐시는 다른 저장소에서 쓸 수 있도록 남긴다. --all은 모든 저장소 설정, 모델 캐시, npm 패키지를 제거하고, --dry-run은 삭제 예정 항목을 미리 보여준다.
프로젝트 저장소와 사용법은 sweet-search GitHub 저장소, 설치 패키지는 npm 페이지에서 확인할 수 있다. 벤치마크 결과와 재현 자료는 저장소의 최종 검색 평가 자료, 과제 지연 시간 분석, 검색 색인 방식 문서에 공개돼 있다. 라이선스는 Apache-2.0이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요