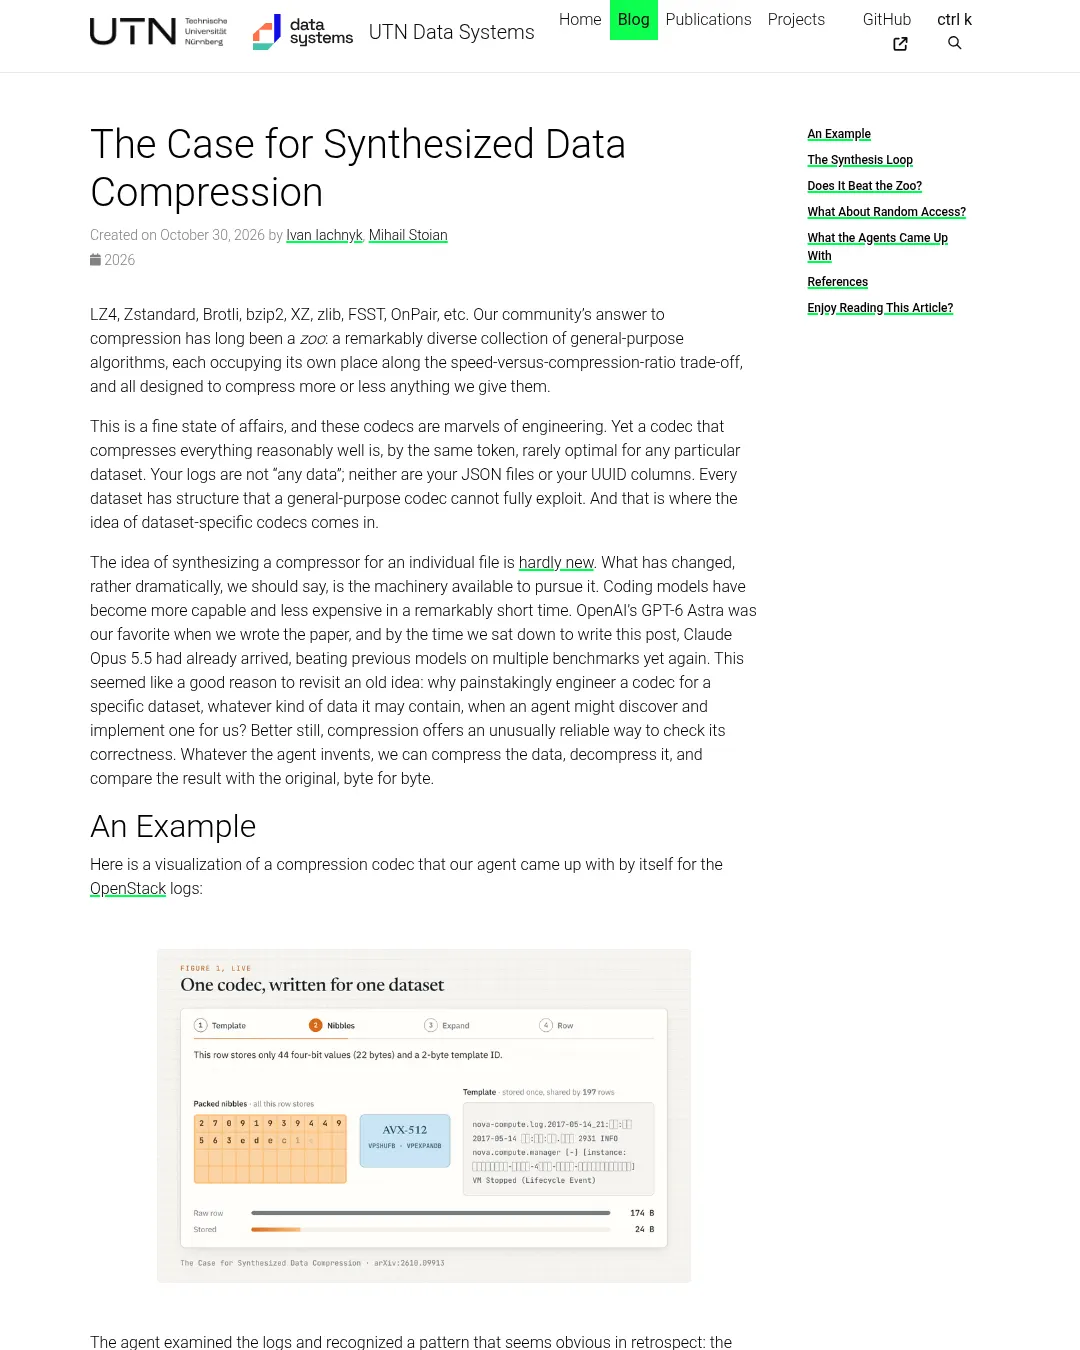
연구진은 AI 에이전트가 데이터셋의 패턴에 맞춘 압축 코덱을 만들고, 원본과 바이트 단위로 대조해 정확성을 확인하는 방식을 제시했다. OpenStack 로그와 여러 텍스트 데이터셋을 대상으로 한 실험에서 합성 코덱은 기존 압축 알고리즘의 속도와 압축률 절충을 넘어서는 결과를 보였다.
사용자는 데이터셋과 원하는 성능 목표를 제시한다. 에이전트는 코덱을 만들고, 테스트 환경은 압축률과 처리 속도, 바이트 단위의 정확성을 평가한다. 에이전트는 이 피드백을 바탕으로 코덱을 수정하며, 예산이 소진되거나 목표를 달성할 때까지 반복한다. 최종 코덱은 데이터와 함께 패키징하기 전에 전체 데이터를 바이트 단위로 검증한다.
연구진은 OpenStack 로그, PyTorrent의 Python 소스 코드, Yelp 리뷰, SQLStorm의 TPC-DS 질의를 대상으로 속도 우선, 압축률 우선, 두 목표의 절충 등 네 가지 과제를 설정했다. 네 데이터셋 모두에서 합성 코덱은 기존 알고리즘의 파레토 전선을 개선했다. OpenStack에서는 한 코덱이 Brotli보다 압축률이 87% 높으면서 디코딩 속도는 거의 두 배였다.
23개 열로 이뤄진 dbtext 데이터에서도 에이전트는 열마다 다른 코덱을 만들었다. 한 코덱은 OnPair+보다 약 30% 빠르게 디코딩하면서 압축률도 조금 높였다. 다른 코덱은 bzip2보다 압축률이 높고 디코딩 속도는 8배 이상이었다. 이 수치에는 생성된 코덱 자체의 크기도 포함됐다.
데이터베이스 열에서는 임의의 행을 읽기 위해 앞선 데이터를 전부 풀지 않아도 되는 무작위 접근도 중요하다. FSST와 OnPair+를 기준으로 비교했을 때, 가장 빠른 합성 코덱은 FSST보다 선택한 행을 거의 두 배 빠르게 가져오면서 저장 공간은 약 3분의 1 적게 차지했다. 압축률을 우선한 다른 설계는 FSST보다 압축률이 94% 높으면서 행을 더 빠르게 읽었다. 가장 작은 설계는 패키지 크기를 10.25MB로 줄였지만 디코더는 눈에 띄게 느렸다. 따라서 어떤 코덱이 적합한지는 속도와 저장 공간 중 무엇을 우선하느냐에 달렸다.
연구진은 압축과 복원을 통해 데이터가 바이트 단위로 정확히 재구성되는지 확인할 수 있어, 에이전트가 특수한 패턴에 맞춰 코덱을 만들어도 결과의 정확성을 검증할 수 있다고 설명한다. 실험에 사용한 코드와 합성 코덱은 GitHub 저장소에서 공개했다. 연구 논문은 Iachnyk et al., 2026이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요