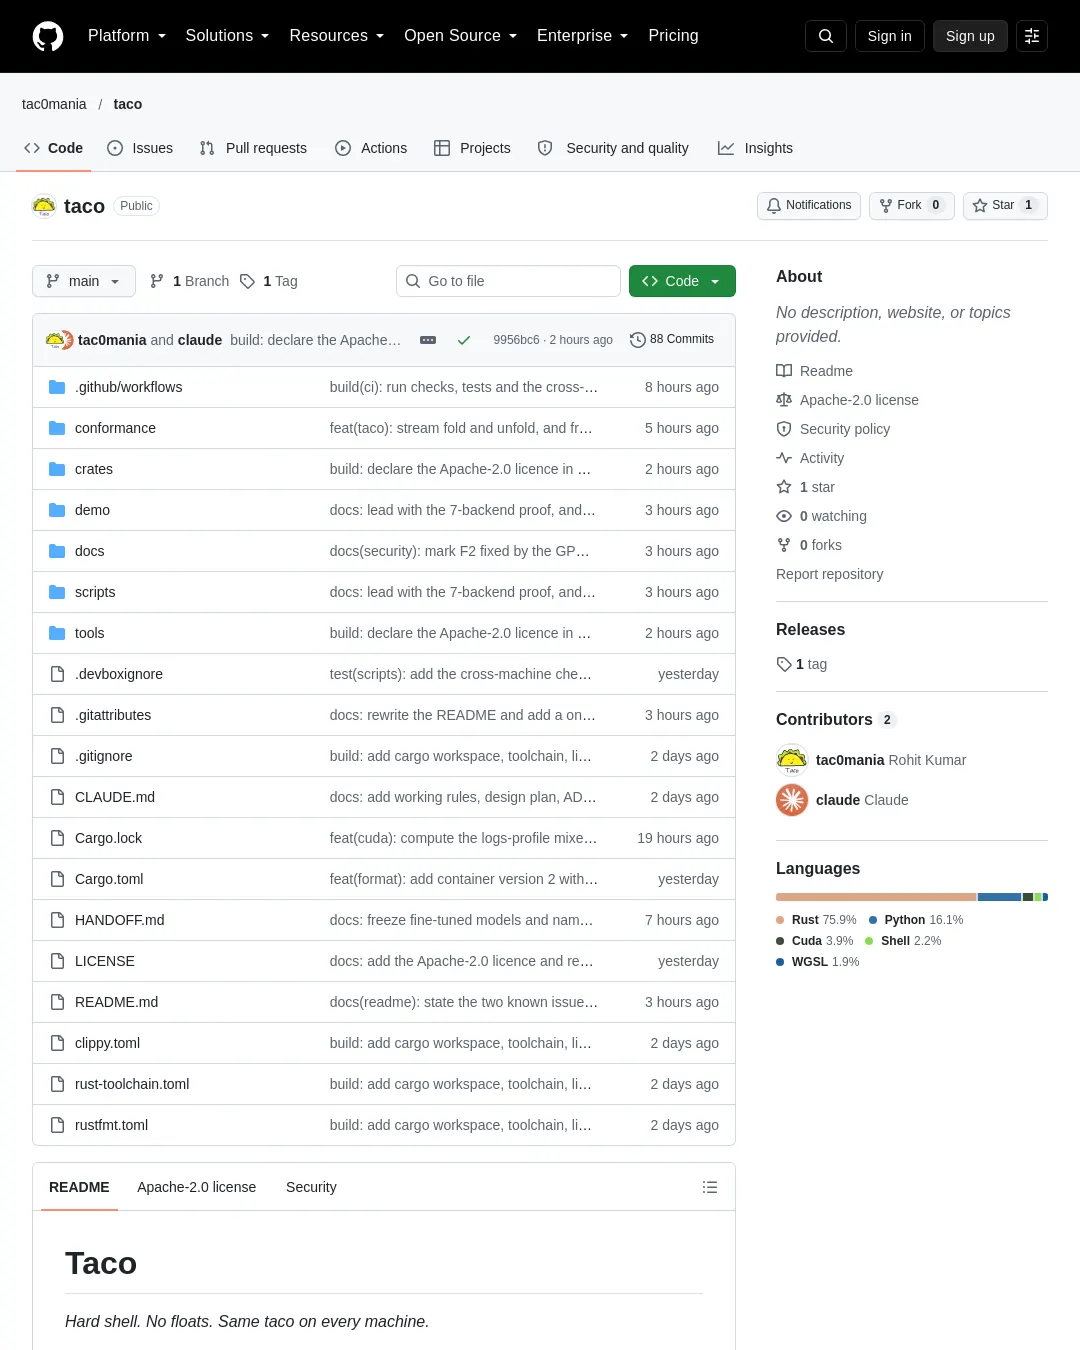
Taco는 GPT-2 언어 모델을 이용해 데이터를 무손실 압축하는 실험용 프로그램이다. 정수 연산만 사용해 CPU와 GPU에서 같은 결과를 내도록 설계했으며, 버전 0.1.0은 아직 느리고 zstd나 xz를 대체하지 않는다. 제작자는 압축한 원본을 보관하고 사용 전 제한 사항을 읽으라고 안내한다.
taco fold notes.txt # makes notes.txt.taco
taco unfold notes.txt.taco # restores notes.txt, byte for byte
Taco는 모델이 다음 데이터 조각을 예측하고, 범위 부호화기가 모델이 예측하지 못한 정보만 저장하는 방식으로 작동한다. 엔진 HardShell은 부동소수점 없이 정수 연산만 수행한다. 제작자는 이 방식으로 모든 CPU와 GPU가 비트 단위로 같은 예측을 하며, 한 기기에서 압축한 파일을 다른 기기에서도 원본 바이트 그대로 복원할 수 있다고 설명한다.
이 저장소의 코드와 테스트, 문서 대부분은 Anthropic의 AI 모델 Claude가 Claude Code와 함께 작성했다. 설계 결정은 저장소 제작자가 내렸다. 제작자는 코드의 신뢰 범위를 적합성 벡터, 기기 간 검사, 퍼징, 최적화 경로와 기준 경로의 비교 테스트가 보여주는 데까지로 한정한다.
기기 간 결과와 검증
버전 0.1.0의 릴리스 프로그램으로 3,672바이트 데모 파일(demo/samples/sample.txt)을 --profile text로 압축한 뒤 복원했다. 측정일은 2026-10-19이며, 3개 운영체제와 2개 CPU 아키텍처, 4종류 프로세서에 걸친 7개 백엔드에서 복원 결과는 모두 바이트 단위로 같았다. 각 .taco 파일의 SHA-256도 모두 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e였다.
| 기기 | 시스템 | 백엔드 | .taco 파일의 SHA-256 |
|---|---|---|---|
| Apple M2 | macOS (ARM) | CPU (NEON) | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| Apple M2 | macOS (ARM) | GPU (Metal) | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| AMD Ryzen 7 5800H | Linux x86-64 | CPU (AVX2) | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| NVIDIA RTX 3060 Laptop | Linux x86-64 | CUDA | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| AMD Ryzen 7 5800H | Windows x86-64 | CPU (AVX2) | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| NVIDIA RTX 3060 Laptop | Windows x86-64 | CUDA | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
| NVIDIA RTX 3060 Laptop | Windows x86-64 | GPU (Vulkan) | 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e |
제작자는 다른 기기에서의 검증을 추가하려면 Try it의 ./try를 실행해 해시를 비교하라고 안내한다. 더 많은 입력을 이용한 검사는 기기 간 동일한 비트 결과에 공개돼 있다.
사용 방법
프로그램을 내려받아 실행하거나 소스에서 직접 빌드할 수 있다. 두 방식은 같은 .taco 바이트를 만든다.
프로그램을 바로 사용하려면 Releases 페이지에서 약 120MB인 taco-demo-0.1.0.zip을 내려받는다. 이 파일에는 macOS(Apple Silicon), Linux(x86-64), Windows(x86-64)용 프로그램과 모델 파일 gpt2.hsm, 한 명령으로 실행하는 데모가 들어 있다. 한 시스템용 프로그램만 필요하면 taco-0.1.0-<system>.tar.gz를 받으면 된다. Windows용은 .zip이며, 이 묶음에는 모델 파일이 포함되지 않는다.
압축을 풀고 taco-demo-0.1.0 폴더에서 터미널을 연 다음 macOS와 Linux에서는 ./try, Windows에서는 try.cmd를 실행한다. 데모는 3,672바이트 영어 텍스트를 압축하고 복원한 뒤 결과를 확인하고 .taco 파일의 SHA-256을 출력한다. 약 10초에서 1분이 걸린다. 출력 끝부분은 다음과 같다.
PASS: the file came back byte for byte. Original: 3672 bytes. Folded: 648 bytes. SHA-256 of the .taco file: 2fab1ef7a1c70cd4e39ddfd88a8d66389ae07a403111db131326ae425460652e
제작자는 이 해시가 모든 기기와 백엔드에서 같다고 설명하며, 두 번째 컴퓨터에서도 데모를 실행해 비교할 수 있다고 안내한다. 직접 파일을 처리할 때는 같은 폴더에서 ./taco fold notes.txt와 ./taco unfold notes.txt.taco를 사용한다. Windows에서는 taco.cmd를 쓴다. 자세한 내용과 문제 해결 방법은 demo/README.md에 있다.
소스 빌드에는 rustup이 필요하다. rust-toolchain.toml에 따라 Rust 1.99.0을 설치한다. Python 도구용 uv, zstd용 C 컴파일러, 디스크 공간 약 1.5GB, 메모리 8GB도 필요하며 GPU는 선택 사항이다.
git clone https://github.com/tac0mania/taco.git && cd taco
uv run --project tools python -m baseline.fetch # GPT-2 weights; the tool checks each SHA-256
uv run --project tools python -m convert.gpt2 # makes tools/data/out/gpt2.hsm (about 1 minute)
shasum -a 256 tools/data/out/gpt2.hsm # must be aaa03eb96e9ad795...b51001ba5c2
cargo build --release --locked -p taco-cli
export TACO_MODEL="$PWD/tools/data/out/gpt2.hsm"
./target/release/taco fold demo/samples/sample.txt --profile text -o /tmp/sample.taco
shasum -a 256 /tmp/sample.taco # must be the hash in section A
./target/release/taco unfold /tmp/sample.taco -o /tmp/sample.txt
cmp demo/samples/sample.txt /tmp/sample.txt && echo "restored byte for byte"
변환기는 각 float32 가중치를 mantissa x 2^exponent로 읽고 정확한 분수로 계산한다. 이에 따라 모든 기기에서 릴리스에 포함된 파일과 바이트 단위로 같은 gpt2.hsm을 만든다. 해시가 다르면 사용하지 말아야 한다. 생성한 .taco 파일의 해시가 위 데모 해시와 같아야 직접 빌드한 프로그램과 릴리스 프로그램이 서로의 파일을 복원할 수 있다.
scripts/release/build.sh <target>은 릴리스 아카이브를 만든다. 경로와 시간을 고정하므로 Linux에서 같은 커밋을 한 기기에서 두 번 빌드했을 때 바이너리가 바이트 단위로 같았다고 측정됐다. 각 아카이브의 BUILDINFO에는 커밋과 프로그램의 SHA-256이 기록된다.
속도 주의: GPU 사용 시 텍스트 압축은 약 85~129KB/s, 복원은 약 26~31KB/s다. CPU만 사용하면 압축은 약 0.3~2KB/s, 복원은 약 0.1~0.5KB/s다. 제작자는 처음에는 몇 KB 크기의 파일을 사용하라고 권한다.
작동 방식과 보장 범위
모델이 어떤 기호를 확률 p로 예측하면 그 기호를 저장하는 데 대략 −log₂(p)비트가 든다. GPT-2는 각 위치에서 50,257개 토큰의 확률을 계산하고, 범위 부호화기는 그 확률에 비례해 숫자 범위를 나눈다. 복원할 때도 같은 모델을 실행해 같은 방식으로 범위를 나누고 토큰을 찾는다.
부호화기와 복호화기의 확률이 정확히 일치해야 한다. 빈도 하나가 1만 달라도 복호화기가 다른 토큰을 고르고 이후 출력이 모두 틀릴 수 있다. 부동소수점 결과는 덧셈 순서, 칩, 수학 라이브러리, 배치 크기에 따라 달라질 수 있다. 명세된 정수 연산은 달라지지 않도록 설계할 수 있다. 이에 따라 HardShell은 i8 가중치와 i32, i64 합계를 사용하고, 반올림 규칙 하나와 모델 파일에 저장된 GELU 및 exp 표를 사용한다.
Taco의 구성 요소는 정수 연산만 쓰는 GPT-2 추론의 공개 명세(docs/adr/0004-hardshell-numerics.md), 정확한 모델 변환기, CPU(NEON·AVX2) 구현, NVIDIA GPU(CUDA) 구현, wgpu를 이용한 Vulkan·Metal·DX12 구현, 모델과 실제 .taco 파일의 바이트를 연결하는 적합성 벡터다. 변환기는 각 float32 가중치를 정확한 분수로 계산해 모든 기기에서 같은 모델 파일을 만든다(ADR 0014). 테스트에서는 각 구현이 같은 비트를 내는지 확인한다.
Taco는 언어 모델 압축기 가운데 최초이거나 최고인 제품은 아니라고 설명한다. Fabrice Bellard의 ts_zip은 더 작은 파일을 더 빠르게 만들며, 제작자 페이지도 결과가 GPU나 CPU에 좌우되지 않는다고 밝힌다. 언어 모델과 엔트로피 부호화기를 결합한 LLMZip, 플랫폼 간 동일하게 복호화되는 압축용 정수 네트워크(Ballé 등, 2019), 정수 연산만 사용하는 Transformer(I-BERT) 등 선행 연구도 있다. Taco가 더한 요소는 점검 가능한 정수 명세, 반복 가능한 모델 변환, 여러 독립 구현, 구현 간 일치를 확인하는 테스트의 결합이다.
제작자가 보장 대상으로 명시한 사항은 다음과 같다.
- 압축과 복원에서 부동소수점 연산을 쓰지 않는다. 엔진, 부호화기, 믹서, GPU 커널은 정수만 사용하며
scripts/check-no-floats.sh가 푸시마다 이를 검사한다. - 연산이 완전히 명세된 경우 모든 기기에서 같은 결과를 낸다. 정수 연산만으로는 충분하지 않으므로 모든 합계는 충분히 넓은 누산기를 사용하고 코드에 상한을 쓰거나, 오버플로가 정해진 방식으로 순환하도록 한다. 반올림과 클램프는 각각 하나의 규칙으로 정하며(ADR 0004), 부호 있는 나눗셈에는 바닥 나눗셈 헬퍼를 쓴다. 이 규칙으로 컴파일러, CPU 종류, GPU 드라이버가 결과를 바꾸지 못하게 한다. 테스트는 이를 확인하지만, 코드가 어디서나 규칙을 지킨다는 사실을 증명하지는 못한다.
- 모델 파일은 모든 기기에서 같다. Mac과 Linux가 바이트 단위로 같은
gpt2.hsm을 만들며 SHA-256은aaa03eb96e9ad7957432168c8ac6b4a99ed55d57e637e4786a664b51001ba5c2다. - 각
.taco파일에는 원본 데이터의 SHA-256이 저장되며taco unfold가 이를 검사한다. 잘못된 결과를 조용히 내보내지 않도록 하기 위한 검사지만 오류를 고치지는 못한다. 복원에 실패하면--backend cpu를 사용하거나 다른 기기에서 다시 시도할 수 있다. 압축 중 버그나 하드웨어 오류가 발생하면 복호화기로 원본을 복구할 수 없으므로,.taco파일을 한 번 복원하기 전까지 원본을 보관해야 한다.
코드 버그, GPU 드라이버 버그, 하드웨어 오류는 여전히 발생할 수 있다. Taco는 GPU를 쓰기 전에 자체 테스트를 하고 실패하면 다음 백엔드를 사용한다. 제작자는 각 경우에 SHA-256 검사가 오류를 찾아낸다고 설명한다.
측정 결과와 제약
아래 수치는 별도 표시가 없으면 측정값이다. 세부 자료는 docs/research/에 있으며, 파일 크기 비교에는 양쪽 기기가 모두 갖춰야 하는 127MB 모델 파일이 포함되지 않는다.
| 파일 | 원본 | Taco | xz -9e | zstd -19 |
|---|---|---|---|---|
| 영어 책 (32 KiB) | 32,768 | 8,432 | 12,400 | 12,463 |
| HTML 페이지 | 24,603 | 4,759 | 7,652 | 7,713 |
| 영어 (4 KiB) | 4,096 | 1,237 | 1,684 | 1,599 |
| 서버 로그 (16 KiB) | 16,384 | 3,129 | 3,164 | 3,139 |
| Excel 파일 (바이너리) | 8,192 | 8,285 (원본 그대로 저장) | 1,672 | 2,097 |
alice29.txt 전체(152,089바이트)에서 xz -9e는 발표된 수치로 48,492바이트, 바이트당 2.55비트였다. Taco는 38,939바이트, 바이트당 2.05비트였고, ts_zip은 발표된 수치로 21,713바이트, 바이트당 1.14비트였다. ts_zip이 Taco보다 44% 작다. ts_zip은 더 크고 새로운 RWKV 모델(1억 6,900만 매개변수)을 사용한다. GPT-2 small은 1억 2,400만 매개변수이며, Taco의 text 프로필은 16KiB 블록마다 모델 문맥을 다시 시작한다.
로그용 logs 프로필은 GPT-2와 매치 모델, 믹서를 쓴다. Loghub 로그 파일 16개(총 4,458,875바이트)를 기본 설정인 64KiB 블록, 문맥 중첩 512로 처리했다. 다른 압축기는 전체 파일을 사용했다(프로필 연구 자료, 로그 프로필 자료). zstd -19 --long=27은 바이트당 0.597비트, xz -9e는 0.554비트, Taco logs는 0.494비트로 xz보다 10.8% 작았다. 느린 문맥 혼합 압축기 paq8px -8은 다른 로그 6개 전체에서 Taco의 추정치 0.600에 비해 0.348비트로 더 작았다.
RTX 3060(95W, CUDA, 커밋 1493af3)에서 Apache_2k.log(171KB)는 압축 4.5초, 복원 53.8초였다. CPU에서는 각각 208.8초와 90.1초였다. apache_access.log(2.37MB)는 압축에 70~98초, 복원에 255~280초가 걸렸다.
현재 버전에 포함되지 않은 로그 압축 개선안으로, 건너뛰기 규칙은 시뮬레이션 추정치로 4.8~7.3% 더 작아질 수 있다(ADR 0017). 알려진 시스템의 로그로 미세조정한 모델은 해당 시스템에서 53.2% 작았지만 다른 시스템에서는 4.6% 커졌다. 이 결과는 측정 후 동결됐다(실험).
16개 텍스트 파일(총 42,256바이트)에서 GPT-2 small 부동소수점 모델은 바이트당 1.867비트, 정수 모델(gpt2.hsm)은 1.871비트로 총량 기준 0.2% 컸다. 개별 파일은 -9.0%에서 +6.6%까지 달라졌다. 변환 과정에서 큰 활성값이 포화돼 예측이 바뀐다. 같은 포화를 적용한 부동소수점 모델과 비교하면 정수 모델은 2.3% 더 컸다(연구 자료 §6).
RTX 3060 Laptop GPU(95W)에서 엔진은 1,024토큰 전체 구간을 초당 20,472토큰으로 처리했다. 영어 텍스트 압축은 85~129KB/s, 복원은 26~31KB/s였다. CPU만 쓸 때 압축은 약 0.3~2KB/s, 복원은 약 0.1~0.5KB/s다. 비교 기준인 zstd -3는 초당 수백 MB, xz -9e는 약 0.7MB를 압축한다. ts_zip은 RTX 4090에서 최대 1MB/s라고 발표했지만 다른 GPU에서의 수치다.
대용량 스트리밍 검사는 속도가 아니라 파일 크기에 따라 메모리가 증가하지 않는지 확인했다(ADR 0018). 개발용 CPU에서 임의 단어 200,000,000바이트와 소형 테스트 모델을 사용했다. 파일에서 파일로 압축할 때 최대 RSS는 254MiB, 표준 입력에서 표준 출력으로 압축할 때 276MiB였다. 파일 단위 복원은 38MiB, 표준 입출력 복원은 35MiB였다. 두 복원 모두 입력을 바이트 단위로 되살렸다. 테스트 모델은 임의 가중치라 각 블록이 zstd 또는 원본 그대로 저장됐고, 복원 과정에서 모델 단계를 실행하지 않았다. 따라서 측정 시간은 Taco의 속도를 나타내지 않는다. GPT-2로 압축한 최대 파일은 측정 기준 2.4~2.7MB다.
기기 간 추가 검사에서는 Mac(ARM)과 Linux(x86) 사이에서 양방향으로 12개 입력 중 12개를 복원했고, .taco 파일 12개가 모두 같았다. Windows x86과 Mac 비교는 9개 중 9개 파일이 같고 모두 복원됐다. CPU, CUDA, wgpu(Metal, GL) 검사에서는 GPU 사례 14개 모두 같은 바이트를 냈다. 푸시마다 실행하는 CI는 Linux x86-64와 Linux ARM64에서 같은 적합성 해시 50개를 확인한다. 손상된 컨테이너, 부호화기 스트림, 모델 파일을 대상으로 수백만 건을 퍼징해 실패는 0건이었다(보안 자료).
하드웨어 지원과 제한
Apple M2(macOS)는 NEON CPU와 Metal 기반 wgpu, AMD Ryzen 7 5800H는 Linux와 기본 Windows의 AVX2 CPU, NVIDIA RTX 3060 Laptop은 CUDA에서 비트 단위 결과를 확인했다. RTX 3060에서는 Linux의 OpenGL 기반 wgpu와 Windows의 DX12(DXC)도 확인했다. AMD Radeon iGPU(Ryzen 7 5800H)는 기본 Windows의 DX12(DXC)에서 확인했다. Windows의 NVIDIA RTX 3060과 AMD Radeon iGPU에서 Vulkan 기반 wgpu는 연산 테스트 4개를 통과했지만 전체 모델 테스트는 아직 실행하지 않았다. GitHub Actions의 Linux x86-64·ARM64 CPU는 적합성 해시 50개가 같았다.
아직 검사하지 않은 대상은 Intel GPU, Linux의 AMD GPU, AMD 외장 GPU, Intel 기반 macOS, 빅엔디안·32비트 CPU, 휴대전화와 브라우저다. AMD와 Intel GPU에는 별도 코드가 필요하지 않고 일반 GPU 드라이버와 wgpu를 쓴다. CUDA 백엔드는 연산 기능 8.0 이상(RTX 30 시리즈, A100 이후)이 필요하다. 구형 NVIDIA GPU는 wgpu나 CPU를 사용할 수 있으며 결과 비트는 같고 속도만 달라진다. Windows의 구형 FXC 셰이더 컴파일러는 14개 커널 중 7개를 컴파일하지 못한다. 자체 테스트가 실패하면 Taco는 다음 백엔드를 사용한다. Vulkan, Metal, DX12와 DXC는 작동한다.
주요 제한은 다음과 같다.
- 느리며 GPU 사용을 강력히 권장한다. 특히 16KiB 블록 하나를 복원하는 데 RTX 3060 기준 약 10~13초가 걸리는 것으로 측정값에서 추정했다.
- GPT-2는 영어 모델이다. 독일어와 프랑스어에서는 PPMd보다 파일이 커지고, 중국어에서는 gzip보다 커졌다(측정).
- 사진, 영상, 아카이브 등 바이너리 데이터는 zstd 또는 원본 그대로 저장한다. 이런 데이터에는 zstd를 권장한다.
logs프로필은 xz보다 작지만 paq8px가 더 작다(측정).- 모델 파일은 127MB이며 양쪽 기기에 같은 파일이 있어야 한다. 릴리스 프로그램은 아직 모델을 내려받지 않는다.
- 신뢰할 수 없는 모델 파일은 매우 큰 KV 캐시를 지정할 수 있다(미해결 발견 F6). 공개된
gpt2.hsm만 불러와야 한다. - 모델 파일 버전 2는 CPU와 CUDA에서 실행되지만 아직 wgpu를 지원하지 않는다. 기본
gpt2.hsm은 버전 1이며 모든 백엔드에서 실행된다. - 컨테이너 버전 2 형식은 동결돼 이후 Taco 버전도 이 형식의 파일을 읽는다.
0.1.0-alpha.1프로그램은 기본 프로필auto의 압축에 CPU를 사용한다. GPU를 사용하려면--profile text를 지정한다. 조작된.taco파일은 GPU 복원에서 약 11GB를 사용할 수 있다(F2). 신뢰할 수 없는 파일에는--backend cpu를 사용해야 한다. 위 GPU 로그 속도는main에서 측정됐다.
형식, 프로필, 다음 계획
블록은 서로 독립적이라 병렬 처리할 수 있고 손상도 한 블록에 한정된다. 압축 후 작아지지 않은 블록은 zstd 또는 원본 그대로 저장한다. 최악의 크기 증가는 헤더 104바이트와 블록당 5바이트다. logs 프로필은 반복되는 줄을 위한 매치 모델과 믹서를 추가한다. 기본값인 auto는 블록마다 더 작은 결과를 선택한다. 파일 형식은 ADR 0006과 ADR 0011, 모델 파일 형식은 ADR 0004에 정의돼 있다. 전체 구조 설명과 측정, 결정 이유는 docs/core-architecture.md에 있다. 압축이나 머신러닝이 낯선 독자는 부동소수점, 엔트로피, 범위 부호화, 트랜스포머, 양자화를 설명하는 docs/primer.md에서 시작할 수 있다.
명령 형식은 다음과 같다.
taco fold <input> [-o <output>] [-c] [--profile text|logs|auto] [--backend auto|cuda|gpu|cpu] taco unfold <input.taco> [-o <output>] [-c] [--backend auto|cuda|gpu|cpu]
-o <path>는 출력 파일을, -c는 표준 출력을 지정한다. 입력 -는 표준 입력이다. -m <path.hsm>은 모델 파일을 지정하며 기본값은 TACO_MODEL 환경 변수다. --profile은 압축 전용으로 text(GPT-2), logs(GPT-2·매치 모델·믹서), auto(기본값)를 선택한다. --backend는 cuda, gpu(wgpu), cpu, auto 중에서 고른다. 기본 auto는 자체 테스트를 통과하는 첫 백엔드를 쓴다. 어느 백엔드든 출력은 같아야 한다. 압축 전용 --block-size와 --overlap은 블록 크기와 문맥 중첩을 지정하며 기본 블록 크기는 text에서 16KiB, logs와 auto에서 64KiB다. --threads <n>은 작업자 스레드 수를 지정해도 출력이 달라지지 않는다. -f, -q, -V는 각각 출력 파일 덮어쓰기, 진행 출력 끄기, 버전 표시 옵션이다. 파일 크기에 관계없이 메모리를 제한해 스트리밍하며, 자세한 내용은 taco --help와 docs/man/taco.1에서 확인할 수 있다.
알파 버전이 보여주는 핵심은 모든 기기에서 같은 비트를 만든다는 점이며, 아래 계획은 이후에 진행할 항목이다. 제작자는 이 항목들이 그 속성을 바꾸지 않고 알파 파일도 계속 읽을 수 있다고 설명한다.
| 계획 | 기대 효과 |
|---|---|
taco unfold의 추측 실행(ADR 0017) | 시뮬레이션 추정으로 복원 1.8~3.7배 향상 |
logs 프로필의 건너뛰기 규칙(믹서 규칙 2) | 18개 로그 파일 시뮬레이션 추정으로 4.8~7.3% 축소 |
| 작은 텍스트 파일에 더 작은 블록 적용 | 25KB 파일 복원 13.7초에서 4.7초로 단축, 크기 2.3% 증가. 427KB 파일은 17.7초에서 10.7초로 단축, 크기 1.0% 증가(측정) |
text 프로필에 더 긴 문맥 적용 | 파일 축소(미측정) |
| GPU에서 범위 부호화 | 토큰마다 발생하는 CPU-GPU 왕복 한 번 제거(미측정) |
| 연산 기능 6.1·7.5용 CUDA 지원 | 구형 NVIDIA GPU에서 속도 향상(미측정) |
taco에서 모델 내려받기(설계 문서) | 모델 수동 설정 제거 |
| 자동 변환기를 통한 다른 모델 지원(설계 문서) | 설계 완료 |
제품에 포함하지 않은 실험으로, Loghub 시스템 12곳의 로그로 미세조정한 distilgpt2(6개 레이어, “Route A”)를 평가했다. taco fold --profile logs로 각 파일의 첫 16KiB를 압축했다. 학습에 포함된 Android, HDFS, Mac, OpenStack 로그에서는 xz -9e 10,872바이트, zstd -19 10,897바이트, GPT-2 기반 Taco 7,672바이트, 미세조정 모델 3,593바이트였다. 학습에 포함되지 않은 Apache, HealthApp, Proxifier, Zookeeper 로그에서는 각각 4,664, 4,578, 3,709, 3,879바이트였다.
학습에 포함된 시스템에서 미세조정 모델은 xz보다 67%, GPT-2보다 53% 작았다. 보지 않은 시스템에서는 GPT-2보다 4.6% 컸지만 xz보다는 17% 작았다. 레이어가 12개인 GPT-2보다 적은 6개 레이어를 써 엔진 속도는 초당 30,319토큰으로 GPT-2의 20,472토큰보다 1.5배 빨랐다. 제작자는 한 회사의 로그로 미세조정한 모델이 유력한 활용 사례라고 설명하지만, 알파의 초점은 압축률이 아니라 기기 간 동일한 비트 결과이므로 실험 모델을 동결했다. 자세한 내용은 docs/core-architecture.md §8.6에 있다. ts_zip은 로그 결과를 발표하지 않아 이 비교에는 포함되지 않았다(Route A 연구 자료 §8).
코드를 바꾸기 전에는 CLAUDE.md를 읽어야 한다. 이 문서에는 Taco가 비트 단위 결과를 지키는 규칙이 있으며, 예측 경로에서 부동소수점 연산을 쓰지 않는 것이 가장 중요하다. 아키텍처 문서는 docs/core-architecture.md, 배경 설명은 docs/primer.md, 현재 상태와 다음 단계는 HANDOFF.md, 코드 구조는 docs/ARCHITECTURE.md에 있다. 설계는 docs/design/plan.md, 결정 기록은 docs/adr/, 측정은 docs/research/, 위협 모델과 퍼징 결과는 docs/security.md, CI와 기기 간 적합성 검사는 docs/ci.md에 있다.
scripts/check.sh # tags, no floats, fmt, clippy -D warnings, all tests
scripts/xcheck # the cross-machine check: Mac (ARM) and devbox (x86), 12 inputs
부호화기, 모델 파일, 표, 컨테이너를 바꾸면 .taco 파일의 바이트가 달라진다. 이런 변경에는 새 형식 버전, 이전 버전용 읽기 기능, 새 적합성 벡터, ADR이 필요하다(CLAUDE.md §1, §8).
라이선스는 Apache-2.0이며 LICENSE에 명시돼 있다. GPT-2 가중치는 OpenAI에서 제공받았으며 수정된 MIT 라이선스를 따른다. 가중치는 저장소에 포함되지 않고 tools/baseline이 내려받는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요