TenseMem은 AI 에이전트가 과거 사실과 현재 사실을 혼동하지 않도록 설계된 메모리 라이브러리다. SQLite 파일 하나로 실행하며, 언어 모델은 유형이 지정된 변경안을 제안하고 실제 반영 여부는 엔진이 결정한다.
설치와 기본 사용은 다음과 같다.
from tensemem import FakeExtractor, Memory

mem = Memory(llm=FakeExtractor())
mem.register_predicate("lives_in")
added = mem.add("u1", "I live in Delhi")
ctx = mem.context(user_id="u1", min_seq=added.seq, wait=1.5)
print(ctx.text) # fenced block the model can read
print(ctx.freshness.is_current) # True once extract finished
FakeExtractor는 규칙 기반이라 API 키가 필요 없다. 프로젝트는 tensemem[openai], tensemem[anthropic], tensemem[ollama], tensemem[litellm] 추가 기능과 Gemini 어댑터도 제공한다고 설명한다. Gemini 키는 추출 작업을 실행하는 프로세스의 환경 변수에 둬야 한다.
TenseMem은 슬롯마다 현재값 하나를 유지하고, 이전 값은 이력으로 남긴다. 예를 들어 거주지가 Delhi에서 Bangalore로 바뀌면 현재 상태에는 Bangalore가 표시되고, 이력에서는 Delhi가 대체된 값으로 확인된다. correct()로 변경을 취소하면 대체된 값이 복원되며, 프로젝트 설명에 따르면 새 모델로 rebuild()를 해도 수정 내용이 유지된다.
각 읽기 결과에는 as_of_seq, pending, is_current 등 신선도 정보가 포함된다. 처리 중인 메시지가 아직 반영되지 않았는지 확인하거나, 반영될 때까지 기다릴 수 있다. 또 추출 과정에서 사용자 발화를 근거로 삼도록 하고, 모델이 읽는 context()는 구분 표시로 감싼다. 프로젝트는 이를 통해 메모리 내용을 다시 입력으로 받아 스스로 학습하는 일을 막는다고 설명한다.
벤치마크와 이용 조건
프로젝트가 공개한 TenseBench는 네트워크를 사용하지 않고 FakeExtractor로 대화 101개를 평가한다. 아래 수치는 프로젝트가 제시한 결과다.
| 시스템 | 현재 상태 정확도 | 오래된 사실 누출 | 신선도 정직성 | 오염 |
|---|---|---|---|---|
| TenseMem | 1.00 | 0.00 | 1.00 | 0.00 |
| 대화 기록 단순 연결 | 0.37 | 1.00 | 0.00 | 해당 없음 |
| 토큰 중첩 검색 | 0.37 | 1.00 | 0.00 | 해당 없음 |
평가 방법은 TenseBench 문서에서 확인할 수 있다. 이 결과는 프로젝트가 패키지에 포함한 대화와 FakeExtractor를 사용한 평가에 해당한다.
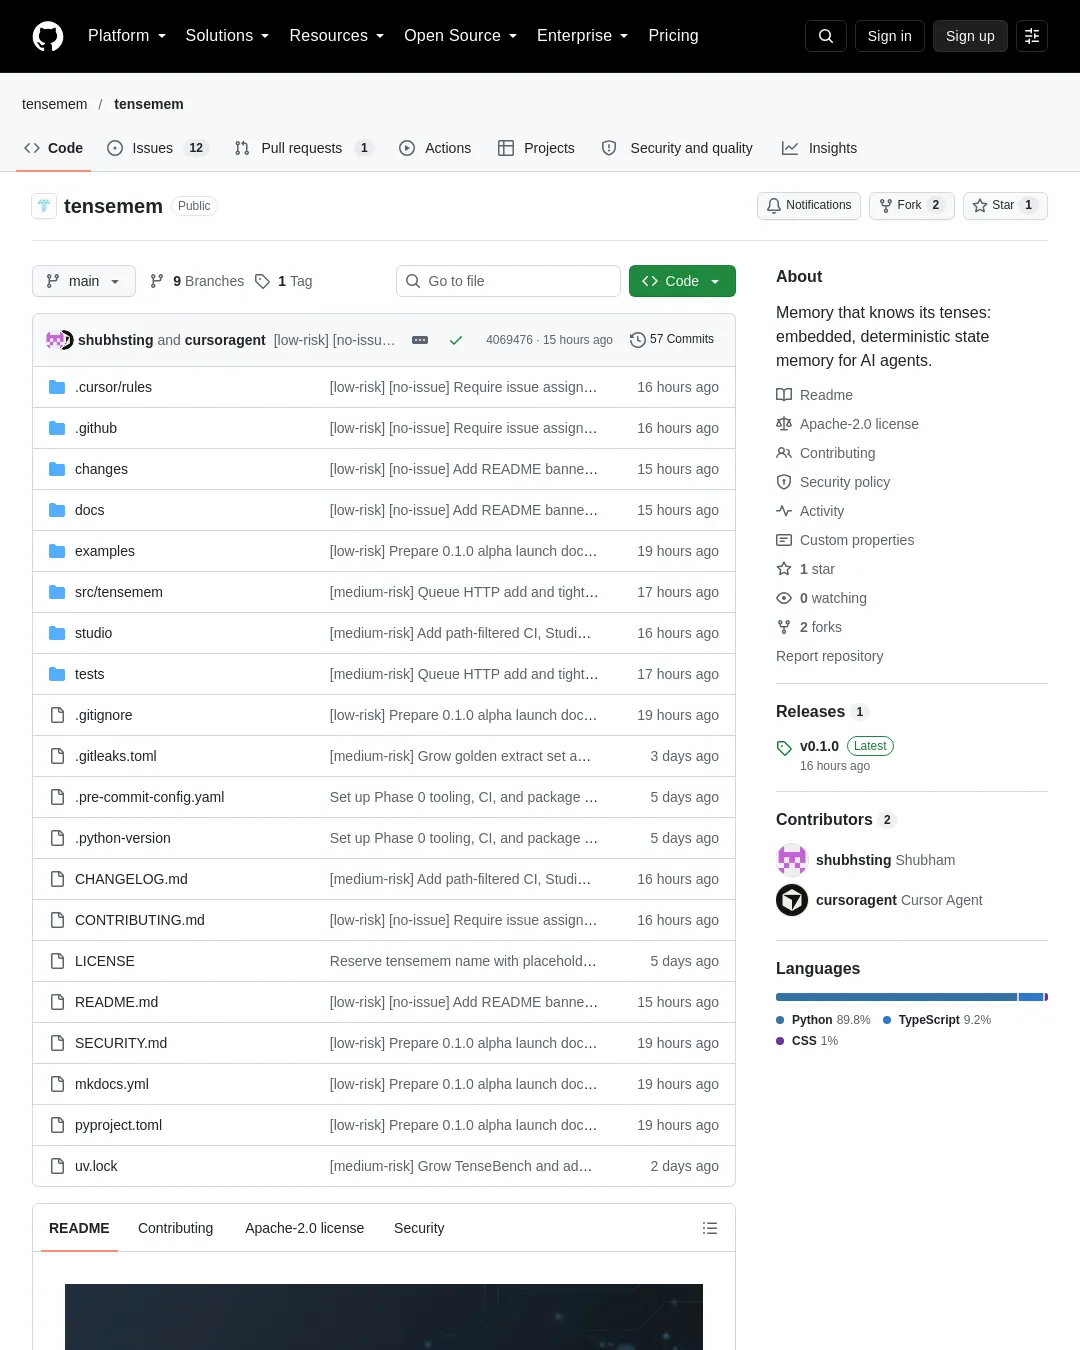
저장소 상태는 0.1.0 alpha다. Python API, CLI, REST, MCP, Studio를 단일 SQLite 파일로 사용할 수 있다고 안내하지만, SQLite 외의 두 번째 SQL 방언은 제공하지 않으며 다중 테넌트 호스팅 Studio도 포함하지 않는다. Studio는 저장소를 내려받아 실행하는 로컬 Next.js 도구이며, 챗봇은 아니다. 비밀 키는 Studio의 Token 입력란이 아니라 서버 프로세스 환경에 둬야 한다.
git clone https://github.com/tensemem/tensemem.git
cd tensemem
pip install "tensemem[server]"
tensemem --db ./studio.db serve --port 8080
cd studio && npm install && npm run dev
프로젝트와 사용 안내는 저장소, 빠른 시작, 개념 설명, API 문서, CLI 문서, REST 문서, Studio 안내, MCP 안내에서 볼 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요