TL;DR
- 합성 데이터만으로 단일 계보의 모델을 반복 미세조정하는 설정에서, 모델 없이 원문 텍스트만 사용하는 엔트로피율 필터링이 텍스트 다양성 지표를 개선함.
- 비모수 Kontoyiannis 엔트로피율 추정량 $h_k$는 일치 길이 통계(match-length statistics)로 계산되며 모델 로그 확률이나 외부 오라클이 필요하지 않음.
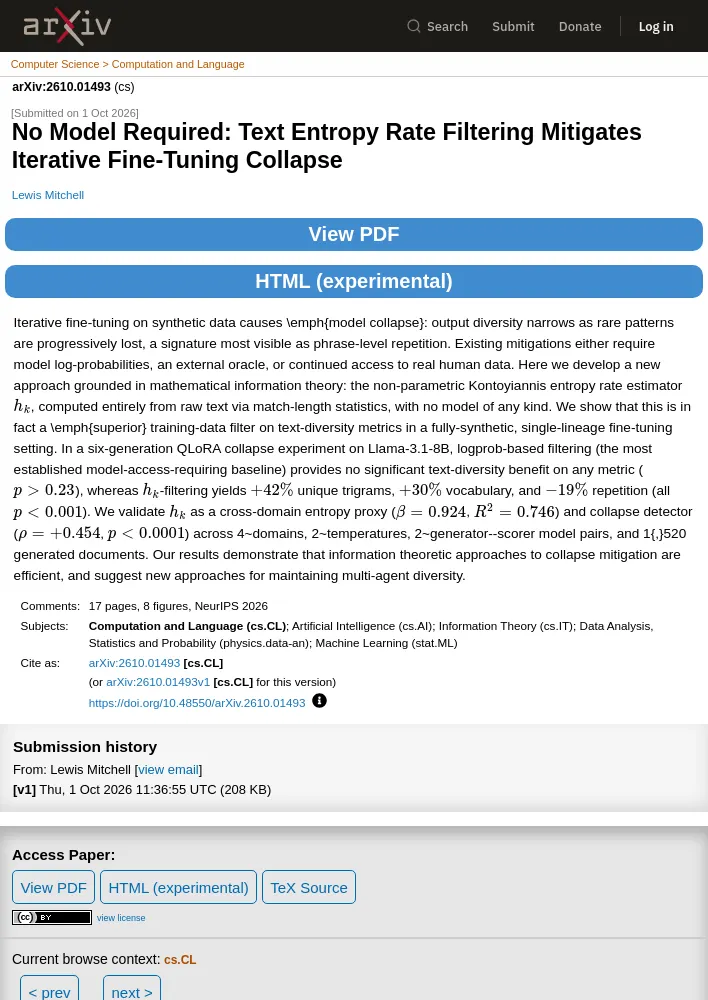
- Llama-3.1-8B의 6세대 QLoRA 붕괴 실험에서 로그 확률 기반 필터링은 어떤 다양성 지표에서도 유의한 이점을 보이지 않음($p > 0.23$).
- $h_k$ 필터링은 고유 트라이그램 42% 증가, 어휘량 30% 증가, 반복 19% 감소를 보였으며, 세 결과 모두 통계적으로 유의함($p < 0.001$).
- 4개 도메인과 1,520개 생성 문서에 걸친 검증에서 $h_k$는 교차 도메인 엔트로피 대리 지표이자 붕괴 탐지기로 기능하며, 다중 에이전트의 다양성 유지에 관한 새 접근법을 시사함.
연구 배경과 접근법
- 합성 데이터로 반복 미세조정하면 드문 패턴이 점차 사라져 출력 다양성이 좁아지는 모델 붕괴(model collapse)가 발생하며, 구문 수준 반복에서 두드러짐.
- 기존 완화 방법은 모델 로그 확률, 외부 오라클 또는 지속적인 실제 인간 데이터 접근을 요구함.
- 제안 방법은 정보 이론에 기반한 비모수 Kontoyiannis 엔트로피율 추정량 $h_k$를 원문 텍스트의 일치 길이 통계만으로 계산하며, 어떤 종류의 모델도 사용하지 않음.
붕괴 실험 결과
- 완전 합성 데이터와 단일 계보 미세조정 조건에서 $h_k$가 텍스트 다양성 지표상 우수한 학습 데이터 필터임을 보임.
- Llama-3.1-8B를 대상으로 한 6세대 QLoRA 붕괴 실험에서 기존 모델 접근 기반 기준선인 로그 확률 필터링은 어떤 텍스트 다양성 지표에서도 유의한 이점을 제공하지 않음($p > 0.23$).
- $h_k$ 필터링 결과는 고유 트라이그램 42% 증가, 어휘량 30% 증가, 반복 19% 감소이며, 모든 결과가 유의함($p < 0.001$).
교차 도메인 검증과 의의
- 4개 도메인, 2개 온도, 2개 생성기-평가기 모델 조합, 1,520개 생성 문서를 대상으로 $h_k$를 검증함.
- 엔트로피 대리 지표 검증 결과는 $\beta = 0.924$, $R^2 = 0.746$이며, 붕괴 탐지 결과는 $\rho = +0.454$, $p < 0.0001$임.
- 결과는 정보 이론 기반 접근이 붕괴 완화에 효율적임을 보여주며, 다중 에이전트 다양성을 유지하는 새로운 접근법을 시사함.
논문 정보
- 저자: Lewis Mitchell.
- 분야: 계산 및 언어(cs.CL), 인공지능(cs.AI), 정보 이론(cs.IT), 데이터 분석·통계·확률(physics.data-an), 기계학습(stat.ML).
- 인용: arXiv:2610.01493 [cs.CL]; 이 버전은 arXiv:2610.01493v1 [cs.CL]임.
- DOI: https://doi.org/10.48550/arXiv.2610.01493.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요