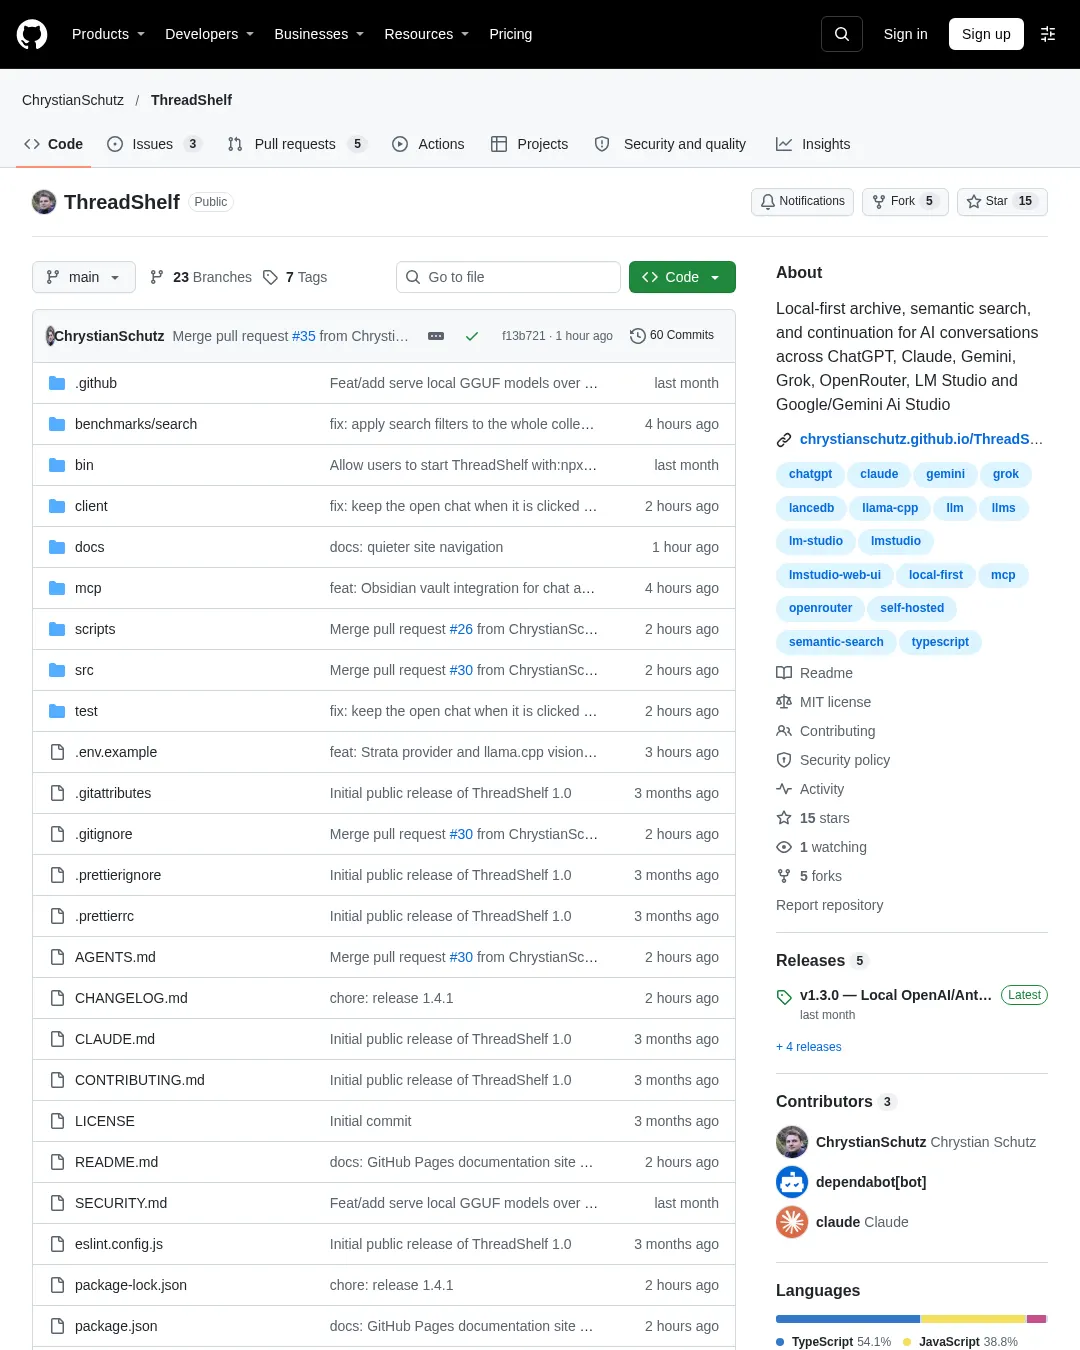
ThreadShelf는 ChatGPT, Claude, Google AI Studio, OpenRouter, LM Studio, Grok에서 내보낸 대화를 한곳에 보관하고 의미 검색으로 찾는 로컬 우선 도구다. 전체 대화 열람과 Markdown 내보내기, 로컬 GGUF 모델을 통한 대화 이어쓰기를 지원하며 웹 UI·CLI·HTTP API·MCP가 같은 색인을 사용한다.
대화 파일 파싱, 임베딩 생성, LanceDB 저장, 검색, HTTP API, MCP는 로컬에서 실행된다. 생성 기능은 선택 사항이다. llama.cpp는 루프백에서만 동작하며, 명시적으로 선택하는 OpenRouter는 선택한 대화 맥락과 새 프롬프트를 기기 밖으로 보낸다. 이 도구는 단일 사용자용 로컬 애플리케이션이다.
공식 배포 경로는 GitHub 저장소와 threadshelf npm 패키지(npx threadshelf)뿐이다. 설치 프로그램이나 .exe, .zip 파일은 제공하지 않는다. 다른 경로에서 발견한 설치 파일은 프로젝트가 배포한 것이 아니라고 안내한다. 자세한 설명은 문서에서 볼 수 있다.
가져오기와 검색
내보내거나 복사한 대화 파일을 지정하면 ThreadShelf가 공통 형식으로 파싱하고 로컬 임베딩을 만들어 LanceDB에 저장한다. 웹 UI에서 자연어로 의미 검색을 하거나, 정확한 문자열 검색으로 오류 메시지·식별자·코드 조각을 찾을 수 있다. 결과를 열면 일치한 대화 조각뿐 아니라 전체 원본 대화를 볼 수 있고, Markdown이나 JSON으로 내보낼 수 있다. 같은 색인을 MCP 클라이언트에서도 조회할 수 있다.
지원 소스별 내보내기 방식과 형식 안정성은 다음과 같다.
- Google AI Studio: Google Drive의
Google AI Studio폴더를 내려받는다. 형식은 문서화되지 않았으며 2026년 7월 형식을 시험했다. - OpenRouter: 저장소에 포함된 브라우저 콘솔 스크립트로 내보낸다. 형식은 문서화되지 않았다.
- LM Studio: 로컬 대화 파일을 복사한다. 문서화되지 않은 형식이며 0.4.x에서 시험했다.
- Grok / xAI: 계정 데이터 내보내기에서
prod-grok-backend.json을 가져온다. 형식은 문서화되지 않았다. - ChatGPT / OpenAI: 공식 데이터 내보내기의
conversations.json을 사용한다. 형식은 반안정적(semi-stable)이다. - Claude / Anthropic: 공식 데이터 내보내기를 사용한다. 형식은 반안정적이다.
Google AI Studio, OpenRouter, LM Studio, Grok의 내보내기 형식은 안정적으로 문서화되지 않아 제공업체가 예고 없이 바꿀 수 있다. ThreadShelf는 특정 버전의 스냅샷을 기준으로 시험했으므로 새 버전에서 파싱이 깨질 수 있다. 문제가 생기면 익명화한 예시와 함께 이슈를 제출하라고 안내한다.
필요한 제공업체의 데이터만 가져오면 된다. 내보낸 파일은 원하는 폴더에 둔 뒤 해당 폴더를 ThreadShelf에 지정한다. Google AI Studio 데이터는 Google Drive의 Google AI Studio 폴더를 내려받아 압축을 풀고 색인한다. 파일에 .json 확장자가 없어도 내용으로 감지한다. 2026년 7월 Drive 내보내기 형식의 텍스트 대화와 Imagen 프롬프트 기록을 지원하지만, 형식은 문서화되지 않았으며 바뀔 수 있다.
OpenRouter는 일괄 내보내기를 제공하지 않는다. 저장소의 전체 대화용 스크립트는 사이드바의 대화를 순회해 대화마다 JSON 파일을 내려받고, 현재 대화용 스크립트는 열려 있는 대화 하나만 내보낸다. 전체 대화를 받으려면 로그인한 상태로 openrouter.ai에서 대화 목록을 보이게 한 다음 DevTools의 Console을 열고 scripts/openrouter-export-all.js 전체 내용을 붙여넣어 실행한다. 스크립트는 각 대화를 열고 전체 기록을 불러오도록 스크롤한 뒤 JSON을 내려받는다. 브라우저가 요청하면 여러 파일 다운로드를 허용해야 한다. 선택자는 현재 OpenRouter 채팅 UI에 맞춰져 있으며 test/playwright/openrouter-export.spec.js에서 시험한다. 화면 구조가 바뀌어 대화를 찾지 못하면 이 테스트의 계약을 갱신해야 한다.
내보내기 JSON의 예시는 다음과 같다.
{
 "platform": "openrouter",
 "exportedAt": "2026-05-24T12:00:00.000Z",
 "pageTitle": "OpenRouter chat title",
 "sourceUrl": "https://openrouter.ai/chat/...",
 "turns": [
 { "role": "user", "content": "User message text" },
 { "role": "assistant", "content": "Assistant reply", "model": "optional/model-name" }
 ]
}
색인하기 전에 다음 명령으로 파일을 확인할 수 있다.
npm run parse -- path/to/openrouter-export.json
자세한 내용과 제한은 OpenRouter 내보내기 문서에 있다.
LM Studio는 대화마다 JSON 파일 하나를 로컬에 저장하므로 별도 내보내기 과정이 필요 없다. Windows 경로는 %USERPROFILE%\.lmstudio\conversations\, macOS와 Linux는 ~/.lmstudio/conversations/다. 이전 버전은 ~/.cache/lm-studio/conversations/도 확인한다. 경로를 수동 폴더 입력란에 넣어 색인하거나 먼저 복사할 수 있다.
# macOS / Linux
cp -r ~/.lmstudio/conversations ~/lmstudio-export

# Windows (PowerShell)
Copy-Item "$env:USERPROFILE\.lmstudio\conversations" "$env:USERPROFILE\lmstudio-export" -Recurse
파일 이름은 <id>.conversation.json 형식이다. 파서는 messages[].versions[currentlySelected]를 읽고 thinking 단계와 답변을 나눈다. 대화 폴더와 하위 폴더를 재귀적으로 탐색한다. LM Studio 0.4.x(0.4.16)에서 시험했으며 형식은 문서화되지 않아 바뀔 수 있다. LM Studio의 로컬 서버인 router는 로드된 모델에 요청을 전달하는 OpenAI 호환 추론 엔드포인트다. ThreadShelf는 서버가 아니라 디스크의 conversations/ 파일을 색인하므로 기록을 가져오거나 검색할 때 서버를 실행할 필요가 없다.
ChatGPT에서는 Settings → Data controls → Export data로 데이터를 요청한다. 이메일로 받은 압축 파일 안의 conversations.json을 색인한다. Claude에서는 Settings에서 데이터를 내보낸 뒤 대화 JSON을 색인한다. Grok에서는 xAI 계정·개인정보 설정에서 데이터 내보내기를 요청하고, export_data/.../ 아래에 있는 prod-grok-backend.json을 포함한 폴더를 지정한다. 파일은 내용으로 감지되므로 상위 디렉터리 이름은 상관없다. 파서는 conversations[].responses[].response를 읽어 agent_thinking_traces의 추론 기록과 message 답변을 분리한다. 타임스탬프는 MongoDB 확장 JSON 형식이며 파일 형식은 문서화되지 않았다.
설치와 기본 사용
필요한 환경은 Node.js 20.19 이상과 npm이다.
npx threadshelf # 다운로드하고 실행한 뒤 http://localhost:3000을 연다
이것으로 설치가 끝난다. 패키지에 미리 빌드한 웹 UI가 들어 있어 컴파일하거나 저장소를 복제할 필요가 없다. 다른 포트를 쓰려면 npx threadshelf 3001을 실행하고, 나머지 옵션은 npx threadshelf --help에서 확인한다. 터미널 도구도 함께 제공된다.
npx threadshelf search "what did I decide about caching?"
npx threadshelf ingest ./my-exports my-collection
npx threadshelf parse ./chatgpt-export.json
npx threadshelf-mcp # stdio MCP server
아카이브는 npm 패키지 안에 저장되지 않는다. npx 설치 디렉터리는 언제든 삭제될 수 있지만, 데이터는 사용자별 디렉터리에 보관돼 npm 캐시를 지우거나 패키지를 업그레이드해도 색인이 유지된다. Windows 기본 경로는 %LOCALAPPDATA%\ThreadShelf, macOS와 Linux는 ~/.threadshelf다. --data-dir <path> 또는 THREADSHELF_DATA_DIR로 경로를 바꿀 수 있고, npx threadshelf --where로 실제 경로를 확인한다. LANCEDB_PATH, UPLOADS_DIR 등 더 구체적인 설정은 기본 경로보다 우선한다.
저장소를 복제해 실행할 수도 있다.
npm install # 서버와 클라이언트를 npm workspaces로 설치한다
npm run build:client # React UI를 public/에 빌드한다
npm start # http://localhost:3000에서 제공한다
저장소 체크아웃은 기존처럼 데이터를 저장소 내부의 .lancedb/, .threadshelf/, .collections.json에 둔다. 복제본과 npx 설치는 서로 같은 파일을 사용하지 않는다.
MCP 클라이언트에서는 로컬 stdio 서버를 실행한다.
npm run mcp
서버는 색인 데이터 목록, 통계 조회, 의미·정확 검색, 전체 대화 가져오기 등을 위한 아카이브 도구 다섯 개와 Obsidian 보관함 검색·읽기·생성·수정 도구 네 개를 제공한다. 복제한 저장소에서 설치하는 방법, 클라이언트 설정, 보안 안내는 MCP 설정 문서를 참조한다.
웹 UI에서는 컬렉션을 만들거나 선택한다. 컬렉션은 ai_studio, chatgpt, work_2026처럼 폴더나 프로젝트에 해당하므로 처음에는 시험용 컬렉션을 쓰는 편이 낫다. 다음으로 내보낸 파일이 든 폴더를 선택하거나 절대 경로를 붙여 넣고, Index folder를 누른다. 자연어로 검색하고 user, thinking, response 역할 필터를 적용할 수 있다. 식별자·오류 메시지·코드처럼 임베딩이 뭉뚱그릴 수 있는 문자열은 Semantic에서 Exact로 바꿔 대소문자를 구분하지 않는 부분 문자열 검색을 쓴다. 결과를 누르면 원본 전체 대화를 열 수 있으며 복사하거나 Markdown·JSON으로 내보낼 수 있다.
진행 중 Stop indexing을 누르면 색인을 취소한다. 현재 임베딩 배치는 안전하게 끝나며, 완료된 파일은 색인에 남는다. 커밋하지 않은 파일은 기존 색인 행을 유지한다. 첫 색인에서는 로컬 임베딩 모델을 한 번 내려받느라 시간이 걸리고, 이후에는 캐시를 사용한다. UI 개발에는 npm run dev(백엔드)와 npm run dev:client(Vite 핫 리로드, 포트 5173, API는 3000으로 프록시)를 사용한다.
예약된 로컬 백업이나 화면 없이 색인하려면 다음 명령을 쓴다.
npm run ingest -- path/to/exports work_2026
컬렉션을 생략하면 chunks를 사용한다. 색인 전에 컬렉션을 비우려는 경우에만 --clear를 추가한다. LM Studio가 대화 중 파일을 다시 쓰거나 AI Studio 폴더가 커지는 상황처럼 변경을 계속 반영하려면 --watch를 붙인다.
npm run ingest -- ~/.lmstudio/conversations lmstudio -- --watch
첫 작업 뒤에도 프로세스가 실행 상태로 남아 폴더와 하위 폴더를 감시하고, 변경된 파일만 다시 색인한다. 재색인 지연은 --debounce <ms>로 조정한다. 원본 파일을 삭제해도 색인에서는 대화를 지우지 않는다. ThreadShelf는 아카이브이므로 색인한 대화가 원본 파일보다 오래 남는다.
터미널 검색 예시는 다음과 같다.
npm run search -- "that regex for polish postal codes"
npm run search -- "ECONNREFUSED 127.0.0.1" -- --mode keyword --n 5
npm run search -- "prompt injection" -- --collection work_2026 --json
위 예시에서 위치 인수 뒤에 --를 한 번 더 쓰는 것은 의도적이다. 최신 npm 버전에서는 그렇지 않으면 위치 인수 뒤의 옵션 이름을 npm이 가져갈 수 있다. 전체 안내는 시작하기 문서에 있다.
검색 결과를 누르면 전체 원본 대화가 열리고 일치한 대화 차례로 이동할 수 있다. 사용자·추론·응답 역할을 필터링하고 텍스트를 복사하거나 Markdown·JSON으로 내보낼 수 있다. 검색어가 비어 있으면 제공업체 표시와 함께 모든 색인 대화가 나오며 최근순·길이순·제목순으로 정렬하고 필터 상자를 사용할 수 있다. More like this는 결과나 대화 차례를 바탕으로 의미 검색을 다시 한다. 저장 검색은 검색어와 필터·모드를 함께 저장해 다시 실행하고, 고정한 대화는 목록 상단에 둔다. 두 기능의 데이터는 브라우저 localStorage에만 저장된다.
대화 생성과 로컬 모델
생성은 선택 기능이며 색인과 검색에는 필요하지 않다. 원본 내보내기 파일은 수정하지 않는다. New chat으로 ThreadShelf에 새 대화를 저장하거나, 가져온 대화를 열어 Continue this conversation을 선택한다.
llama.cpp · local은 기본 엔진이다. ThreadShelf는 GGUF 파일을 찾아 루프백 전용llama-server를 실행하고 토큰을 스트리밍한다. CPU·GPU·혼합 실행을 표시하며 모델을 삭제하지 않고 메모리에서 내릴 수 있다.OpenRouter · external은 실시간 모델 목록을 제공하는 선택형 외부 서비스다. 이 탭을 고르면 기기 밖으로 보내는 선택임을 모델 버튼의off-device표시와 입력창 안내로 알린다. 보관된thinking차례는 전송에서 제외한다. 선택 가능한 제공업체 가운데 ZDR 전용 라우팅과 데이터 수집 거부 라우팅을 적용하면 전송 대상을 줄일 수 있다.
완료한 대화와 아카이브 이어쓰기는 로컬에 저장되고 임베딩돼 검색할 수 있다. 유령 아이콘의 Private conversation은 현재 브라우저 탭에만 존재하며 대화 저장소나 의미 색인에 기록되지 않는다. 다만 OpenRouter를 선택하면 해당 대화는 기기 밖으로 전송된다. 실패하거나 중단된 스트림은 현재 탭에서 확인할 수 있는, 저장되지 않은 복구 카드로 남는다.
모델 메뉴는 일반적인 LM Studio·llama.cpp·Hugging Face 모델 디렉터리와 사용자 지정 경로를 찾는다. 모델 선택과 컨텍스트·출력 설정은 분리돼 있고, 즐겨찾기와 요청 시에만 표시하는 상세 실행 로그를 지원한다. 스트리밍 중에는 모델 임대(lease)를 유지해 응답 도중 다른 작업이 모델을 내리거나 설정을 바꾸지 못하게 한다.
ThreadShelf는 GGUF 모델을 LM Studio와 Ollama가 사용하는 OpenAI·Anthropic 호환 API로도 제공한다. SDK나 도구를 http://localhost:3000/v1에 연결하고, GET /v1/models에서 모델 ID를 확인해 요청한다. API 요청은 아카이브에 저장되지 않는다.
curl http://localhost:3000/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "Bielik-11B-v3.0-Instruct.Q8_0", "messages": [{"role": "user", "content": "Cześć!"}]}'
엔드포인트는 /v1/chat/completions, /v1/completions, /v1/responses, /v1/messages이며 스트리밍을 지원한다. 요청에 지정한 모델은 첫 사용 때 로드되고 메모리에 있던 모델을 대체하며, 이전 모델의 VRAM은 먼저 해제된다. GET /v1/models는 현재 로드된 모델에 "loaded": true를 표시한다. 모델은 다른 모델을 요청할 때까지 유지된다. POST /v1/models/unload나 Eject로 내릴 수 있고, 설정에 따라 일정 시간 유휴 상태 뒤 자동으로 내릴 수도 있다. 기본값은 자동 해제 안 함이다.
인증 키가 없으면 같은 컴퓨터의 프로그램이 API에 접근할 수 있다. 설정에서 API 키를 지정하면 모든 요청에 키가 필요하다. 네트워크 포트를 열어 /v1만 다른 기기에 제공하거나 API를 끌 수도 있다. Settings → Conversation generation → Local model API에서 주소·모델 ID·복사 가능한 예시와 설정을 확인한다. 안내 페이지는 현재 상태와 설정을 쉬운 말로 설명하고 Claude Code, Codex CLI, DeepSeek Harness 연결법을 제공한다. 자세한 내용은 로컬 모델 API와 성능 문서에 있다.
첫 로컬 생성 설정을 시작하면 Settings → Conversation generation → Set up local generation이 이 컴퓨터에 맞는 공식 llama.cpp 빌드와 감지한 가속기에 맞는 크기의 GGUF 모델을 한 번에 계획한다. 내려받기 전에 URL·SHA-256 다이제스트·크기·저장 위치를 보여주며, 사용자가 한 번 확인해야 작업이 시작된다. 확인 전에는 아무것도 내려받지 않고, 취소하면 진행 중인 전송도 즉시 멈춘다.
확인 시 서버가 계획을 다시 계산한다. 클라이언트가 서버에 임의 URL을 전달해 내려받고 실행하게 할 수는 없다. 다시 계산한 계획이 승인한 내용과 다르면(예: nightly 빌드 이동, 카탈로그 변경, 여유 VRAM 변화에 따른 추천 변경) 다운로드하지 않고 새 계획을 보여줘 다시 확인받는다.
Settings → Conversation generation → Download a model… 또는 채팅의 모델 메뉴에서 공개 Hugging Face API를 검색할 수 있다. 계정이나 토큰 없이 모델을 검색하고 다운로드 수·좋아요·인기·최신순으로 정렬하며, 저장소의 양자화 버전을 살펴보고 하드웨어에 맞는지도 확인한다. 판정은 가속기 예산 안에 들어감, 빠듯해 일부를 CPU에서 실행함, 너무 큼으로 표시한다. unsloth, lmstudio-community, bartowski, ggml-org, Qwen, google, mistralai 등 알려진 게시자의 빌드에는 표시를 붙인다.
다운로드 파일은 기본적으로 .threadshelf/models에 저장되며 THREADSHELF_MODELS_PATH로 경로를 바꿀 수 있다. 이 디렉터리는 Git에서 제외되고 항상 모델 검색 경로에 포함된다. 다운로드한 모델은 별도 설정 없이 모델 메뉴에 나타나며 완료 후 자동 선택된다. 각 파일은 배치되기 전에 저장소의 LFS oid(SHA-256)와 대조해 검증한다. 취소한 다운로드는 .part 파일로 남아 다음 시도에서 이어받고, 다른 실패가 발생하면 임시 파일을 삭제한다.
접근 제한된 저장소는 미리 감지해 UI에 표시한다. 사용하려면 Hugging Face에서 라이선스를 수락하고 Git에서 제외되는 루트 .env에 HF_TOKEN을 설정한다. 토큰을 설정하면 모든 Hugging Face 요청에 전송된다. 토큰이 없어도 공개 저장소는 사용할 수 있다. 대화 내용은 Hugging Face로 보내지 않으며, 전송되는 것은 카탈로그 메타데이터 요청과 파일 다운로드뿐이다.
llama.cpp 설치와 보안 설정
앞선 안내형 설치가 일반적인 사용 방법이다. CLI 설치기는 스크립트 실행, 오프라인 환경, 사용자 지정 빌드에 쓰며, ThreadShelf가 직접 확인하지 않은 아카이브를 설치하는 유일한 방법이다. Windows x64·ARM64, macOS x64·Apple Silicon, Linux x64·ARM64에서 공식 릴리스 자산이 있는 경우 사용할 수 있다. 인수 없이 실행하면 llama-server가 있는지만 찾으며 네트워크 요청·다운로드·설치·실행은 하지 않는다.
npm run setup:llama
최신 호환 공식 릴리스는 아카이브를 받지 않고 확인할 수 있다.
npm run setup:llama -- -- --check
현재 공식 ggml-org/llama.cpp 릴리스를 설치한다. 대화형 설치에서는 install을 입력해야 하고 자동화할 때는 명시적으로 --yes를 지정한다. 공식 GitHub SHA-256 다이제스트를 검증하고 MIT 라이선스·소스 메타데이터를 설치 파일 옆에 둔다.
npm run setup:llama -- -- --install
npm run setup:llama -- -- --install --yes
Upstream의 /releases/latest는 바이너리가 없는 semver 릴리스를 가리키므로, ThreadShelf는 nightly-tag.txt의 포인터를 따라 실제 bNNNNN 빌드를 찾는다. --release로 정확한 빌드를 고정할 수 있고, 익명 API 호출 제한에 걸리면 GITHUB_TOKEN을 설정한다.
npm run setup:llama -- -- --install --release b10088
기본 빌드는 이식 가능한 CPU 빌드이며 macOS에서는 Metal을 자동 사용한다. --variant vulkan|cuda|rocm|sycl로 가속 공식 빌드를 선택할 수 있지만 드라이버·런타임 요구 사항이 적용된다. 공식 변형은 릴리스와 변형별 폴더에 나란히 설치돼 GPU 빌드를 추가해도 기존 CPU 빌드를 덮어쓰지 않는다. 빌드가 둘 이상이면 원하는 변형의 llama-server 경로를 Settings에 붙여 넣는다. 자동 탐색은 같은 릴리스에서 최신 관리 빌드를 우선하고 CPU보다 가속기 변형을 우선한다. 직접 지정한 실행 파일이 있으면 그 설정이 우선한다.
공식 Windows CUDA 릴리스는 서버와 CUDA 런타임 DLL을 서로 다른 두 아카이브에 나눠 둔다. CUDA 설치 명령은 두 파일을 모두 내려받아 SHA-256을 확인한다. 승인한 같은 명령을 다시 실행하면 GGUF 모델에는 손대지 않고, 런타임 파일이 빠진 이전 ThreadShelf CUDA 디렉터리를 복구한다.
npm run setup:llama -- -- --install --variant cuda
Alpine, 지원하지 않는 아키텍처, 사용자 지정 빌드에는 직접 아카이브 URL을 지정한다. --url을 제공하는 것은 다운로드에 대한 명시적 동의이며, 가능하면 신뢰할 수 있는 SHA-256도 지정한다.
npm run setup:llama -- -- --url https://example.invalid/llama-build.tar.gz --sha256 64_HEX_DIGEST --tag custom
기본 설치 위치는 Git에서 제외되는 .threadshelf/tools/다. 이 설치기는 모델을 내려받지 않는다. 기존 GGUF 디렉터리와 선택한 llama-server 경로는 Settings → Conversation generation에서 추가한다.
OpenRouter 키는 Git에서 제외되는 루트 .env에 OPENROUTER_API_KEY로 설정하는 것이 권장된다. .env.example을 복사한 뒤 서버를 다시 시작한다. UI에 입력한 키는 현재 서버 프로세스 메모리에만 있으며 .threadshelf/generation.json에 기록되거나 API 응답에 포함되지 않는다.
생성 설정, 생성한 대화 저장, 모델 해제, 채팅 엔드포인트는 읽기·검색 UI를 HOST와 ALLOWED_HOSTS로 노출해도 루프백 전용이다. 전체 설정, 저장 방식, 라우팅 제어, 실행 진단, API 예시는 대화 생성 문서에 있다.
Obsidian과 Markdown 메모
사이드바에서 Markdown/Obsidian을 열고 Obsidian 보관함, Logseq 그래프, OpenClaw 작업 공간 또는 일반 .md 폴더를 연결할 수 있다. 컴퓨터에서 찾은 Obsidian 보관함과 OpenClaw 작업 공간은 한 번의 클릭으로 연결할 수 있도록 제안된다. 메모를 로컬 검색하고 원본을 Obsidian에서 열며 페이지에서 새 메모를 만들 수 있다. 대화에서 Notes 도구를 켜면 선택한 모델이 제한된 도구 호출 절차로 메모를 검색·읽기·생성·수정한다.
Obsidian에서 ThreadShelf와 AI로 이어지는 흐름은 UI·HTTP API·MCP를 통한 실시간 키워드 검색과 메모 읽기다. 상대 경로와 원본 Markdown을 제공한다. 반대 방향으로는 Markdown 메모를 만들거나, 출처 링크가 포함된 대화 요약을 에이전트에 작성하게 할 수 있다. 기존 메모는 수정 시 리비전 확인을 거친다.
보관함 쓰기는 기본적으로 꺼져 있다. 쓰기를 Markdown/Obsidian 페이지나 입력창 옆에서 켜기 전에는 연결한 보관함이 MCP 클라이언트에도 읽기 전용이다. 다른 보관함으로 바꾸면 쓰기 허용이 다시 꺼진다. 삭제는 항상 대화를 멈추고 모델과 정확한 파일을 보여주는 체크박스·확인을 요구한다. 승인한 삭제는 보관함의 .trash로 옮기고, 취소하면 파일을 보존한다. MCP는 검색·읽기·생성·수정을 제공하지만 삭제는 대화 UI에서만 할 수 있다.
설정된 보관함 안의 일반 .md 파일만 접근할 수 있다. 숨김 폴더·첨부 파일·심볼릭 링크·junction·경로 이탈은 제외한다. 새 메모 생성은 기존 파일을 덮어쓰지 않는다. 검색은 다시 가져오기를 하지 않고 현재 파일을 읽는다. 의미 기반 메모 색인과 자동 프로젝트 내보내기는 향후 작업이다.
로컬 llama.cpp를 사용하면 메모 맥락은 기기에 남는다. OpenRouter와 외부 MCP 모델은 검색된 메모 내용을 기기 밖으로 보낼 수 있다. 비공개 대화도 명시적으로 허용한 보관함 쓰기를 할 수 있다. 도구·제어·API 경로·제한은 Obsidian 통합 문서에 있다.
적용 범위와 다른 도구
ThreadShelf는 대화 아카이브 검색과 이어쓰기, 제한된 Obsidian 도구 흐름에 초점을 둔다. 일반적인 워크플로 자동화, 자동 사실 메모리, 아카이브 인용을 포함한 답변 생성은 향후 방향이다. MCP 클라이언트는 이미 검색·대화 읽기 도구로 맥락을 가져올 수 있지만, 외부 모델을 쓰는 클라이언트는 그 맥락을 기기 밖으로 보낼 수 있다. 에이전트 오케스트레이션, 문서 RAG, 연구 노트가 필요하면 해당 분야의 도구가 더 넓은 기능을 제공한다.
문서 비교는 2026-10-03에 연결된 upstream 자료를 바탕으로 검토한 스냅샷이며 LibreChat 문서는 Latest / dev로 표시돼 있다. 설치된 릴리스·설정·확장 기능은 달라질 수 있다.
- LibreChat은 여러 제공업체의 채팅과 에이전트를 지원한다. 대화 기록은 키워드로 검색하고 업로드 파일은 의미 검색으로 찾는다. ChatGPT·Claude·ChatbotUI v1 가져오기, 에이전트, MCP 도구, 분기, 아티팩트가 있으며 사용자 메모리는 대화 검색과 별도로 구조화된 항목을 저장한다. 프로젝트, 검색, 가져오기, 에이전트, 메모리.
- Open WebUI는 자체 호스팅 채팅·지식·도구에 초점을 둔다. ChatGPT 및 기본 채팅 가져오기와 문서 RAG를 제공하며 로컬·외부 모델 연결, 메모리, 확장형 도구를 지원한다. 기능 문서, 가져오기, RAG.
- AnythingLLM은 비공개 문서 작업 공간과 에이전트용이다. 작업 공간 문서를 검색하며 청크 선택과 재정렬을 설정할 수 있다. 데스크톱·자체 호스팅 앱, 로컬·외부 모델, 에이전트 흐름, MCP 도구를 제공한다. 프로젝트, 문서 검색.
- MyChatArchive는 AI 클라이언트용 로컬 대화 아카이브다. ChatGPT·Claude·Grok·Claude Code·Cursor를 가져오고 로컬 의미·키워드 검색을 제공한다. 요약에는 선택적으로 외부 LLM을 쓴다. CLI와 MCP 서버, 대화 그룹, 민감도 등급, 주제 맥락 묶음이 있다. 프로젝트.
- hstry는 코딩 에이전트와 웹 채팅의 통합 기록을 다룬다. 가져온 에이전트 세션과 웹 채팅 기록을 전문 검색하며 CLI·TUI·MCP·API, 소스 검색, 브라우저 동기화, 에이전트 간 세션 재개를 제공한다. 프로젝트.
- Polylogue는 AI 작업의 근거와 감사 기록에 초점을 둔다. 가져온 대화·코딩 세션을 검색하고 원본에 있는 경우 도구 실행 결과, 계보, 사용량, 비용을 구조화해 보존한다. 로컬 아카이브·CLI·Python API·HTTP 읽기 API·MCP 서버를 제공한다. 프로젝트.
- Open Notebook은 소스와 메모 중심의 연구 노트다. 연구 자료에서 전문·벡터 검색을 하고 출처를 인용해 답한다. 로컬·외부 모델 설정, 소스 변환, 메모, REST API를 제공한다. 프로젝트.
개인정보, 임시 대화와 한계
임시 대화는 New chat 옆의 유령 아이콘을 눌러 Private conversation으로 시작한다. 내용은 현재 탭의 브라우저 sessionStorage에만 머물고 아카이브에 저장되거나 색인되지 않으며 생성 진단도 저장되지 않는다. OpenRouter를 선택하면 내용은 기기 밖으로 전송된다. 자세한 내용은 대화 생성 문서를 참조한다.
색인·임베딩·저장·검색·MCP·llama.cpp 추론은 로컬에서 실행한다. 사용자가 명시적으로 OpenRouter 생성을 선택하면 선택한 아카이브 또는 ThreadShelf 대화의 사용자·어시스턴트 기록과 프롬프트를 OpenRouter와 라우팅된 제공업체에 보낸다. 네트워크에 연결되는 다른 두 기능인 llama.cpp 빌드용 GitHub Releases와 모델 카탈로그·GGUF 파일용 Hugging Face에는 사용자가 요청한 경우에만 접근하며 대화 내용은 보내지 않는다.
실제 대화 내보내기, 업로드 파일, 로컬 데이터베이스, .threadshelf/, 로그, 임시 폴더를 Git에 커밋하지 말아야 한다. .gitignore가 이를 제외하며 npm run check:repo도 이런 경로가 커밋 후보가 되면 거부한다. test/fixtures/에는 합성·익명화 데이터만 둔다. 자세한 내용은 보안 문서에 있다.
현재 버전으로 색인한 대화는 원본 파일을 이동·수정·삭제해도 검색·목록·전체 대화 보기가 유지된다. 색인 시 정규화된 대화 차례를 벡터와 함께 저장하기 때문이다. 이전 버전으로 색인한 컬렉션은 다시 색인할 때까지 원본 파일 경로에서 대화를 읽는다. 일반적인 사용에서 큰 아카이브를 지원하지만, 청크가 10만 개를 넘는 컬렉션은 정확한 통계에 의존하기 전에 자체 데이터로 확인해야 한다. 문서화되지 않은 제공업체 형식은 예고 없이 바뀔 수 있으므로, 파싱이 깨지는 실제 형식이 있다면 익명화한 작은 테스트 자료를 유지하라고 안내한다.
HTTP API에는 사용자 계정이나 인증이 없다. 신뢰할 수 있는 네트워크에서 의도적으로 호스트를 설정한 경우가 아니라면 루프백에 바인딩해야 한다. 네트워크에서 아카이브가 아니라 로컬 모델만 공유하려면 Local model API 설정의 Serve on the local network를 사용한다. LAN 접근을 위해서는 필요한 인터페이스에 바인딩하고 정확한 브라우저 호스트를 허용해야 한다. 예를 들면 HOST=0.0.0.0 ALLOWED_HOSTS=192.168.1.50,my-pc.local이다. ALLOWED_HOSTS가 없으면 다른 컴퓨터에서 온 API 요청은 Host/Origin 검사로 거부된다. 자세한 내용은 네트워크 접근 문서에 있다.
기타 기능과 개발 정보
Insights 화면은 가져올 때 수집한 자료로 아카이브 전체의 시간별 활동, 주요 모델, 제공업체별 대화 차례, 가장 긴 대화를 그래프로 보여준다. 한 컬렉션 또는 모든 컬렉션을 대상으로 볼 수 있으며 어두운 테마도 제공한다.
MCP 서버는 웹 UI·HTTP API와 같은 로컬 색인을 stdio로 제공해 Claude Desktop 등 MCP 지원 도구가 이전 대화를 검색하게 한다.
npx threadshelf mcp # 설치된 패키지 실행; npx threadshelf-mcp와 같다
npm run mcp # 저장소 복제본에서 실행
게시된 패키지를 쓰는 Claude Desktop 설정 예시는 다음과 같다.
{
 "mcpServers": {
 "threadshelf": {
 "command": "npx",
 "args": ["-y", "threadshelf-mcp"]
 }
 }
}
저장소 복제본을 사용하는 설정은 다음과 같다.
{
 "mcpServers": {
 "threadshelf": {
 "command": "npm",
 "args": ["run", "mcp", "--silent"],
 "cwd": "/absolute/path/to/this/repo"
 }
 }
}
MCP는 UI와 같은 로컬 LanceDB를 읽으므로 별도 설정이 필요 없다. 제공 도구는 MCP 문서에 정리돼 있다.
컬렉션은 로컬 LanceDB 테이블이며 폴더나 프로젝트처럼 쓴다. 대화는 파싱한 내보내기 파일에서 전체 기록을 재구성한다. 검색은 일치한 청크를 반환하고 결과를 열면 전체 대화를 보여준다. 저장된 대화 스냅샷은 원본 파일을 옮기거나 다시 쓰거나 삭제한 뒤에도 색인 대화를 읽을 수 있게 한다. 생성 제공업체는 관리되는 llama.cpp와 OpenRouter에서 공통 스트리밍 규약을 사용하며, 대화별 임대와 쓰기 잠금으로 동시 저장과 모델 전환을 보호한다. 내부 구조는 아키텍처 문서에 있다.
ThreadShelf는 React 19 클라이언트와 Express 5 서버를 갖춘 npm workspaces 기반 TypeScript/ESM 프로젝트다. 테스트는 파싱·유니코드·청킹·검증·생성 설정과 실행 보조 기능·대화 저장·클라이언트 유틸리티를 확인하는 단위·회귀 테스트, 격리된 임시 LanceDB·업로드·컬렉션을 사용하는 실제 서버 API와 MCP E2E, 프로덕션 UI를 Chromium에서 확인하는 브라우저 E2E로 구성된다. 브라우저 검사는 검색·라우팅·컬렉션·업로드·생성 스트림·개인정보 표시·반응형 레이아웃을 다룬다. 저장소 검사는 Git·개인정보 위생, Markdown 링크, ESLint, TypeScript, 클라이언트 빌드와 전체 테스트를 포함한다. 모든 제공업체에는 작은 합성 픽스처가 있다. 실제 내보내기는 JSON 형식을 파악하는 데만 사용하며 비공개 대화 내용은 저장소에 복사하지 않는다. CI는 Linux에서 전체 검사를, Windows에서 핵심 검사를 실행한다.
기여할 때 파서·가져오기·검색 변경에 테스트를 추가하고 실제 내보내기 파일을 Git에 넣지 말며 PR 전에 npm run check를 실행한다. 자세한 내용은 기여 안내에 있다. 로컬 멀티모달 GGUF는 맞는 mmproj를 불러와 추론 API로 인라인 이미지를 받을 수 있다. 설정·예시·제한은 Vision 문서에 있다.
주요 스크립트는 npm start(3000 포트 서버, 다른 포트는 npm start -- 3001), npm run dev(파일 감시 서버), npm run dev:client(Vite UI 핫 리로드), npm run build:client(UI를 public/에 빌드), npm run check(저장소 검사·린트·타입 검사·단위 및 API/MCP E2E·빌드·Playwright), npm run check:repo(커밋 전 비공개 파일·비밀값 검사), npm test, npm run test:e2e, npm run test:playwright, npm run mcp, npm run parse -- <file> -- [flags], npm run ingest -- <folder> [collection] -- [flags], npm run search -- "<query>" -- [flags], npm run setup:llama, npm run build:package, npm run pack:verify다. 파싱 옵션은 --no-user, --no-thinking, --no-ai; 가져오기 옵션은 --clear, --watch, --debounce <ms>; 검색 옵션은 --mode keyword, --collection, --roles, --n, --json이다. npm run pack:verify는 패키지를 묶어 임시 디렉터리에 설치하고 부팅하는 npx 스모크 테스트를 한다. Playwright 브라우저가 없으면 npx playwright install chromium을 실행한다.
선택 환경 변수의 기본값과 용도는 다음과 같다.
PORT:3000, 서버 포트.HOST:127.0.0.1, 서버 호스트. 신뢰할 수 있는 LAN 접근이 필요할 때만 명시적으로 설정한다.ALLOWED_HOSTS: 빈 값, 신뢰하는 LAN 접근용 추가 Host/Origin 이름을 쉼표로 구분한다.THREADSHELF_DATA_DIR: 사용자별 기본값, 영구 데이터의 루트 경로.LANCEDB_PATH,UPLOADS_DIR,COLLECTIONS_PATH: 데이터 디렉터리, 각각 LanceDB·업로드 원본·수동 컬렉션 목록 파일 경로.CHUNK_MAX_CHARS:2000, 임베딩 청크당 최대 문자 수.CHUNK_OVERLAP_CHARS:100, 긴 청크 사이 겹치는 문자 수.EMBED_BATCH_SIZE:25, 가져오기 중 임베딩 배치 크기.GENERATION_CONFIG_PATH,MASTER_PROMPTS_PATH: 데이터 디렉터리, 비밀이 아닌 생성 설정과 저장된 시스템 프롬프트 경로.LLAMA_CPP_SERVER: 자동 탐색, 기존llama-server실행 파일의 절대 경로.LLAMA_CPP_BASE_URL: 빈 값, 기존 루프백 전용 서버 URL.LLAMA_CPP_CONTEXT_SIZE:8192, 관리형 로컬 서버 컨텍스트 크기.LLAMA_CPP_ACCELERATION:auto,cpu,gpu,hybrid,multi-gpu중 하나.LLAMA_CPP_GPU_LAYERS:20, 혼합 프로필에서 GPU로 보낼 정확한 레이어 수.LLAMA_CPP_SPLIT_MODE:layer, 다중 GPU 분할 방식layer또는row.LLAMA_CPP_MAIN_GPU:0, 해당 프로필의 주 GPU 번호.LLAMA_CPP_TENSOR_SPLIT: 빈 값, 예를 들어3,1같은 선택적 다중 GPU 비율.LLAMA_CPP_THREADS:-1, CPU 생성 스레드 수.-1이면 llama.cpp가 선택한다.LLAMA_CPP_FLASH_ATTENTION:auto,auto,on,off중 하나.LLAMA_CPP_IDLE_UNLOAD_MINUTES:0, 유휴 뒤 모델을 내릴 시간(분),0은 내리지 않음.THREADSHELF_API_KEY: 빈 값, 로컬 모델 API(/v1)에 필요한 키이며 Settings보다 우선한다.LLAMA_MODEL_PATHS: 기본 경로, 추가 모델 경로를 지정한다. Windows는;, macOS·Linux는:로 구분한다.THREADSHELF_TOOLS_PATH: 데이터 디렉터리, llama.cpp 검색·설치 경로.THREADSHELF_MODELS_PATH: 데이터 디렉터리, 카탈로그 다운로드 경로이며 모델 검색에 항상 포함된다.THREADSHELF_MODEL_CACHE: 데이터 디렉터리, 다운로드한 임베딩 모델 캐시.THREADSHELF_DISABLE_DEFAULT_MODEL_PATHS:0,1로 설정하면 명시한 경로만 탐색한다.HF_TOKEN: 빈 값, 접근 제한 저장소에만 필요한 Hugging Face 토큰.HUGGING_FACE_HUB_TOKEN은 대체 이름이다.GITHUB_TOKEN: 빈 값, llama.cpp 릴리스의 GitHub API 제한을 높인다.GH_TOKEN은 대체 이름이다.OPENROUTER_API_KEY: 빈 값, 브라우저에 노출되지 않는 OpenRouter 키이며.env에 설정할 수 있다.OPENROUTER_BASE_URL:https://openrouter.ai/api/v1, 주로 테스트용 재정의다.
데이터 디렉터리를 뜻하는 경로는 빠른 시작에 설명한 위치를 기본으로 한다. 값을 직접 설정하면 해당 값이 우선한다. 로컬 모델 API만 공유하고 아카이브를 공유하지 않는 방법은 로컬 모델 API 문서에 설명돼 있다.
추가 문서: 시작하기, 아키텍처, MCP 설정, OpenRouter 내보내기, 대화 생성, 로컬 모델 API, 성능, 실제 데이터 테스트, FAQ, 변경 기록, AI 코딩 에이전트·기여자 안내.
라이선스는 MIT다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요