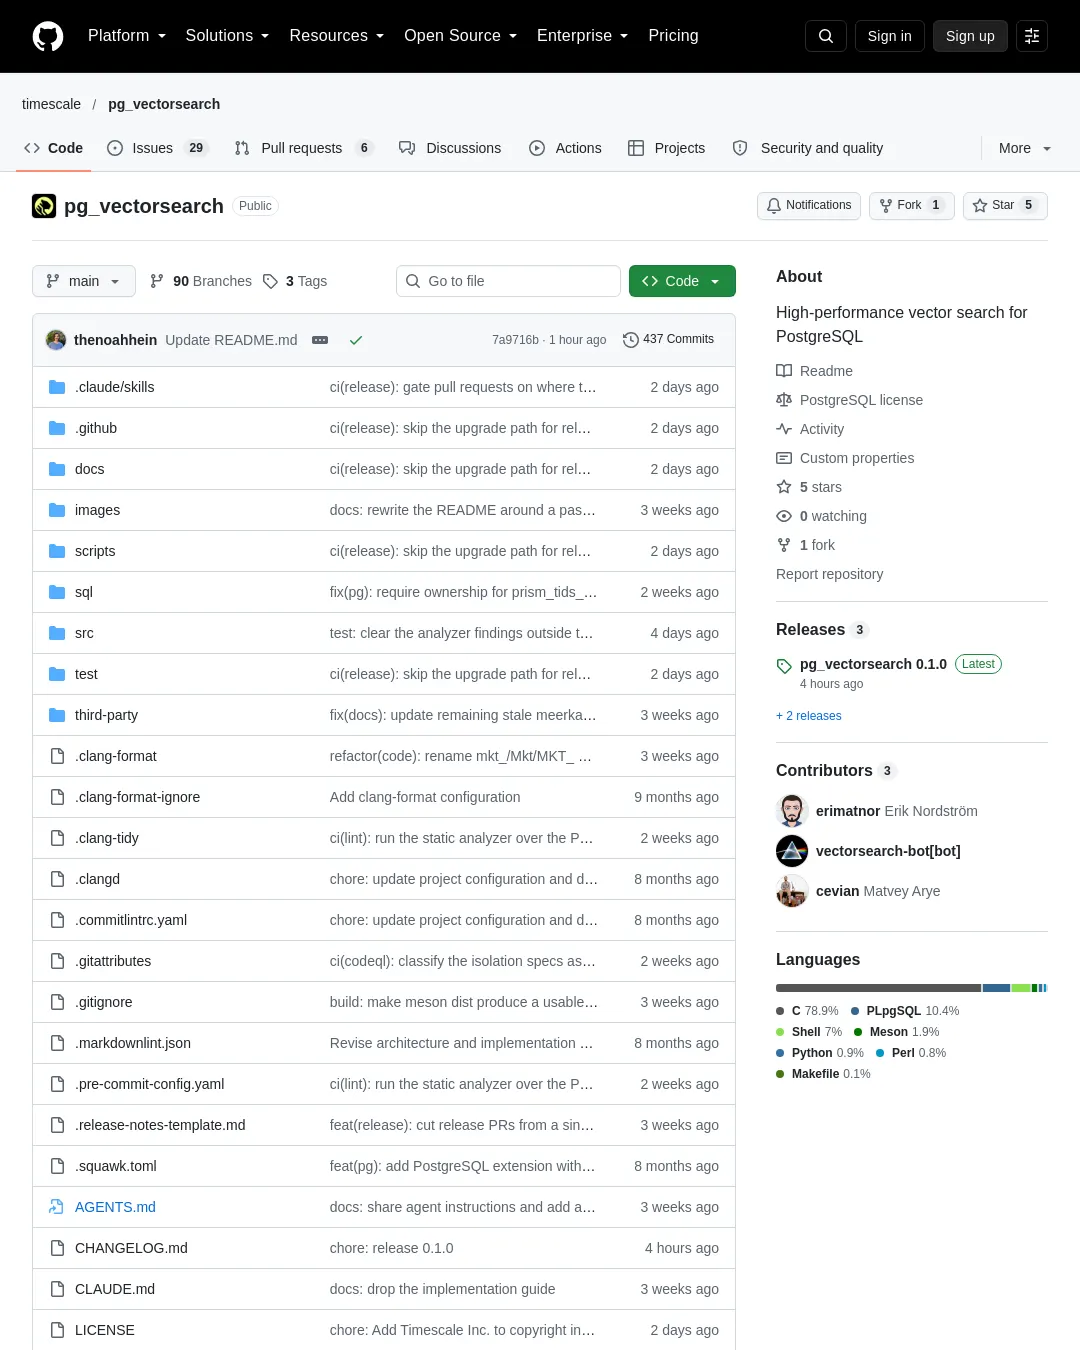
Timescale가 PostgreSQL에서 근사 최근접 이웃(ANN) 검색을 지원하는 오픈소스 확장 pg_vectorsearch를 공개했다. 현재 알파 단계로 테스트용이며, 운영 환경에서 사용하기에는 이르다. 사전 릴리스 간 업그레이드가 불가능할 수 있어 확장과 인덱스를 삭제한 뒤 다시 만들어야 할 수도 있다. 알려진 문제는 변경 기록에서 확인할 수 있다.
핵심 기능은 1억 개 이상 벡터를 대상으로 설계한 PRISM 인덱스다. 계층형 라우팅과 RaBitQ 양자화를 이용해 검색 후보를 좁히고, SIMD 최적화 거리 계산을 지원한다. 삽입·수정·삭제를 처리하며, 커진 포스팅 목록은 prism_rebalance로 나눌 수 있다.
프로젝트 측은 PRISM이 pgvector의 IVFFlat 및 HNSW보다 검색과 인덱스 구축에서 빠르다고 설명한다. 특히 1억 개 벡터 데이터셋에서 HNSW와 재현율이 같은 조건일 때, 메모리가 4분의 1인 인스턴스에서도 PRISM이 더 빨랐다고 밝혔다. 이는 프로젝트가 제시한 성능 주장으로, 제공된 자료에는 독립적인 검증 결과가 포함되지 않았다.
처음 사용하는 경우 확장 자체의 vec32 또는 vec16 열에 벡터를 저장할 수 있다. 기존 pgvector 사용자는 vector나 halfvec 열을 변경하거나 복사하지 않고 PRISM 인덱스를 추가할 수 있으며, 두 확장을 같은 스키마에 함께 설치할 수 있다. PostgreSQL 18 이상이 필요하고, 빌드에는 GNU C11 컴파일러와 Meson이 요구된다. RaBitQ 인코딩을 빠르게 하기 위한 CBLAS는 선택 사항이다.
설치·사용 방법과 제약은 프로젝트 저장소, 아키텍처 문서, 튜닝 안내, 유지보수 안내에서 확인할 수 있다.
부록: 원문 예시
Query Flow: 1. Traverse centroid tree to find nearest clusters (buffer cache) 2. Scan posting lists for candidates (buffer cache, async I/O) 3. RaBitQ two-stage filtering: estimate → error bound → rerank 4. Full-precision reranking from heap 5. Return k nearest neighbors
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요