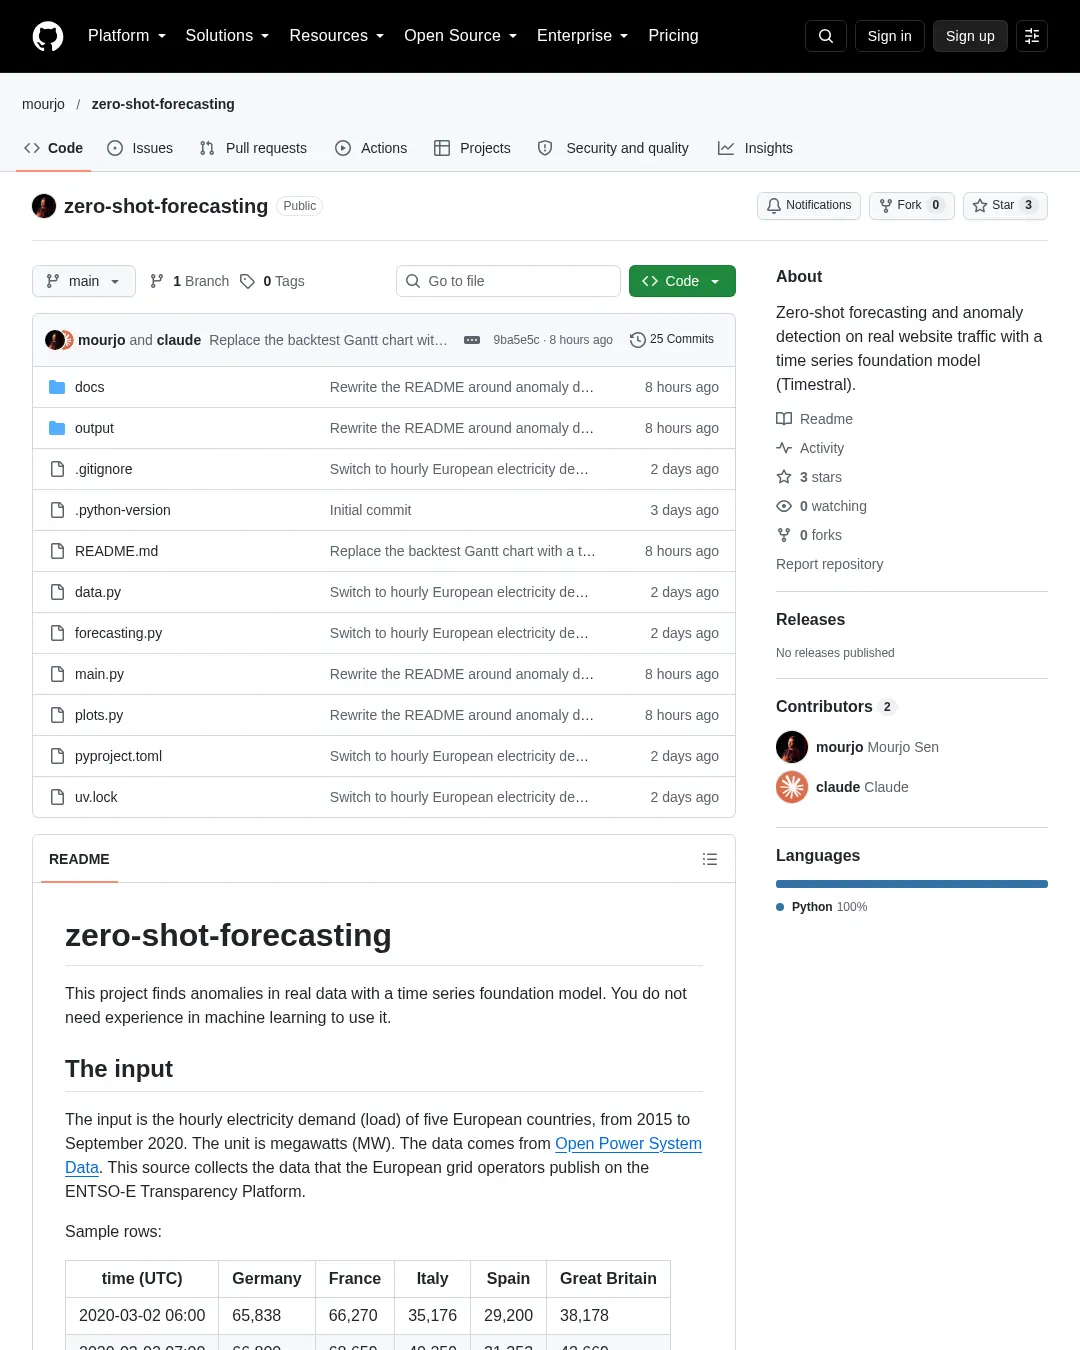
zero-shot-forecasting 프로젝트는 시계열 기반 모델 Timestral로 실제 데이터의 이상을 찾는 방법을 보여준다. 머신러닝 경험이 없어도 사용할 수 있도록 예측, 백테스트, 이상 탐지 절차와 실행 방법을 소개한다.
입력 데이터와 단순 규칙의 한계
프로젝트는 2015년부터 2020년 9월까지 유럽 5개국의 시간별 전력 수요(부하)를 사용한다. 단위는 메가와트(MW)이며, 데이터는 유럽 송전망 운영자들이 ENTSO-E Transparency Platform에 공개한 자료를 모은 Open Power System Data에서 가져왔다. 데이터는 시간마다 한 행씩, 총 50,400행이며 각 국가 열은 하나의 시계열이다.
| 시간(UTC) | 독일 | 프랑스 | 이탈리아 | 스페인 | 영국 |
|---|---|---|---|---|---|
| 2020-03-02 06:00 | 65,838 | 66,270 | 35,176 | 29,200 | 38,178 |
| 2020-03-02 07:00 | 66,800 | 68,659 | 40,259 | 31,353 | 42,669 |
| 2020-03-02 08:00 | 67,032 | 70,363 | 41,955 | 32,759 | 44,722 |
| 2020-03-02 09:00 | 67,977 | 70,442 | 42,109 | 33,539 | 44,679 |
| 2020-03-02 10:00 | 68,588 | 70,845 | 42,817 | 33,390 | 45,250 |
이 데이터에는 실제 이상 사례인 2020년 3월 코로나19 봉쇄 조치가 포함돼 있다. 프로젝트는 이를 이용해 탐지 결과를 살펴본다.
이탈리아의 봉쇄 시작일인 2020년 3월 10일 전후를 놓고 보면, 고정 임계값 규칙은 봉쇄와 일요일을 구분하지 못한다. 예를 들어 수요가 25,000MW 아래로 내려가면 알림을 보내는 규칙은 다음과 같은 문제를 낳는다.
- 수요는 하루 중에도 크게 변한다. 밤에는 21,000~25,000MW이고 정오에는 약 44,000MW다.
- 주말 수요는 평일보다 훨씬 낮다.
- 봉쇄 전에도 밤과 주말 때문에 전체 시간의 15%에 알림이 발생한다.
- 봉쇄 중 평일 오후 수요는 34,000MW였으므로 이 시간에는 알림이 발생하지 않는다.
임계값을 높이면 오탐이 늘고, 낮추면 봉쇄를 놓친다. 국가와 계절, 연도마다 다른 임계값도 필요하다.
이동 평균 규칙도 적절한 결과를 내지 못했다. 최근 일주일 평균에서 표준편차 2배 이상 벗어난 시간에 알림을 보내도록 하면 봉쇄 전후 모두 0%의 시간에만 알림이 발생했다. 하루 동안의 수요 변동이 커 표준편차가 약 6,000MW이고, 판정 범위가 약 24,000MW로 넓어 어느 시간도 범위 밖으로 나가지 않았기 때문이다. 평균이 수요 감소를 반영하는 데도 일주일이 걸린다. 기간을 짧게 하거나 범위를 좁히면 일일 주기를 따라가 아침마다 알림이 발생한다.
시간대별 주간 평균, 계절 분해, 공휴일 달력, 추세를 조합해 더 나은 모델을 만들 수는 있다. 하지만 시계열마다 모델을 조정해야 하고, 모니터링하는 지표가 바뀔 때마다 같은 작업을 다시 해야 한다. 프로젝트가 제시하는 대안은 시간대와 요일, 계절별 통상 패턴을 데이터만으로 학습하는 모델이다.
Timestral을 이용한 예측
대규모 언어 모델(LLM)은 사용 전에 방대한 텍스트로 학습하고, 프롬프트를 받으면 다음 텍스트를 생성한다. 시계열 기반 파운데이션 모델(TSFM)은 다양한 시계열 데이터로 학습한 뒤 새로운 시계열의 과거 값을 입력받아 다음 값을 예측한다. 프로젝트는 이를 제로샷 예측이라고 부른다. 사용자의 데이터로 모델을 훈련하거나 맞추거나 조정하지 않는다.
- LLM은 많은 텍스트를 학습 자료로 사용하고 프롬프트를 입력받아 다음 단어를 출력한다.
- TSFM은 다양한 시계열을 학습 자료로 사용하고 숫자 목록인 과거 데이터를 입력받아 다음 값과 불확실성 범위를 출력한다.
- 두 방식 모두 사용자의 데이터로 추가 학습하지 않는다.
프로젝트는 Mistral의 TSFM인 Timestral을 사용한다. 모델은 매개변수 2억900만 개이며 다운로드 용량은 837MB다. 공휴일은 전력 수요를 낮추고 날짜를 미리 알 수 있으므로 공휴일 정보를 추가 입력으로 제공한다. 그 밖의 정보는 모델이 과거 데이터에서 얻는다.
프로젝트에서 제시한 호출은 다음과 같다.
from timestral import TimestralForecaster

forecaster = TimestralForecaster.from_pretrained("mistralai/Timestral-209M")
result = forecaster.forecast(history, prediction_length=24) # history: (series, hours) array
result.quantile(0.5) # the best estimate for each of the next 24 hours
result.quantile(0.99) # the value that the model is 99% sure the demand stays below
프로젝트 설명에 따르면 머신러닝 경험이 없어도 되며, 특징을 설계하거나 모델을 선택하거나 매개변수를 조정할 필요가 없다. 명령은 모두 16GB 메모리를 갖춘 2020년형 M1 MacBook Air에서 실행했으며, GPU 없이 CPU로 모델을 구동했다.
각 명령은 먼저 124MB, 50,400행의 데이터 파일을 읽은 뒤 일부 과거 데이터를 모델에 전달한다. 입력값 하나는 한 국가의 한 시간 전력 수요이며, 각 시간에 해당하는 공휴일 값(0 또는 1)도 함께 입력한다.
| 명령 | 기능 | 모델 입력 | 모델 출력 | 실행 시간 |
|---|---|---|---|---|
main.py forecast | 5개국의 다음 30일 예측 | 32,768시간씩 5개 예측, 총 163,840개 값 | 3,600시간(720 × 5) | 42초 |
main.py backtest | 5개국의 하루 앞 예측 30회 수행 | 2,048시간씩 150개 예측, 총 307,200개 값 | 3,600시간(720 × 5) | 54초 |
main.py anomalies | 5개국의 1년간 주간 예측 | 2,048시간씩 260개 예측, 총 532,480개 값 | 43,680시간(8,736 × 5) | 96초 |
예측을 확인하고 이상을 찾는 방법
프로젝트는 같은 모델을 예측, 백테스트, 이상 탐지의 세 방식으로 사용한다.
예측에서는 현재까지의 과거 데이터를 입력해 다음 30일의 시간별 수요를 예측하고, 각 시간의 예상 범위를 함께 얻는다. 제시된 예측은 하루와 한 주의 패턴을 이어가며, 미래 날짜가 멀수록 범위가 넓어진다. 독일의 첫 주말은 다른 주말보다 수요가 낮게 예측되는데, 10월 3일 토요일이 공휴일이기 때문이다.
백테스트는 미래 예측을 아직 실제 값과 비교할 수 없으므로 과거 한 달을 대상으로 한다. 모델에 해당 기간의 데이터를 보여주지 않고 예측한 다음 실제 수요와 비교한다. 2020년 9월의 각 날짜에 대해 전날 08:00에 예측을 만들고, 그 시점까지의 12주 데이터만 사용한다. 송전망 운영자도 같은 시점에 예측을 발표해야 한다.
예를 들어 9월 10일 목요일의 예측은 9월 9일 수요일 08:00에 만든다. 모델은 그 시점까지의 12주 데이터를 보고, 예측 대상 날짜인 9월 10일의 실제 수요는 보지 않는다. 같은 방식으로 다른 날짜도 처리한다.
| 예측 시각 | 모델이 보는 데이터 | 실제 수요와 비교하는 날 |
|---|---|---|
| 8월 31일 월요일 08:00 | 8월 31일 월요일 08:00까지의 12주 | 9월 1일 화요일 |
| 9월 1일 화요일 08:00 | 9월 1일 화요일 08:00까지의 12주 | 9월 2일 수요일 |
| 9월 2일 수요일 08:00 | 9월 2일 수요일 08:00까지의 12주 | 9월 3일 목요일 |
| … | … | … |
| 9월 29일 화요일 08:00 | 9월 29일 화요일 08:00까지의 12주 | 9월 30일 수요일 |
각 예측은 전날 08:00까지의 가장 최근 수요를 사용하며, 비교 대상 날짜의 데이터는 모델에 들어가지 않는다. 프로젝트는 이 방식으로 모델이 변화를 빠르게 따라갈 수 있다고 설명한다.
30일 백테스트 결과는 다음과 같다.
- 독일, 프랑스, 이탈리아, 스페인의 평균 오차는 1.5~2.2%였고, 영국은 4.8%였다.
- 독일과 영국에서는 오차가 송전망 운영자 예측보다 작았다. 운영자들은 기상 예보를 사용하지만 Timestral은 사용하지 않는다.
- 실제 값의 79~89%가 80% 예측 범위 안에 들어왔다. 프로젝트는 이를 범위가 적절하다는 결과로 제시한다.
이상 탐지는 백테스트에서 예측값과 범위를 신뢰할 수 있다고 본 뒤, 모델이 예상하지 못한 값을 이상으로 취급한다. 절차는 다음과 같다.
- 과거 데이터를 주 단위로 나눈다.
- 각 주에 대해 그 주가 시작되기 전의 시간 데이터만 사용해 예측한다.
- 실제 수요가 1~99% 범위를 6시간 이상 벗어난 날을 이상으로 표시한다.
국가별 규칙이나 조정 없이 모델이 찾은 사례는 이탈리아, 프랑스, 스페인, 영국의 봉쇄 첫 주, 2020년 5월 프랑스의 재개방에 따른 수요 증가, 공휴일 달력에 없는 날들이다. 마지막 사례에는 크리스마스 주간과 이탈리아의 8월 휴업 기간이 포함된다.
팬데믹 이전에는 시간의 약 1%가 예측 범위보다 높았고 약 1%가 범위보다 낮았다. 프로젝트는 이 비율이 적절하며 오탐 알림을 지나치게 많이 내지 않는다고 설명한다.
소프트웨어 모니터링에 적용할 수 있는 영역
소프트웨어 시스템의 시계열에도 일간·주간 주기, 공휴일, 완만한 성장과 급격한 변화가 나타난다. 프로젝트는 TSFM을 다음과 같은 용도로 활용할 수 있다고 제안한다.
- 고정 임계값 없는 알림: 요청 수, 지연 시간, 오류율, 대기열 길이, CPU와 메모리를 모니터링하고 해당 시간대의 예상 범위를 벗어날 때 알림을 보낸다. 그러면 평소의 월요일 최고치나 일요일 최저치가 알림을 유발하지 않는다.
- 비즈니스 지표: 가입, 구매, 결제, 로그인 등을 모니터링한다. 결함 있는 결제 버튼 때문에 생긴 작은 감소가 증가보다 중요할 수도 있다.
- 다수 지표: 지표마다 별도로 설정하지 않고 수천 개 지표를 모니터링한다. 이 프로젝트의 5개국 시계열처럼 모든 시계열을 한 배치에 넣는다.
- 느린 변화: 메모리 누수, 계속 늘어나는 대기열, 출시 후 성능의 완만한 저하를 찾는다. 봉쇄 사례처럼 하루가 아니라 일주일 예측을 활용한다.
- 용량과 비용: 트래픽, 저장 공간, 클라우드 비용을 다음 몇 주 동안 예측하고 단일 값뿐 아니라 범위도 확인한다.
- 출시 영향: 출시 전 데이터에서 모델이 예상한 값과 출시 후 지표를 비교한다.
- 예정된 이벤트: 공휴일처럼 출시, 할인 행사, 유지보수 날짜를 미리 모델에 제공한다.
다만 TSFM은 변화가 발생한 이유를 알려주지 않으며, 입력으로 제공하지 않은 이벤트도 알지 못한다.
실행 방법
프로젝트의 빠른 시작 명령은 다음과 같다.
uv sync # installs timestral from GitHub, and pandas, matplotlib, holidays
uv run main.py signal # the chart above: fixed threshold and moving average (no model)
uv run main.py forecast
uv run main.py backtest
uv run main.py anomalies
처음 실행할 때 데이터(124MB)는 data/에, 모델(837MB)은 Hugging Face 캐시에 내려받는다. 각 명령은 요약을 표시하고 CSV 파일이나 차트를 output/에 저장한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요