Thinking Machines의 Tinker가 LoRA 미세조정용 옵티마이저 Dimuon을 지원한다. 업체는 일부 지도 미세조정(SFT) 실험에서 Dimuon이 AdamW보다 적은 스텝으로 더 낮은 손실에 도달했고, 스텝 시간은 비슷했다고 설명한다. 강화학습(RL)만 수행한 실험에서는 두 옵티마이저의 학습 효율이 비슷했다.
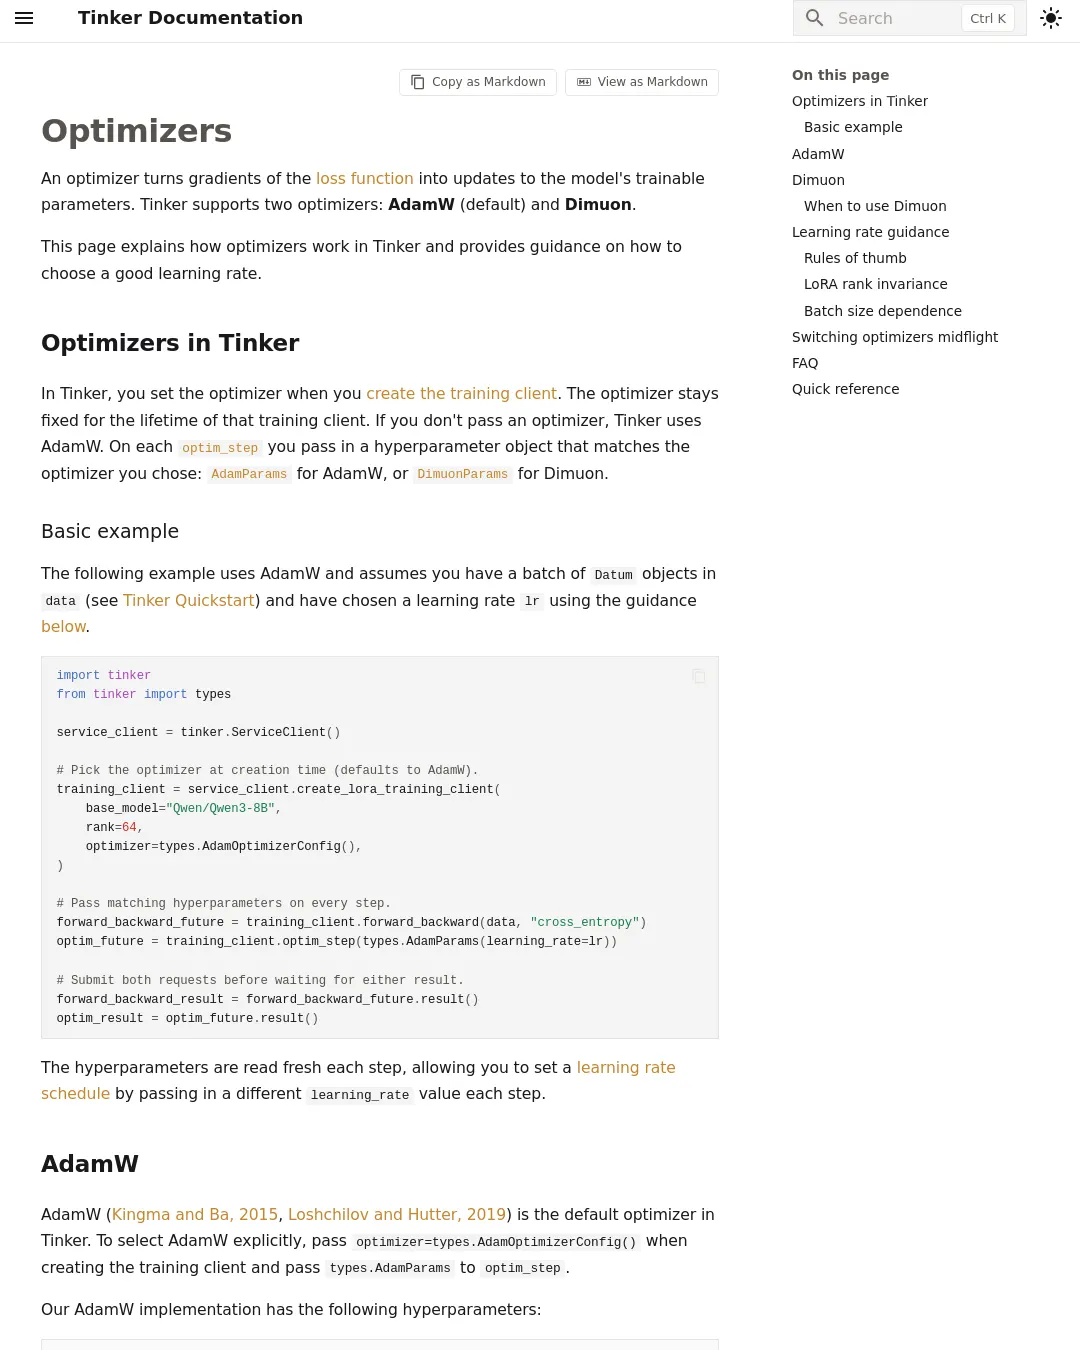
Tinker는 기본값으로 AdamW를 사용한다. 학습 클라이언트를 만들 때 types.DimuonOptimizerConfig()를 지정하고, 각 optim_step 호출에 types.DimuonParams를 전달하면 Dimuon을 쓸 수 있다. 옵티마이저는 해당 클라이언트가 유지되는 동안 바꿀 수 없다. 다른 옵티마이저로 전환하려면 체크포인트에서 새 학습 클라이언트를 만들어야 하며, 이때 가중치는 불러오지만 옵티마이저 상태는 새로 시작한다. 같은 옵티마이저 상태까지 이어서 학습하려면 create_training_client_from_state_with_optimizer를 사용한다.
Tinker 문서는 Dimuon의 학습률을 AdamW보다 보통 10~100배 높게 설정하라고 권한다. 업체의 실험에서는 SFT에 AdamW 학습률의 약 15배, RL에는 약 60배가 적절했지만, 알맞은 배율은 모델과 작업에 따라 다르다. beta1은 0.9로 두고 그래디언트 클리핑은 끈 상태에서 학습률을 조정하는 것을 권장한다.
업체는 SFT 단계가 큰 작업에는 Dimuon으로 전환하고, SFT 뒤 RL에서도 계속 Dimuon을 쓰는 방안을 권한다. RL만 수행한다면 AdamW와 Dimuon 중 어느 쪽도 괜찮다는 설명이다. 일부 SFT 실험에서는 Dimuon이 LoRA rank를 높였을 때 AdamW보다 더 큰 이점을 보였다. 업체는 최종 선택을 자체 평가로 확인하라고 안내한다.
두 옵티마이저 모두 학습률은 매 스텝 새로 전달할 수 있어 학습률 스케줄을 적용할 수 있다. Tinker 문서는 SFT에서 배치 크기의 제곱근에 비례해 학습률을 조정하는 것을 경험칙으로 제시한다. 배치 크기를 4배로 늘릴 때 학습률을 2배로 시험하는 방식이다. RL에서는 sqrt(num_problems)에 따라 조정해 볼 수 있다고 덧붙인다. 학습률 조정과 감쇠는 사용자가 직접 관리해야 한다.
체크포인트를 저장할 때 save_state는 Adam의 이동 평균 같은 옵티마이저 상태를 포함하지만, save_weights_for_sampler는 포함하지 않는다. 학습률 스케줄이 스텝 수에 의존한다면 스텝 카운터도 학습 코드에서 저장하고 복원해야 한다. 자세한 설정은 Tinker 옵티마이저 문서에서 확인할 수 있다.
부록: 원문 예시
import tinker from tinker import types service_client = tinker.ServiceClient() # Pick the optimizer at creation time (defaults to AdamW). training_client = service_client.create_lora_training_client( base_model="Qwen/Qwen3-8B", rank=64, optimizer=types.AdamOptimizerConfig(), ) # Pass matching hyperparameters on every step. forward_backward_future = training_client.forward_backward(data, "cross_entropy") optim_future = training_client.optim_step(types.AdamParams(learning_rate=lr)) # Submit both requests before waiting for either result. forward_backward_result = forward_backward_future.result() optim_result = optim_future.result()
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요