2026년 10월 9일
clz와 ctz는 고정 크기 정수에서 각각 앞쪽 또는 뒤쪽에 이어지는 0비트의 개수를 계산하는 명령어다. 최신 CPU는 이를 하드웨어에서 지원하지만, 항상 빠른 것은 아니다. 예를 들어 Arrow Lake에서 tzcnt의 지연 시간은 3이다.
작업 중인 FPU 에뮬레이터에서 ctz를 사용하다가 부동소수점 연산으로 이를 피하는 방법을 알아냈다. 이 방법을 조금 돌아가는 방식으로 벡터화 가능한 ctz 대체 구현으로 확장할 수 있다는 점도 알게 됐다. 완전성을 위해 clz도 구현했다.
CLZ
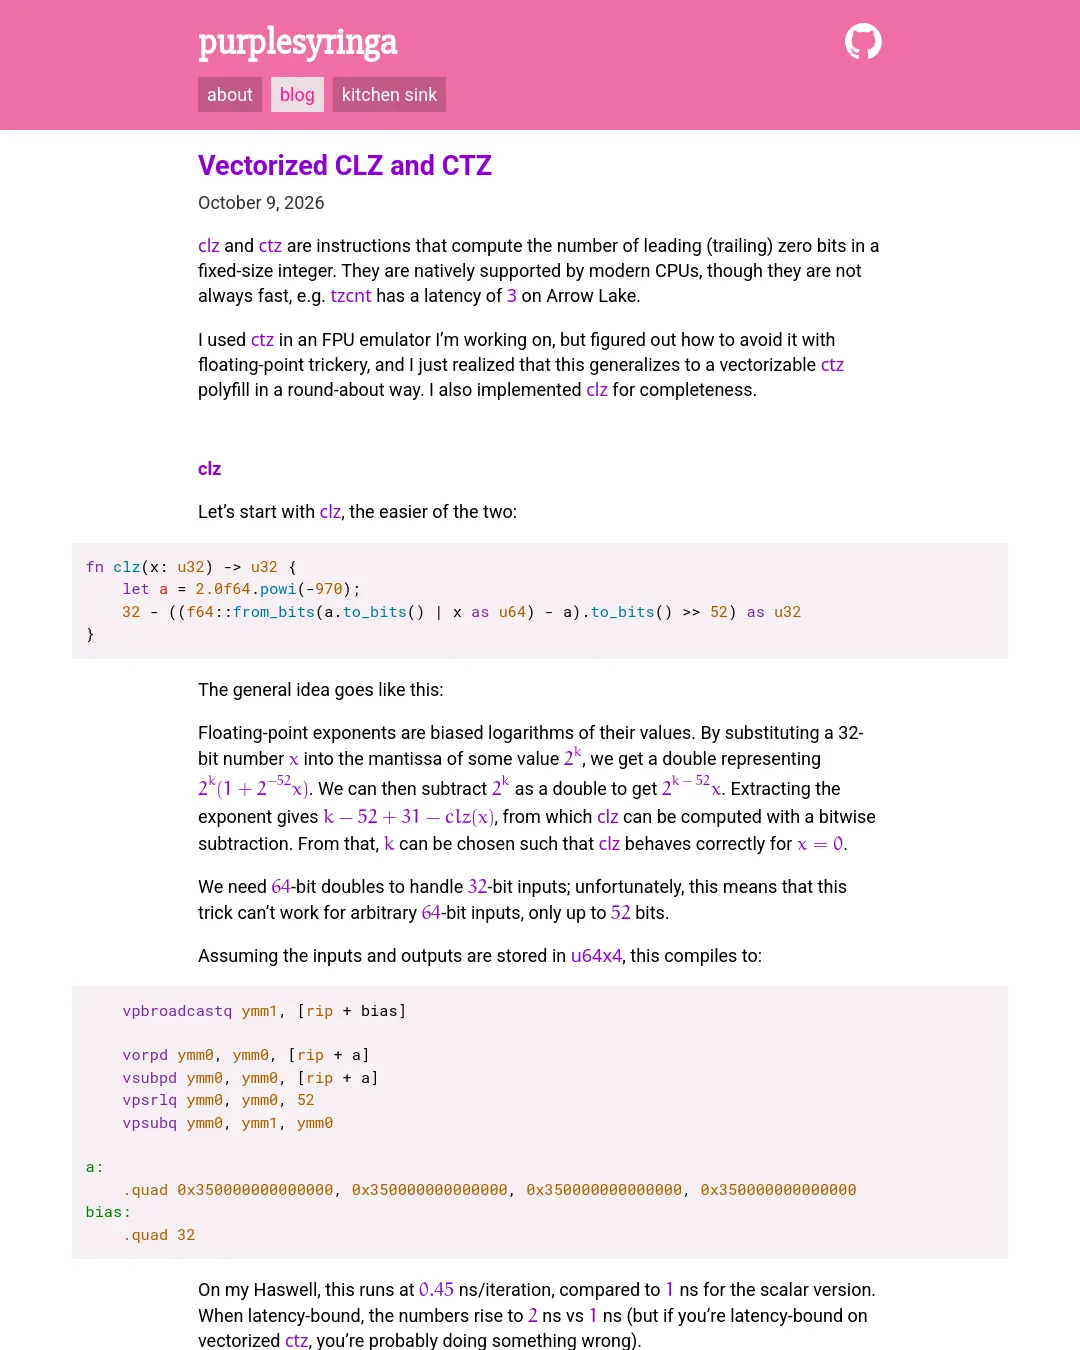
먼저 더 간단한 clz부터 살펴보자.
fn clz(x: u32) -> u32 {
 let a = 2.0f64.powi(-970);
 32 - ((f64::from_bits(a.to_bits() | x as u64) - a).to_bits() >> 52) as u32
}
핵심은 부동소수점 지수가 값의 로그에 편향값을 더한 형태라는 점이다. 어떤 값 2ᵏ의 가수에 32비트 수 x를 대입하면, 2ᵏ(1+2⁻⁵²x)를 나타내는 배정밀도 부동소수점 수를 얻는다. 여기서 2ᵏ를 빼면 2ᵏ⁻⁵²x가 된다. 지수를 추출하면 k−52+31−clz(x)가 나오므로, 비트 뺄셈으로 clz를 계산할 수 있다. 이때 x=0에서도 clz가 올바르게 동작하도록 k를 선택할 수 있다.
32비트 입력을 다루려면 64비트 부동소수점 수가 필요하다. 따라서 이 기법은 임의의 64비트 입력에는 적용할 수 없고, 최대 52비트 입력까지만 처리할 수 있다.
입력과 출력을 u64x4에 저장한다고 가정하면 다음 어셈블리 코드로 컴파일된다.
vpbroadcastq ymm1, [rip + bias]

 vorpd ymm0, ymm0, [rip + a]
 vsubpd ymm0, ymm0, [rip + a]
 vpsrlq ymm0, ymm0, 52
 vpsubq ymm0, ymm1, ymm0

a:
 .quad 0x350000000000000, 0x350000000000000, 0x350000000000000, 0x350000000000000
bias:
 .quad 32
Haswell에서는 반복당 0.45ns가 걸렸다. 스칼라 버전의 1ns보다 빠른 수치다. 지연 시간에 묶인 경우에는 벡터 버전이 2ns, 스칼라 버전이 1ns로 수치가 높아진다. 다만 벡터화한 ctz에서 지연 시간이 병목이라면 다른 문제가 있을 가능성이 높다.
Ian Qvist가 Alder Lake에서 시험한 결과는 반복당 0.29ns로, 스칼라 버전의 0.85ns보다 빨랐다. 지연 시간에 묶인 경우에는 각각 1.3ns와 0.85ns였다. 최신 Intel CPU에서는 같은 수준이거나 더 나은 결과가 나올 것으로 예상된다.
AMD CPU에서는 lzcnt가 매우 저렴하므로 스칼라 버전이 더 빠를 가능성이 높다. 다만 Zen CPU는 AVX-512도 지원하므로 vplzcntd를 사용할 수도 있다.
CTZ
이제 ctz를 살펴보자.
fn ctz(x: u32) -> u32 {
 let a = f64::from_bits((0x340000100000001 ^ x as u64) ^ (x as u64 + u32::MAX as u64))
 - f64::from_bits(0x340000000000000);
 (a.to_bits() >> 52) as u32
}
먼저 x⊕(x−1)을 계산해 가장 낮은 위치의 1비트만 분리한다. ctz는 그 값의 로그와 같으므로, 비트 연산으로 2ᵏ를 더하고 배정밀도 부동소수점 수에서 2ᵏ를 빼는 방식으로 이를 구한다. 그런 다음 지수를 확인한다. k를 적절히 정하면 지수에 편향되지 않은 ctz 값이 들어간다.
가수에 2³²를 미리 섞고 x−1 대신 x+2³²−1을 사용해 x=0을 처리한다. 또한 가수에 1을 미리 섞어 홀수 x에서 a가 0이 되도록 하고, 느린 서브노멀 수를 만들지 않게 한다. 이 구성을 맞추는 데 얼마나 시간을 들였는지 상상할 수 있을 것이다.
이 함수는 다음과 같이 컴파일된다.
vpxor ymm1, ymm0, [rip + c1]
 vpaddq ymm0, ymm0, [rip + u32_max]
 vpxor ymm0, ymm1, ymm0
 vsubpd ymm0, ymm0, [rip + c2]
 vpsrlq ymm0, ymm0, 52

c1:
 .qword 0x340000100000001, 0x340000100000001, 0x340000100000001, 0x340000100000001
u32_max:
 .qword 0xffffffff, 0xffffffff, 0xffffffff, 0xffffffff
c2:
 .qword 0x340000000000000, 0x340000000000000, 0x340000000000000, 0x340000000000000
Haswell에서는 반복당 0.49ns, 지연 시간에 묶인 경우 2.3ns가 걸렸다. Alder Lake에서는 각각 0.35ns와 1.3ns였다. clz보다 느린 것은 명령어를 하나 더 사용하기 때문이다. AVX-512가 있으면 vpternlogq를 사용해 이 차이를 없앨 수 있지만, 그 정도라면 (x - 1) & !x에 vpopcntd를 사용하는 편이 나을 수도 있다. 스칼라 버전은 clz와 다르게 동작하지 않는다.
De Bruijn 수열을 이용한 대안
이후 Nikolay Malkovsky가 De Bruijn 수열을 이용하는 또 다른 벡터화 방법을 제안했다. 몇 가지 시험을 거쳐 다음 코드를 얻었다.
const char table[32] = {
 0, 4, 5, 6, 11, 9, 7, 12, 15, 3, 10, 8, 14, 2, 13, 1,
 0, 4, 5, 6, 11, 9, 7, 12, 15, 3, 10, 8, 14, 2, 13, 1,
};
__m256i bit = _mm256_andnot_si256(x, _mm256_sub_epi32(x, _mm256_set1_epi32(1)));
__m256i high = _mm256_madd_epi16(
 _mm256_cmpeq_epi16(bit, _mm256_set1_epi16(-1)),
 _mm256_set1_epi16(-16)
);
__m256i index = _mm256_srli_epi32(_mm256_mullo_epi32(bit, _mm256_set1_epi32(0xf0a6f0a7)), 28);
__m256i low = _mm256_shuffle_epi8(_mm256_loadu_si256((__m256i*)table), index);
return _mm256_add_epi32(low, high);
vpshufb는 16바이트 레인을 넘나들 수 없으므로, 실제 32바이트 룩업 테이블을 사용할 수 없다. 대신 설명하기 까다로운 방식을 사용한다. 요지는 16비트 De Bruijn 수열을 두 번 반복해 ctz의 하위 4비트를 계산하고, 어느 절반이 0인지에 따라 16 또는 32를 더하는 것이다. 0xf0a6f0a7은 이 방식이 작동하게 하는 네 가지 매직 상수 중 하나다.
이 방식은 Haswell에서 1ns, Alder Lake에서 0.7ns가 걸린다. 처리량은 두 배이므로 셔플을 줄이는 데 도움이 된다면 부동소수점 기반 방식보다 조금 빠를 수 있다.
x=0을 처리할 필요가 없거나 ctz(0)의 결과를 32가 아닌 0으로 하고 싶다면 다음 코드를 사용하면 실행 시간을 0.82ns로 줄일 수 있다.
__m256i high = _mm256_and_si256(
 _mm256_cmpgt_epi32(bit, _mm256_set1_epi32(0x7fff)),
 _mm256_set1_epi32(16)
);
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요