TL;DR
- VeriQuote는 인용문과 출처를 대조하는 매처(matcher), 인용문과 주장을 대조하는 판정기(judge)를 결합해 서로 다른 유형의 잘못된 인용을 차단하는 검증 파이프라인임.
- 매처는 주장을 무시하고 인용문이 출처에 있는지 확인하며, 판정기는 출처 일부를 맥락으로 참고하지만 인용문이 실제로 출처에 있는지는 확인하지 않음.
- 예시 인용문과 이를 설명하는 출처 텍스트는 데모용으로 작성됐으며, 해당 텍스트에 나오는 임상시험은 허구임.
- 벤치마크는 매처용으로 생성한 수천 개의 인용문, 판정기용으로 사람이 라벨링한 인용, 인용 지침을 따른 4개 오픈 응답 모델을 사용하며 저장소에서 재실행 가능함.
- VeriQuote는 종속성 없는 TypeScript 라이브러리 및 CLI이며 MIT 라이선스로 제공됨.
여덟 가지 인용 예시
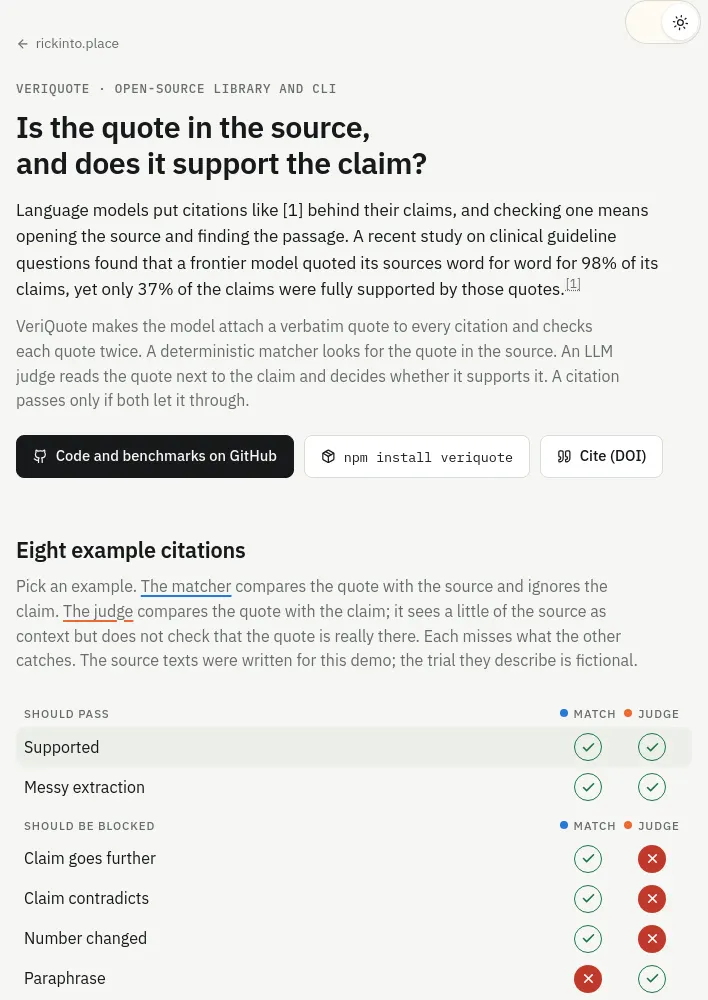
- 예시를 선택하면 매처는 인용문과 출처를 비교하고 주장은 무시함.
- 판정기는 인용문과 주장을 비교하며, 출처 일부를 맥락으로 보지만 인용문이 실제로 출처에 있는지는 확인하지 않음.
- 두 검사는 서로 다른 오류를 포착함. 출처 텍스트는 이 데모를 위해 작성됐으며, 텍스트가 설명하는 임상시험은 허구임.
- 인터페이스 항목: 출처, 매처, 인용문, 판정기, 답변의 주장, 판정기 응답, 텍스트 편집.
- 판정기 실행 설정: 엔드포인트, 모델, API 키, 판정기 실행.
- 매처는 입력 중에도 다시 실행되며, 판정기에는 모델이 필요함. 브라우저 요청을 허용하는 OpenAI 호환 엔드포인트를 사용할 수 있으며, 예시로 OpenRouter가 제시됨.
- API 키는 현재 브라우저 탭에 남고 해당 엔드포인트로만 전송됨.
벤치마크 결과
- 위 예시는 수작업으로 선정됐지만, 아래 결과는 매처용으로 생성한 수천 개의 인용문, 판정기용으로 사람이 라벨링한 인용, 인용 지침에 따라 응답한 오픈 응답 모델 4개를 바탕으로 함.
- 모든 결과는 저장소에서 다시 실행할 수 있으며, 표시 위에 마우스를 올리면 수치를 확인할 수 있음.
잘못된 인용 유형별 탐지 검사
- 각 오류 유형에 대해 차단된 잘못된 인용의 비율을 표시함. 두 검사 중 하나라도 차단하면 해당 인용은 차단된 것으로 집계됨.
- 비교 항목: 매처, 판정기, 두 검사 결합.
- 오류 유형: 만들어낸 인용문, 실제 인용문에 잘못된 주장을 붙인 경우.
매처의 인용문 점수 산정
- 매처가 충실한 인용문, 변경된 인용문, 누락된 인용문에 부여하는 점수를 비교함.
- 임계값은 통과해야 하는 기준과 판정기의 역할, 실패해야 하는 기준으로 표시됨.
- 점은 중앙값이며 선은 최저값부터 최고값까지의 범위임.
판정기 모델과 사람의 평가 비교
- 각 판정기는 ALCE의 동일한 주장–출처 쌍 240개를 온도 0에서 평가했으며, 판정 결과를 사람 평가자의 결과와 비교함.
- ‘탐지’는 사람 평가자가 근거가 없다고 표시한 인용 중 판정기가 완전히 뒷받침된다고 판정하지 않은 비율임. 두 패널 모두 값이 높을수록 좋음.
- 세로선은 ALCE가 인용을 자동 평가하는 데 사용하는 특화된 자연어 추론(NLI) 모델 TRUE를 나타냄.
- 의사결정 모델과 로그 확률 판정기는 텍스트 대신 단일 토큰과 클래스 확률을 반환함.
- 비교 설정 항목: 추론 켜기/끄기, 측정값, 95% 신뢰 구간.
인용문이 실제 출처에 있으며 주장을 뒷받침하는지
- 정렬 기준을 선택할 수 있음.
- ‘그대로 인용’은 인용문이 실제로 출처에 있다는 뜻이며, ‘완전히 뒷받침됨’은 판정기가 주장의 모든 세부 내용을 인용문에서 확인했다는 뜻임.
- 모든 수치를 표로 표시하는 옵션이 있음.
출처와 구현
- VeriQuote는 종속성 없는 TypeScript 라이브러리 및 명령줄 인터페이스(CLI)이며 MIT 라이선스로 제공됨.
- 코드, 벤치마크, 원시 결과는 GitHub에 있음.
- 아이콘은 Lucide를 사용하며 ISC 라이선스가 적용됨.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요