TL;DR
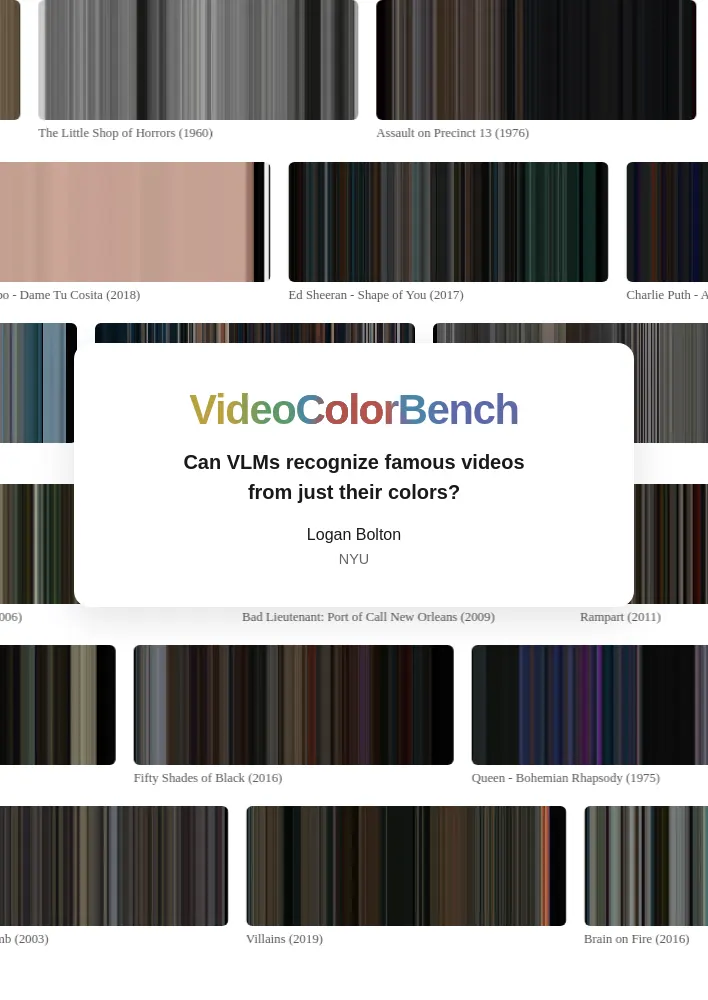
- 동영상의 초당 프레임을 한 가지 색으로 요약한 바코드 이미지로 VLM(Video Language Model)의 영상 식별 능력을 평가한 결과, 정답 선택지가 10개인 벤치마크에서 최고 성능 모델도 약 25%의 정확도를 기록함.
- 벤치마크는 조회 수가 높은 YouTube 동영상 100개와 쉽게 내려받을 수 있는 인기 영화 100편으로 구성됨.
- 무작위 추측의 기준 정확도는 10%이며, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra는 약 25%, 오픈소스 모델 3종은 약 18%를 기록함.
- 에이전트 하네스에서 웹 검색만 사용한 방식은 개선 폭이 작았지만, YouTube 미리보기 이미지를 색상과 비교한 GLM-5.3 Flash는 가장 높은 정확도를 기록함.
- 내려받은 동영상에 직접 접근할 수 있게 하자 모델 정확도가 100%에 도달했으며, 평가된 문항은 비용 부족으로 200개 중 126개임.
벤치마크 구성
- 배우가 바코드처럼 보이는 이미지에서 자신이 출연한 영화를 맞히는 온라인 유행을 바탕으로 벤치마크를 구축함. 이미지의 각 줄은 한 프레임의 색상을 나타냄.
- 예를 들어 《2001: 스페이스 오디세이》(1968)의 바코드 이미지에는 후반부에 데이브가 HAL을 종료하는 장면의 선명한 짙은 빨간색 영역이 나타나고, 이어 스타게이트의 밝은 색상이 이어짐.
- 조회 수가 가장 높은 YouTube 동영상 100개와 토렌트 없이 쉽게 내려받을 수 있는 인기 영화 100편을 선정하고, 각 동영상에서 매초 프레임을 추출해 단일 색상으로 평균화함.
- 선택지 제거만으로 정답을 쉽게 추론할 수 있는 객관식 문항을 피하고자 문항마다 선택지 10개를 제공함.
- 각 모델의 API를 중간 수준 추론 설정으로 실행하고 웹 검색 도구 없이 최선의 답을 요청함. 에이전트 하네스가 정확도를 높일 수 있는지 확인하기 위해 도구를 사용하고 인터넷을 검색할 수 있는 별도 실행도 진행함.
- 배우들이 같은 과제를 수행하는 동영상 예시도 제시함.
예시
- 《2001: 스페이스 오디세이》(1968)의 주요 장면은 인류의 여명, 원심분리기, HAL 종료로 제시됨.
결과
- 문항별 무작위 추측의 기준 정확도는 10%임.
- Opus 5.5, GPT-6.1 Sol, GPT-6 Astra는 문제의 약 25%를 맞혔으며, 오픈소스 모델인 Qwen-3.5-397B, GLM-5.3-Flash, Qwen-3.8-27B는 약 18%의 정확도를 기록함.
- 전체 입력 문항과 모델 응답 목록을 제공함.
- 실행 도중 비용이 바닥나 전체 200개 문항 중 126개만 평가함.
에이전트 하네스 추가
- Claude Code 하네스를 사용한 Opus 5.5는 웹 검색을 한 번도 실행하지 않고 이미지만 보고 답을 추측했으며, 일반 API 호출과 비슷한 점수를 기록함.
- Codex 하네스를 사용한 GPT-6.1 Sol은 거의 모든 문항에서 웹을 검색함.
- 후보 영상의 글로 된 설명을 찾기 위해 “Bad Romance music video scenes white red ending”과 같은 검색어를 사용했으며, 검색 결과는 주로 Wikipedia, Reddit, IMDb로 이어짐.
- 영화의 경우 기존 영화 바코드도 검색함.
- 색상을 단어와 대조하는 방식이라 개선 효과는 작았으며, 후보 영상의 프레임은 한 장도 살펴보지 않음.
- opencode 하네스를 사용한 GLM-5.3 Flash는 각 후보의 YouTube 미리보기 이미지를 가져와 바코드의 색상과 비교했으며, 큰 차이로 가장 높은 정확도를 기록함.
- 각 에이전트가 내려받은 동영상에 접근하도록 해 보니 과제가 지나치게 쉬워져 모델이 100% 정확도를 기록함.
요약
- 실제 영화광이나 인터넷에 오래 머무는 YouTube 이용자만 100%에 가까운 정확도를 낼 수 있을 것으로 보는 어려운 벤치마크임.
- 질문이 매우 특수한 만큼 모델이 이 과제를 명시적으로 학습했을 가능성은 매우 낮다고 봄.
- 이렇게 특수한 과제에서도 미국의 프런티어 모델이 중국의 최고 오픈소스 모델보다 앞서는 점이 흥미로움.
- GitHub 저장소와 Hugging Face의 전체 데이터셋 링크가 있다고 안내하지만, 제공된 본문에는 해당 링크가 포함되어 있지 않음.
인용
- Logan Bolton, “VideoColorBench: Can VLMs Recognize Famous Videos From Just Their Colors?” (2026년 10월).
- 원문 및 서지 정보
- BibTeX 인용 정보의 연도는 2026년, 월은 October, URL은 https://loganbolton.github.io/blog/videocolorbench/임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요