vLLM의 분리형 추론에서 프리필(prefill) 인스턴스의 KV 캐시를 디코드(decode) 인스턴스로 옮기는 방식을 푸시 기반으로 바꾸면, 전송 준비를 프리필과 겹쳐 진행할 수 있다. Qwen3-32B를 Amazon EC2 P5en과 EFA로 구성한 1P1D 벤치마크에서 푸시 방식은 풀 방식보다 첫 토큰 지연(TTFT)을 최대 3배 개선하고 출력 토큰당 시간(TPOT)을 최대 30% 개선했다. 결과는 작업 부하와 구성에 따라 달라진다.
vLLM은 대규모 언어 모델(LLM)을 위한 오픈소스 추론·서빙 엔진이다. LLM 추론은 입력 프롬프트를 처리해 키-값(KV) 캐시를 만드는 프리필 단계와, 캐시를 사용해 토큰을 하나씩 생성하는 디코드 단계로 나뉜다. 두 단계는 연산량, 메모리 사용량, 확장 특성이 서로 다르다. 프리필-디코드(P-D) 분리 방식은 두 단계를 별도의 엔진 인스턴스에서 실행해 각 단계를 독립적으로 확장하고 최적화한다. 부하가 있을 때 자원 활용률과 처리량, 지연 시간을 개선할 수 있지만, 토큰 생성 전에 프리필 인스턴스에서 디코드 인스턴스로 KV 캐시를 전송해야 한다. 따라서 전송 효율은 TTFT에 중요하다.
vLLM은 전송 방법 가운데 하나로 NVIDIA Inference Xfer Library(NIXL) 커넥터를 지원한다. 이 커넥터는 AWS Elastic Fabric Adapter(AWS EFA)처럼 원격 직접 메모리 접근(RDMA)을 지원하는 연결망을 통해 KV 블록을 옮긴다. AWS EFA는 서버 간 저지연 RDMA 네트워크다. 지원 인스턴스 유형에서는 GPU 다이렉트 RDMA와 Neuron 다이렉트 RDMA를 지원하므로, NIXL은 호스트 메모리를 거치지 않고 GPU 또는 AWS Trainium 장치 메모리 사이에서 KV 블록을 직접 전송할 수 있다.
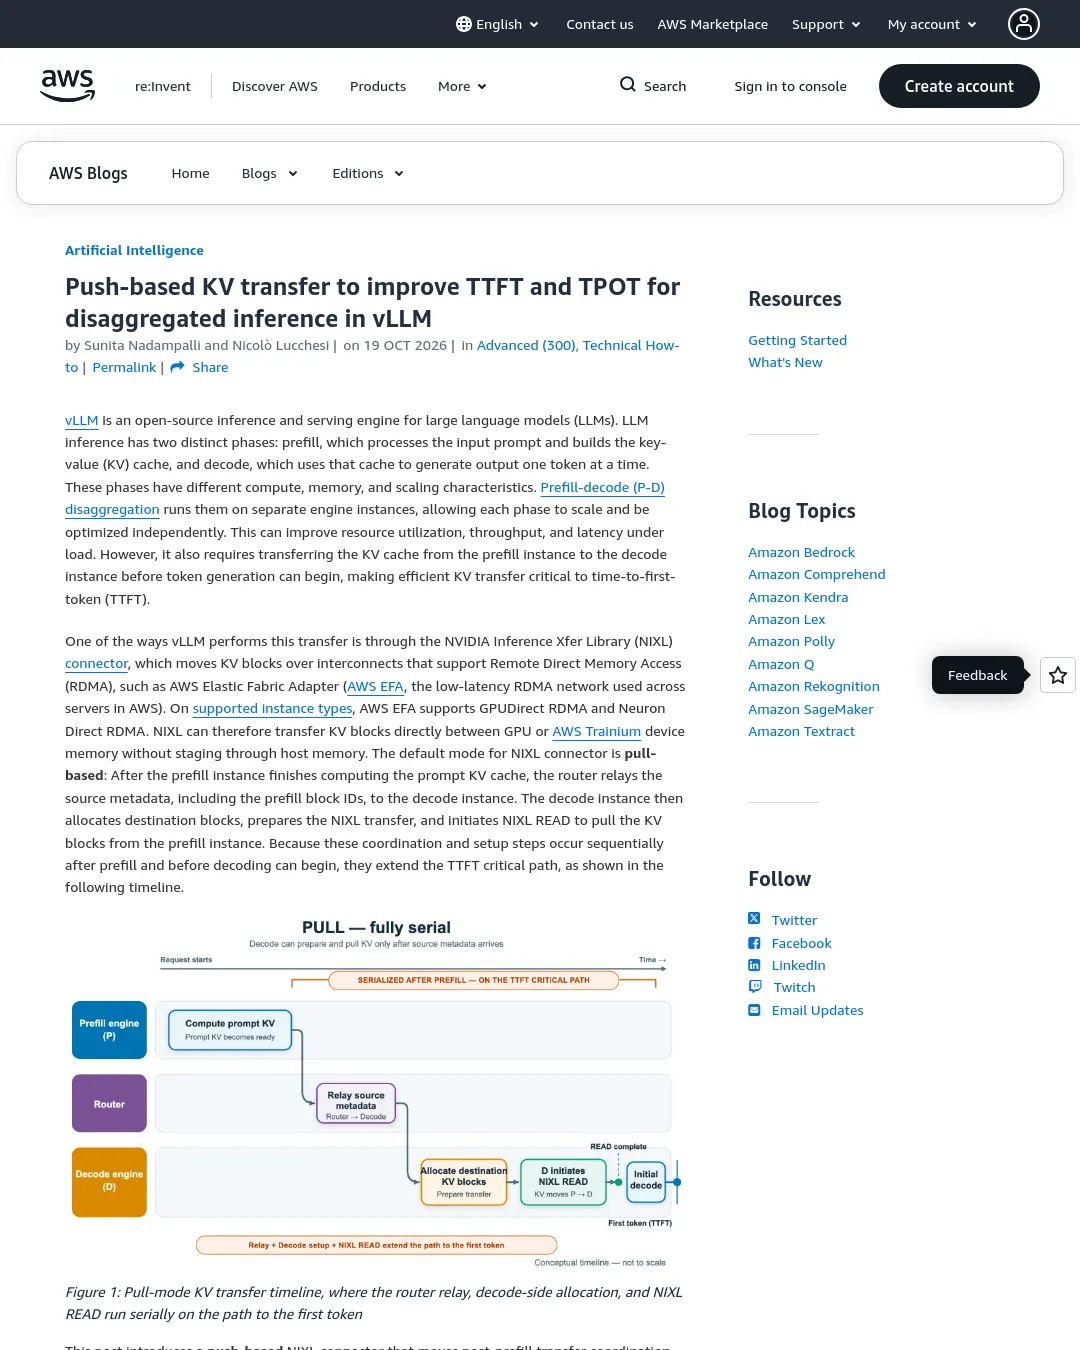
기본 NIXL 커넥터는 풀 방식으로 작동한다. 프리필 인스턴스가 프롬프트의 KV 캐시 계산을 끝내면 라우터가 프리필 블록 ID를 포함한 원본 메타데이터를 디코드 인스턴스로 전달한다. 디코드 인스턴스는 목적지 블록을 할당하고 NIXL 전송을 준비한 뒤, 프리필 인스턴스에서 KV 블록을 가져오는 NIXL READ를 시작한다. 이 조정과 준비 작업은 프리필이 끝난 뒤 디코딩이 시작되기 전에 순차적으로 이뤄져 TTFT의 임계 경로를 늘린다.
그림 1: 라우터 전달, 디코드 측 블록 할당, NIXL READ가 첫 토큰 생성 경로에서 차례로 실행되는 풀 방식 전송 흐름
이번에 소개된 푸시 기반 NIXL 커넥터는 프리필 이후에 하던 전송 조정과 준비를 임계 경로 밖으로 옮긴다. vLLM으로 프리필과 디코드를 분리해 추론하는 경우, 특히 요청률이 높은 환경에서 TTFT와 TPOT를 낮춰 애플리케이션 응답성을 높일 수 있다.
Amazon EC2 P5en 인스턴스와 EFA를 연결한 1P1D 배포에서 Qwen3-32B를 측정한 결과, 푸시 방식은 풀 방식보다 TTFT가 최대 3배, TPOT가 최대 30% 개선됐다. 성능 결과는 작업 부하와 구성에 따라 달라진다. 기능은 EFA로 연결한 AWS Trainium 인스턴스 클러스터에서 개발하고 검증한 뒤, 특정 가속기에 종속되지 않는 기능으로 vLLM에 기여했다. 여기 제시한 결과는 GPU를 사용하는 Amazon EC2 P5en과 EFA 클러스터에서 얻었다. 이 글은 푸시 기반 구조와 전송 흐름, 스레딩 모델, 성능 결과 및 벤치마크 재현 방법을 설명한다.
푸시 기반 KV 전송
푸시 방식은 두 가지 이유로 TTFT와 디코드 처리량을 개선한다. 첫째, 생산자와 소비자의 작업을 겹쳐 풀 방식의 순차 처리를 없앤다. 생산자인 프리필 인스턴스가 KV를 계산하는 동안 디코드 인스턴스가 목적지 블록을 미리 등록한다. 생산자 측 블록이 준비되면 소비자 측에서 블록 ID를 확인하는 왕복 절차를 기다리지 않고 전송을 시작한다. 둘째, 전송 준비 작업을 디코드 인스턴스에서 프리필 측 백그라운드 스레드로 옮긴다. 이 스레드가 NIXL 설명자를 준비하고 전송을 제출하므로, 디코드 인스턴스는 지연에 민감한 토큰 생성 중에 해당 작업을 수행하지 않아도 된다. 그 결과 TTFT가 낮아지고 디코드 인스턴스의 출력 토큰 처리량이 높아진다.
푸시 커넥터는 세 주체를 조정한다. 디코드 인스턴스는 목적지 블록을 미리 등록하고, 프리필 인스턴스는 요청을 짝지어 전송을 시작하며, 전용 백그라운드 스레드는 KV 쓰기 작업을 엔진의 순전파 루프 밖에서 처리한다.
그림 2: 디코드 인스턴스와 프리필 인스턴스, 백그라운드 전송 스레드가 협력하는 푸시 기반 KV 전송 구조
프로토콜은 세 단계로 이뤄진다.
- 등록(디코드 측): 원격 프리필이 필요한 요청에 대해 디코드 인스턴스가 로컬 블록을 할당할 때, 프리필 인스턴스가 KV를 기록할 위치를 등록한다. 등록 정보에는 디코드 인스턴스의 식별 정보와 방금 확보한 블록 위치가 포함된다. 같은 엔진 단계에서 워커가 이 등록 정보를 NIXL 알림으로 프리필 인스턴스에 보낸다. 등록 시점이 블록 할당 때이므로 프리필이 끝나기 전에 목적지 블록을 알 수 있다.
- 랑데부(프리필 측): 디코드 측 등록 정보와 생산자 측 프리필 완료는 어느 쪽이 먼저 도착해도 된다. 등록이 먼저 오면 생산자는 프리필이 끝날 때까지 등록 정보를 보관하고, 프리필이 먼저 끝나면 등록이 도착할 때까지 해당 요청의 블록을 보관한다. 나중에 도착한 이벤트가 전송을 시작한다. 커넥터는 요청 ID로 두 이벤트를 짝짓고, 재발급된 요청도 처리해 선점되거나 재시도된 요청을 올바르게 연결한다.
- 전송(프리필 측): 요청을 짝지으면 생산자는 아직 연결이 없을 때 디코드 인스턴스에 연결한 뒤 NIXL WRITE를 실행한다. 이 작업은 각 목적지 텐서 병렬 랭크를 대상으로 KV 블록을 디코더가 등록한 메모리에 직접 복사한다. 생산자와 소비자는 내부 블록 배치가 서로 달라도 된다. 각 측은 전송 시점에 블록 위치를 자체 물리 배치에 대응시키므로 양쪽의 블록 크기도 다를 수 있다. 각 WRITE는 완료 알림을 포함하며, 데이터가 도착하면 NIXL이 이를 디코드 인스턴스에 전달한다. 디코더는 생산자 랭크가 자신에게 쓰기를 수행할 때마다 알림 하나를 세고, 예상한 알림을 모두 받은 뒤에야 KV 수신이 끝난 것으로 처리해 요청을 디코드 단계로 넘긴다.
스레딩과 풀·푸시 방식의 차이
푸시 커넥터는 각 프리필 워커에 전용 백그라운드 전송 스레드를 둬 모델 실행과 KV 전송 준비를 분리한다. 요청이 시작되면 디코드 메인 루프는 목적지 KV 블록을 할당해 프리필 인스턴스에 등록하는 한편, 프리필 메인 루프는 프롬프트 KV 캐시를 계산한다. 목적지 등록과 프롬프트 KV가 모두 준비되면 프리필 메인 루프는 KV 블록을 백그라운드 스레드에 넘기고 곧바로 모델 실행을 이어간다.
백그라운드 스레드는 NIXL 연결을 만들거나 기존 연결을 재사용하고, 요청의 KV 블록 ID를 메모리 설명자에 대응시킨다. 이어 연속된 블록을 더 큰 전송 영역으로 합친 뒤 디코드 인스턴스에 NIXL WRITE를 제출한다. NIXL이 전송을 완료하면 디코드 인스턴스에 완료 알림을 보내고, 디코드 인스턴스는 토큰 생성을 시작한다. 설명자 준비와 전송 제출을 지연에 민감한 메인 루프 밖에서 처리하면 요청별 작업이 모델 실행을 늦추지 않는다.
그림 3: 푸시 기반 스레딩 모델에서 단일 요청을 처리할 때 메인 루프와 백그라운드 스레드가 작업을 주고받는 흐름
두 방식은 NIXL과 EFA/RDMA 데이터 경로를 함께 사용하지만, 전송 조정 시점은 다르다. 풀 방식은 프리필이 끝난 뒤 메타데이터를 전달하고 디코드 측 전송을 준비한다. 푸시 방식은 이 준비를 프리필과 겹쳐 진행해 프리필 후 임계 경로에서 해당 작업을 제거하고 디코딩을 더 일찍 시작한다.
그림 4: 풀 방식과 푸시 방식의 전송 흐름 비교. 푸시 방식은 디코드 측 준비를 프리필과 겹쳐 진행한다.
두 방식은 라우팅 선택 시점에서 차이가 난다. 풀 방식은 프리필이 끝난 뒤 라우터가 디코드 인스턴스를 고를 수 있어 부하 기반 라우팅과 서비스 품질 관리에서 더 유연하다. 푸시 방식은 목적지 준비를 프리필과 겹치기 위해 디코드 인스턴스를 더 일찍 선택한다. 대신 부하가 비슷한 조건에서는 전송이 프롬프트 KV와 목적지 등록이 모두 준비되는 즉시 시작되므로, 프리필 인스턴스가 KV 블록을 더 빨리 해제할 수 있다.
성능 측정
평가에는 Amazon EC2 P5en과 EFA를 연결한 1P1D 배포에서 Qwen3-32B를 사용했다. 프리필에서 디코드로의 전송 성능만 비교하기 위해 --no-enable-prefix-caching 옵션으로 접두어 캐싱을 비활성화했다. 이 설정에서는 디코드 노드가 매 요청마다 프리필 노드에서 전체 KV 캐시를 가져온다. 이를 끄지 않으면 프롬프트가 겹치는 요청에서 디코드 노드의 로컬 캐시를 재사용해 전송을 건너뛸 수 있어 비교 결과가 실제 전송 차이를 반영하지 못할 수 있다.
TTFT 측정은 입력 길이 1k~16k, 요청률 초당 1~8건(QPS)을 비교했다. 부하가 낮고 프롬프트가 짧을 때 두 방식의 성능은 거의 같았다. 요청률과 입력 길이가 증가하면 풀 방식의 지연이 급격히 늘어 8 QPS, 입력 길이 16k에서 약 1,744ms에 이르렀다. 푸시 방식은 약 540ms로 유지돼 약 3배 낮았다. 풀 방식은 디코드 워커의 엔진 루프 안에서 NIXL 설명자를 동기적으로 게시하므로 토큰 생성이 지연된다. 푸시 방식은 이 작업을 백그라운드 스레드로 옮겨 임계 경로에서 제외한다.
그림 5: 입력 길이와 요청률에 따른 푸시·풀 KV 전송의 TTFT 비교. 1P1D 구성, 출력 토큰 128개, 디코드 노드 접두어 캐싱 비활성화 조건이다.
같은 조건에서 측정한 TPOT도 비슷한 양상을 보였다. 부하가 낮을 때 푸시와 풀 방식은 약 5.6~5.8ms로 비슷했다. 부하와 입력 길이가 늘면서 풀 방식은 4~8 QPS, 입력 길이 16k에서 약 10.4ms까지 증가했지만, 푸시 방식은 약 7ms를 유지했다. 푸시 방식이 설명자 준비와 전송 제출을 디코드 워커에서 분리해 토큰 생성이 작업에 밀리지 않으므로, 동시 요청이 많고 문맥이 길어져도 토큰당 지연이 안정적으로 유지된다는 설명이다.
그림 6: 입력 길이와 요청률에 따른 푸시·풀 KV 전송의 TPOT 비교. 1P1D 구성, 출력 토큰 128개, 디코드 노드 접두어 캐싱 비활성화 조건이다.
벤치마크 재현과 적용 조건
EFA로 연결한 Amazon EC2 P5en 인스턴스에서 프리필 노드 하나와 디코드 노드 하나를 사용하는 1P1D 벤치마크를 재현하려면 결과 재현 안내를 참고하면 된다. 안내에는 환경 설정, vLLM 프리필·디코드 서버 실행, 벤치마크 실행, 결과 수집 방법이 담겨 있다. 이 기능은 다른 지원 구성에서도 실행할 수 있지만, 성능은 하드웨어와 모델, 작업 부하, 네트워크 구성에 따라 달라진다.
푸시 기반 KV 커넥터는 프리필 계산과 디코드 측 블록 할당·등록을 겹쳐 수행하고, 프리필 후 라우터 왕복과 디코드 측 전송 준비를 임계 경로에서 제거한다. Qwen3-32B를 사용한 1P1D Amazon EC2 P5en·EFA 벤치마크에서는 풀 방식과 비교해 TTFT가 최대 3배, TPOT가 30% 개선됐다. 결과는 작업 부하와 구성에 따라 달라진다. 푸시 방식을 사용하려면 프리필 서버와 디코드 서버 모두에서 NixlConnector 대신 NixlPushConnector를 설정해야 한다.
디코드 노드를 일찍 선택해도 괜찮고 TTFT를 낮추는 일이 우선이라면 푸시 커넥터를 선택할 수 있다. 양방향 KV 전송이 필요하거나 부하를 고려해 프리필 완료 후 디코드 인스턴스를 선택해야 하는 작업에는 풀 커넥터가 더 적합하다. vLLM은 두 방식의 KV 커넥터를 모두 지원한다.
향후 개선으로는 백그라운드 NIXL 스레딩 모델을 풀 방식 커넥터에도 적용해 NIXL 준비 작업을 임계 경로 밖으로 옮기는 방안을 검토하고 있다. 이를 살펴보기 위한 풀 리퀘스트를 열었다.
이 기능을 유지하는 데 도움을 준 vLLM 커뮤니티에 감사한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요