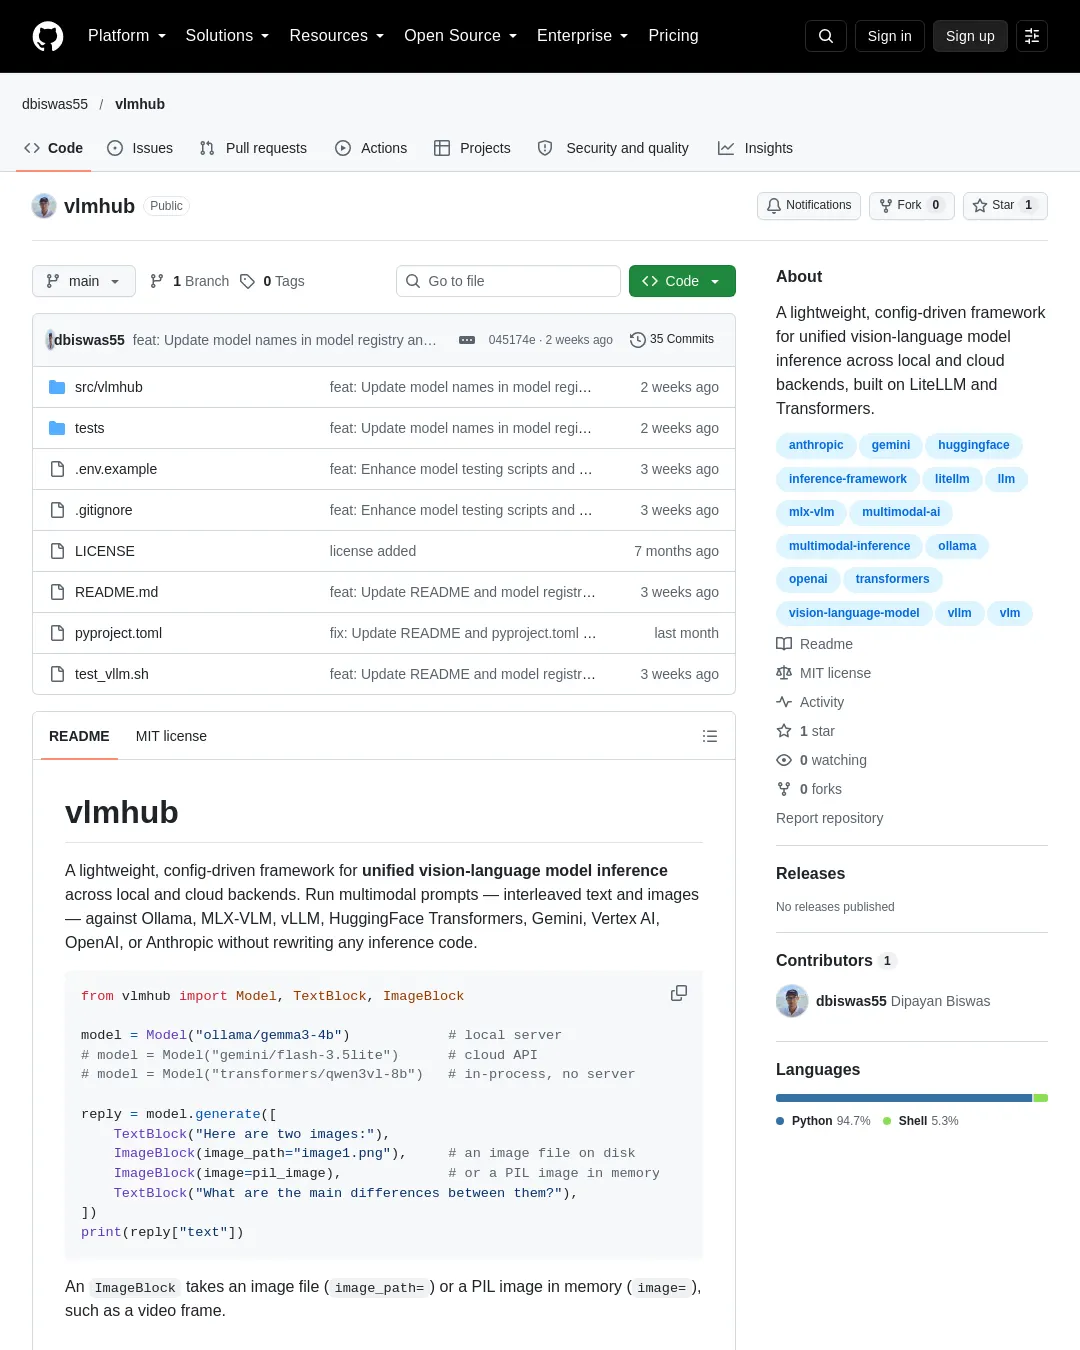
vlmhub 저장소는 로컬과 클라우드의 비전·언어 모델을 같은 방식으로 호출하는 파이썬 프레임워크다. 텍스트와 이미지를 섞은 프롬프트를 Ollama, MLX-VLM, vLLM, HuggingFace Transformers, Gemini, Vertex AI, OpenAI, Anthropic 등에서 실행할 수 있다. 제작자는 백엔드를 바꿔도 추론 코드를 다시 작성할 필요가 없다고 설명한다.
from vlmhub import Model, TextBlock, ImageBlock

model = Model("ollama/gemma3-4b") # local server
# model = Model("gemini/flash-3.5lite") # cloud API
# model = Model("transformers/qwen3vl-8b") # in-process, no server

reply = model.generate([
 TextBlock("Here are two images:"),
 ImageBlock(image_path="image1.png"), # an image file on disk
 ImageBlock(image=pil_image), # or a PIL image in memory
 TextBlock("What are the main differences between them?"),
])
print(reply["text"])
ImageBlock에는 디스크의 이미지 파일(image_path=)이나 메모리에 있는 PIL 이미지(image=)를 전달한다. 후자는 동영상 프레임처럼 메모리에 있는 이미지에도 쓸 수 있다.
지원 백엔드와 모델
주요 기능은 TextBlock과 ImageBlock을 받아들이는 하나의 Model.generate() 인터페이스, 순서에 상관없이 텍스트와 이미지를 섞는 프롬프트, 설정을 관리하는 모델 레지스트리다. 각 백엔드는 필요에 따라 이미지를 전송 중에는 base64 데이터 URI로, 프로세스 내부에서는 PIL 형식으로 인코딩한다. 레지스트리는 편집 가능한 JSON 파일이며 모델·설정·생성 기본값을 담는다. 실제 모델 ID와 함께 임의의 짧은 이름을 지정할 수 있다.
Transformers 백엔드는 모델을 프로세스 내부에서 실행한다. 선택적으로 4비트 양자화 로드를 지원하며, 네이티브 bfloat16을 지원하지 않는 Ampere 이전 GPU(예: V100)를 위해 fallback_dtype를 지정할 수 있다. 그 밖의 호스팅은 LiteLLM이 담당한다.
지원 백엔드는 다음과 같다.
| 구분 | 제공자 | 호스팅 키 | 백엔드 | 실행 방식 |
|---|---|---|---|---|
| 로컬 서버 | Ollama | ollama | litellm | 11434 포트의 로컬 서버 |
| 로컬 서버 | MLX-VLM | mlx_vlm | litellm | Apple Silicon, 8080 포트 |
| 로컬 서버 | vLLM | vllm | litellm | CUDA GPU, 8000 포트 |
| 프로세스 내부 | HuggingFace Transformers | transformers | transformers | 직접 모델 로드(CUDA / MPS / CPU) |
| 클라우드 API | Google Gemini (AI Studio) | gemini | litellm | LiteLLM의 gemini/ 제공자. thinking_budget(2.5) 또는 reasoning_effort(3.x) |
| 클라우드 API | Google Gemini via Vertex AI | vertex_ai | litellm | LiteLLM의 vertex_ai/, Application Default Credentials |
| 클라우드 API | OpenAI | openai | litellm | GPT-4o, GPT-4o-mini, GPT-4.1, GPT-5.x |
| 클라우드 API | Anthropic | anthropic | litellm | LiteLLM의 anthropic/ 제공자 |
| 클라우드 API | OpenRouter | openrouter | litellm | 하나의 키로 GPT, Claude, Gemini 사용 |
사전 설정 모델에는 모든 로컬 호스팅에서 쓸 수 있는 Gemma 3(4B, 12B)와 Qwen3-VL(4B, 8B)이 포함된다. transformers에는 Qwen2.5-VL, InternVL3.5, mPLUG-Owl3, Molmo2, Idefics3, LLaVA-OneVision이 추가로 들어 있다. vllm에는 Qwen3.6/3.8, Prometheus, CompassJudger, UnifiedReward, gpt-oss 등 오픈 웨이트 평가 모델이 포함된다. 클라우드 모델은 Gemini(2.5 / 3.x), GPT-4o/4.1/5.x, Claude 4.5 이상, Gemini를 통해 제공되는 Gemma 4다.
설치와 시작
빠른 시작 안내는 저장소를 복제해 시험하거나 개발하는 방법과, 다른 프로젝트에 라이브러리로 설치하는 방법을 제시한다.
저장소를 복제하는 방식은 테스트 스크립트도 함께 가져오므로 처음부터 실행해 보기 좋다.
git clone https://github.com/dbiswas55/vlmhub.git
cd vlmhub

python3 -m venv venv312
source venv312/bin/activate # macOS / Linux
# venv312\Scripts\activate # Windows

pip install -e .
이 설치만으로 LiteLLM이 Gemini, Vertex AI, OpenAI, Anthropic 및 Ollama·MLX-VLM·vLLM 같은 OpenAI 호환 로컬 서버를 처리하므로 호스팅별 SDK를 추가할 필요가 없다. PyTorch는 기본 설치에 포함되지 않는다. 프로세스 내부에서 실행하는 transformers 호스팅에만 필요하다.
pip install -e ".[transformers]" # torch + transformers, for in-process model loading
pip install -e ".[quantization]" # adds bitsandbytes, for 4-bit loads under `transformers`
pip install -e ".[ollama]" # only to manage Ollama's store via local_models.py
pip install -e ".[all]" # everything above
자신의 프로젝트에 설치할 때는 저장소를 서브모듈로 추가한 뒤 그 경로에서 설치한다. 소스가 프로젝트 안에 남아 확인하고 업데이트할 수 있으며, pip가 의존성과 임포트 경로를 처리한다.
cd ~/my-project
git init # skip if your project is already a git repository
git submodule add https://github.com/dbiswas55/vlmhub.git src/_libs/vlmhub

python3 -m venv venv312 && source venv312/bin/activate
pip install -e src/_libs/vlmhub # add "[transformers]" for the in-process hosting
vlmhub 파일은 해당 폴더 안에 둔다.
my-project/ ├── .env # your keys └── src/_libs/vlmhub/ # the repository, pinned to one commit
프로젝트 어디에서나 임포트할 수 있다.
from vlmhub import Model, TextBlock, ImageBlock

model = Model("gemini/flash-3.5")
서브모듈을 최신 업스트림 커밋으로 옮겨 업데이트한다.
git submodule update --remote --merge src/_libs/vlmhub
그 뒤 다른 변경과 마찬가지로 추가하고 커밋하면 저장소에는 vlmhub 파일 자체가 아니라 새 커밋을 가리키는 포인터가 기록된다. 다음 실행부터 새 코드를 사용한다. 업데이트로 의존성이 추가된 경우에만 pip install -e src/_libs/vlmhub를 다시 실행한다.
API 키와 로컬 백엔드 설정
API 키 설정 파일은 저장소 복제 방식(A)에서는 .env.example을, 프로젝트에 설치한 방식(B)에서는 서브모듈 안의 예제 파일을 복사해 만든다.
cp .env.example .env # under A
cp src/_libs/vlmhub/.env.example .env # under B
사용하는 서비스의 값만 입력하면 된다. 항목은 GEMINI_API_KEY, OPENAI_API_KEY, ANTHROPIC_API_KEY, OPENROUTER_API_KEY, GCP_PROJECT/GCP_LOCATION, HF_TOKEN/HF_HOME이다. Ollama나 vLLM만 로컬에서 쓰는 구성에는 키가 필요 없다. 환경 변수 이름이 다르면 레지스트리의 api_key_env를 수정한다.
로컬 백엔드 설정은 선택 사항이다. Ollama를 시작하는 예시는 다음과 같다.
brew install ollama # macOS
ollama pull gemma3:4b
ollama serve # http://localhost:11434/v1
Apple Silicon에서는 MLX-VLM 서버를 실행한다.
python -m mlx_vlm.server --model mlx-community/gemma-3-4b-it-qat-4bit --port 8080
CUDA 환경에서 vLLM을 설정하는 명령은 다음과 같다.
pip install vllm
vllm serve Qwen/Qwen3-VL-4B-Instruct --port 8000
전체 설정 안내는 src/vlmhub/backends/README.md에, 모델 다운로드 유틸리티는 src/vlmhub/utils/local_models.py에 있다.
저장소의 tests/ 스크립트는 기본 동작 확인과 사용 예시를 겸한다. 작업 스크립트는 실제 데이터셋 샘플 몇 개를 내려받아 클라이언트로 실행하고, 결과를 정답과 나란히 출력한다. test_judge.py는 내장 답변을 LLM 평가자로 채점한다. 복제한 저장소에서 다음과 같이 실행한다.
python tests/test_task_captioning.py # models.json's active client
python tests/test_task_vqa.py --client ollama/gemma3-4b
python tests/test_task_vqa.py --client gemini/flash-2.5 --n 5
python tests/test_task_captioning.py --client transformers/gemma3-4b
python tests/test_judge.py --client openai/gpt-4o-mini # text-only judge check
sbatch test_vllm.sh qwen3vl-4b # Slurm: serve a vllm model, run the tests
호출과 생성 설정
사용법의 중심은 Model이다. 레지스트리에서 클라이언트를 찾고 해당 백엔드를 보유한다. 인수를 생략하면 models.json의 active 클라이언트를 사용하며, hosting/model 형식으로 지정할 수도 있다.
from vlmhub import Model, TextBlock, ImageBlock

model = Model() # models.json's "active" client
model = Model("ollama/gemma3-4b") # a specific one, as "hosting/model"

response = model.generate(
 [
 ImageBlock(image_path="input/images/slide_1.png"),
 TextBlock("What does this diagram show?"),
 ImageBlock(image_path="input/images/slide_2.png"),
 TextBlock("How does this compare to the previous slide?"),
 ],
 system_prompt="You are a helpful assistant.",
)

print(response["text"]) # the generation
print(response["logs"]) # e.g. ["MODEL gemma3:4b", "USAGE prompt=288 output=304 total=592"]
print(response["model"]) # the model that actually served the request
print(response["params"]) # the generation settings actually sent, e.g. {"temperature": 0.3}
생성 매개변수는 레지스트리에서 기본값을 가져온다. 호스팅별 설정이 기본값을 덮어쓰고, 모델별 설정이 호스팅 설정을 덮어쓴다. 한 번의 호출에서 다시 지정할 수도 있다.
response = model.generate(content, max_new_tokens=1024, temperature=0.0, top_p=1.0,
 top_k=40, reasoning_effort="medium")
값이 None이면 요청에 보내지 않으므로 제공자의 기본값을 사용한다. Transformers에서는 모델 자체의 generation_config가 적용된다. top_p, top_k, reasoning_effort의 기본값은 None이다. reasoning_effort("low", "medium", "high" 등)는 LiteLLM이 제공자별 제어 항목으로 변환한다. Claude에서는 effort, Gemini 3에서는 thinking_level, OpenAI에서는 reasoning_effort로 전달된다.
레지스트리에서 "sampling": false로 표시한 모델은 temperature/top_p/top_k를 허용하지 않는다. 예로 Claude Sonnet 5, Opus 4.8 이상, GPT-5.6이 제시돼 있다. 해당 값은 모델에 전달되지 않고 로그에 DROPPED ... 행으로 표시된다. params에는 실제로 전송된 설정이 나타난다. 재현 가능한 실행을 위해 제공자가 날짜가 붙은 모델 ID를 제공하면 이를 사용하고, 각 결과와 함께 model과 params를 기록하라고 안내한다.
유용한 속성은 model.name("ollama/gemma3-4b"), model.model_id("gemma3:4b"), model.short_name("gemma3-4b")이며, model.report()는 이 정보를 출력한다. 이미지는 자동 인코딩된다. API 호스팅 백엔드에는 base64 데이터 URI를, Transformers에는 PIL 이미지를 사용한다. ImageBlock(image=...)는 PNG로 인코딩되므로 전송 과정에서 다시 압축하지 않는다.
구성 파일과 로컬 모델 관리
프로젝트 구조에서 공개 API는 src/vlmhub/__init__.py의 Model, Config, TextBlock, ImageBlock 등이다. src/vlmhub/models.json은 모델과 호스팅 레지스트리이며, model.py는 클라이언트 설정과 백엔드를 담는 Model을 정의한다. utils/config.py는 hosting/model을 클라이언트 설정으로 해석하고, utils/local_models.py는 HuggingFace 캐시와 Ollama 모델을 나열·다운로드·삭제한다. backends/에는 백엔드 팩토리, BaseBackend·LiteLLMBackend·TransformersBackend, TextBlock·ImageBlock·InferenceRequest 정의와 설정 안내가 들어 있다. 테스트 디렉터리에는 VQAv2 샘플 기반 질의응답, COCO 샘플 기반 이미지 설명, 클라이언트별 단일 이미지·프롬프트 확인, 예상 점수와 비교하는 1~5점 평가 스크립트가 있다.
모델 레지스트리는 패키지와 함께 제공되는 src/vlmhub/models.json이다. 클라이언트는 Model(...)에 "hosting/model"을 전달하거나 레지스트리에서 active를 설정한 뒤 Model()을 호출해 선택한다. 모델 수준 필드가 호스팅 수준 필드를 덮어쓰고, 호스팅 수준 필드는 defaults를 덮어쓴다.
레지스트리 파일을 직접 고치는 방법은 빠른 변경에 쓸 수 있다. Git은 수정 사항을 보존하지만, 변경 내용은 프로젝트가 아니라 vlmhub의 기록에 들어간다. models.json을 변경하는 릴리스가 나오면 수정 사항을 임시 저장하거나 커밋하기 전까지 다음 git submodule update가 막힌다.
계속 유지할 설정은 별도 파일에 둔다. 이 파일에는 추가하거나 변경할 내용만 적으면 된다.
model = Model("my_server/my-finetune", models_path="my_models.json")
별도 파일은 기본 레지스트리와 같은 구조이며 깊은 병합 방식으로 적용된다. 호스팅과 모델을 추가하거나 개별 필드를 덮어쓸 수 있다. 다만 목록은 이어 붙이지 않고 교체한다. 기존 호스팅의 models를 지정하면 나머지 모델이 사라지므로 새 호스팅 키를 추가해야 한다. 자세한 내용은 새 모델 추가와 새 호스팅 추가 안내를 참조한다.
Transformers 모델에는 model_class, fallback_dtype, 선택 사항인 processor_kwargs 같은 추가 모델별 필드가 필요할 수 있다. 자세한 설명은 백엔드 안내에 있다.
src/vlmhub/utils/local_models.py는 HuggingFace 캐시와 Ollama 저장소를 관리한다. 모듈은 다음과 같이 실행한다.
python -m vlmhub.utils.local_models
list_hf_cache_models()와 list_ollama_cache_models()는 모델과 크기를 나열한다. download_hf_model(ids)와 download_ollama_model(ids)는 모델 하나 또는 목록을 내려받는다. delete_hf_cache_model(id)와 delete_ollama_cache_model(id)는 특정 모델을 삭제하고, delete_hf_cache_model_interactive()와 delete_ollama_cache_model_interactive()는 대화형 선택 메뉴를 제공한다. Ollama 함수에는 ollama 추가 기능이 필요하며 HuggingFace 함수는 기본 설치에서 작동한다.
백엔드 확장과 라이선스
새 제공자를 추가할 때는 대부분 코드를 바꿀 필요가 없다. models.json에 LiteLLM 제공자 접두사를 지정한 호스팅을 추가하면 기존 LiteLLMBackend가 처리한다. 안내는 새 호스팅 추가에 있다.
LiteLLM으로 연결할 수 없는 새로운 백엔드 유형을 추가하려면, 프로세스 내부 Transformers처럼 전송 프로토콜을 사용하지 않는 경우와 같이, backends.py에서 BaseBackend를 상속하고 get_backend_from_config에 등록해야 한다. 절차는 새 백엔드 추가 안내를 참조하면 된다.
vlmhub는 MIT 라이선스로 배포된다. 자세한 내용은 LICENSE에 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요