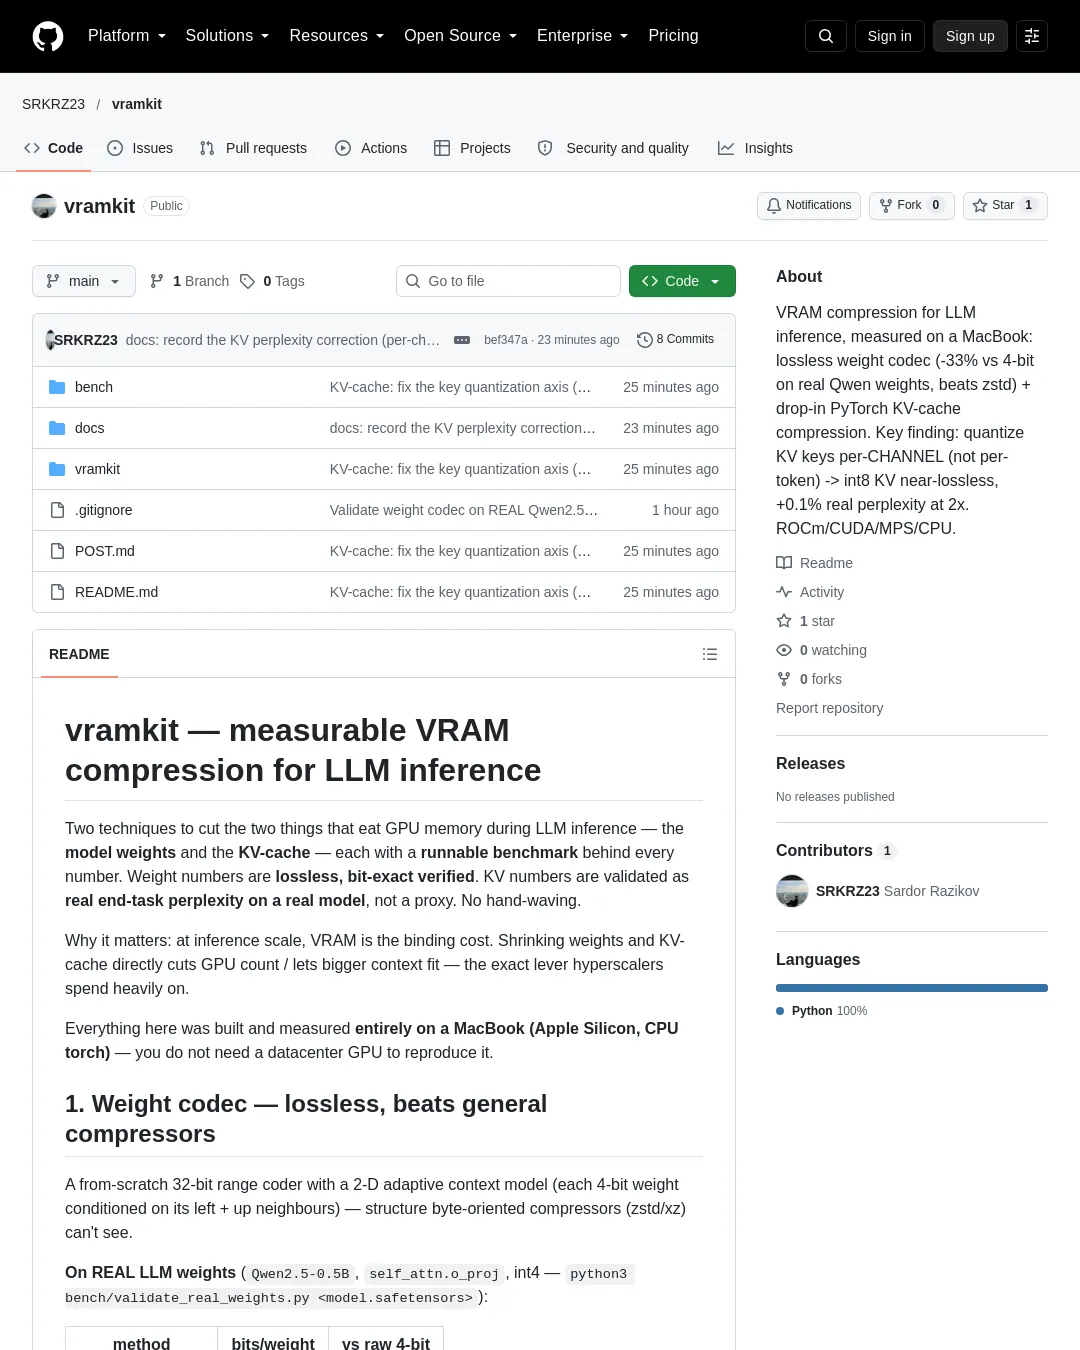
vramkit는 LLM 추론에서 GPU 메모리를 많이 차지하는 모델 가중치와 KV 캐시를 줄이는 두 가지 기법을 담은 프로젝트다. 제작자는 비트 단위로 정확히 복원되는 가중치 압축과, 품질 저하를 측정한 KV 캐시 양자화를 제시했다. 벤치마크는 Apple Silicon 맥북에서 재현할 수 있다.
가중치 압축은 주변 4비트 값의 구조를 활용하는 2차원 적응형 문맥 모델과 32비트 범위 코더를 사용한다. Qwen2.5-0.5B의 self_attn.o_proj int4 가중치에서 원시 4비트 저장은 가중치당 4비트였고, vramkit은 2.676비트로 줄였다. 제작자 측정에 따르면 이는 원시 저장보다 33.1% 작고, zstd -19보다 1.5%, xz -9e보다 1.2% 더 작다. 비트 단위 복원도 검증했다고 밝혔다.
| 방식 | 비트/가중치 | 원시 4비트 대비 |
|---|---|---|
| 원시 4비트 패킹 | 4.000 | — |
| zstd -19 | 2.717 | −32.1% |
| xz -9e | 2.708 | −32.3% |
| vramkit (2-D ctx) | 2.676 | −33.1% |
Qwen2.5-0.5B의 q/k/v/o-proj와 MLP gate/down 가중치 유형 전체에서는 평균 2.92비트/가중치로, 원시 4비트보다 27% 줄었다. zstd보다 작은 결과는 5개 유형 중 4개에서 나왔다. 다만 저장소 상태 설명에는 가중치 코덱이 원시 4비트 대비 22% 감소했다고 적혀 있어, 이 수치는 개별 벤치마크 결과와 다르다.
KV 캐시는 토큰별 int8 또는 int4 양자화로 줄인다. 제작자 측정에서 int8은 fp16보다 약 1.97배 작았고 코사인 유사도는 0.9998이었다. 단순 int4는 3.88배 작지만 유사도가 0.958로 낮아졌다. 128개 채널 중 4개를 int8로 유지하는 outlier-int4 방식은 3.66배 축소와 0.9989 유사도를 기록했다. int4 기호에는 범위 코더를 적용해 추가로 손실 없이 압축할 수 있다고 설명한다.
실제 작업 품질을 확인하기 위해 Qwen2.5-0.5B의 모든 레이어 K/V에 압축을 적용해 맥북에서 퍼플렉시티를 측정한 결과, int8은 fp32 KV 대비 0.02% 증가했다. outlier-int4는 9.5%, 단순 int4는 16.7% 증가했다. 제작자는 코사인 유사도가 int4 품질을 과대평가할 수 있다며, int8은 실제 작업에서도 거의 손실이 없는 결과지만 outlier-int4는 아직 개선이 필요하다고 밝혔다.
PyTorch 모듈 vramkit/kvquant.py는 ROCm, CUDA, Apple MPS 또는 CPU에서 사용할 수 있다고 한다. 사용 예시는 다음과 같다.
from vramkit.kvquant import quantize_kv, dequantize_kv
packed = quantize_kv(key, mode="outlier-int4") # store this instead of fp16 (≈3.6× smaller)
key_hat = dequantize_kv(packed) # reconstruct in the attention path
python3 vramkit/kvquant.py 실행 결과로 제시된 값은 int8 1.97배 축소·코사인 유사도 0.99985, outlier-int4 3.66배 축소·0.99872다. 모드는 int8, int4, outlier-int4를 지원한다.
프로젝트는 순수 Python 표준 라이브러리 기반 범위 코더와 가중치 코덱을 구현했고, 가중치 압축은 맥북에서 약 2초 걸렸다고 설명한다. 다만 GPU에서 압축된 형식을 실시간으로 쓰는 Metal/ROCm 역양자화 커널은 아직 없으며, 저장소에는 GPU 검증이 진행 중이라고 적혀 있다. 다음 과제로 MLX를 이용한 퍼플렉시티 검증과 outlier-int4 개선도 제시했다. 라이선스는 MIT다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요