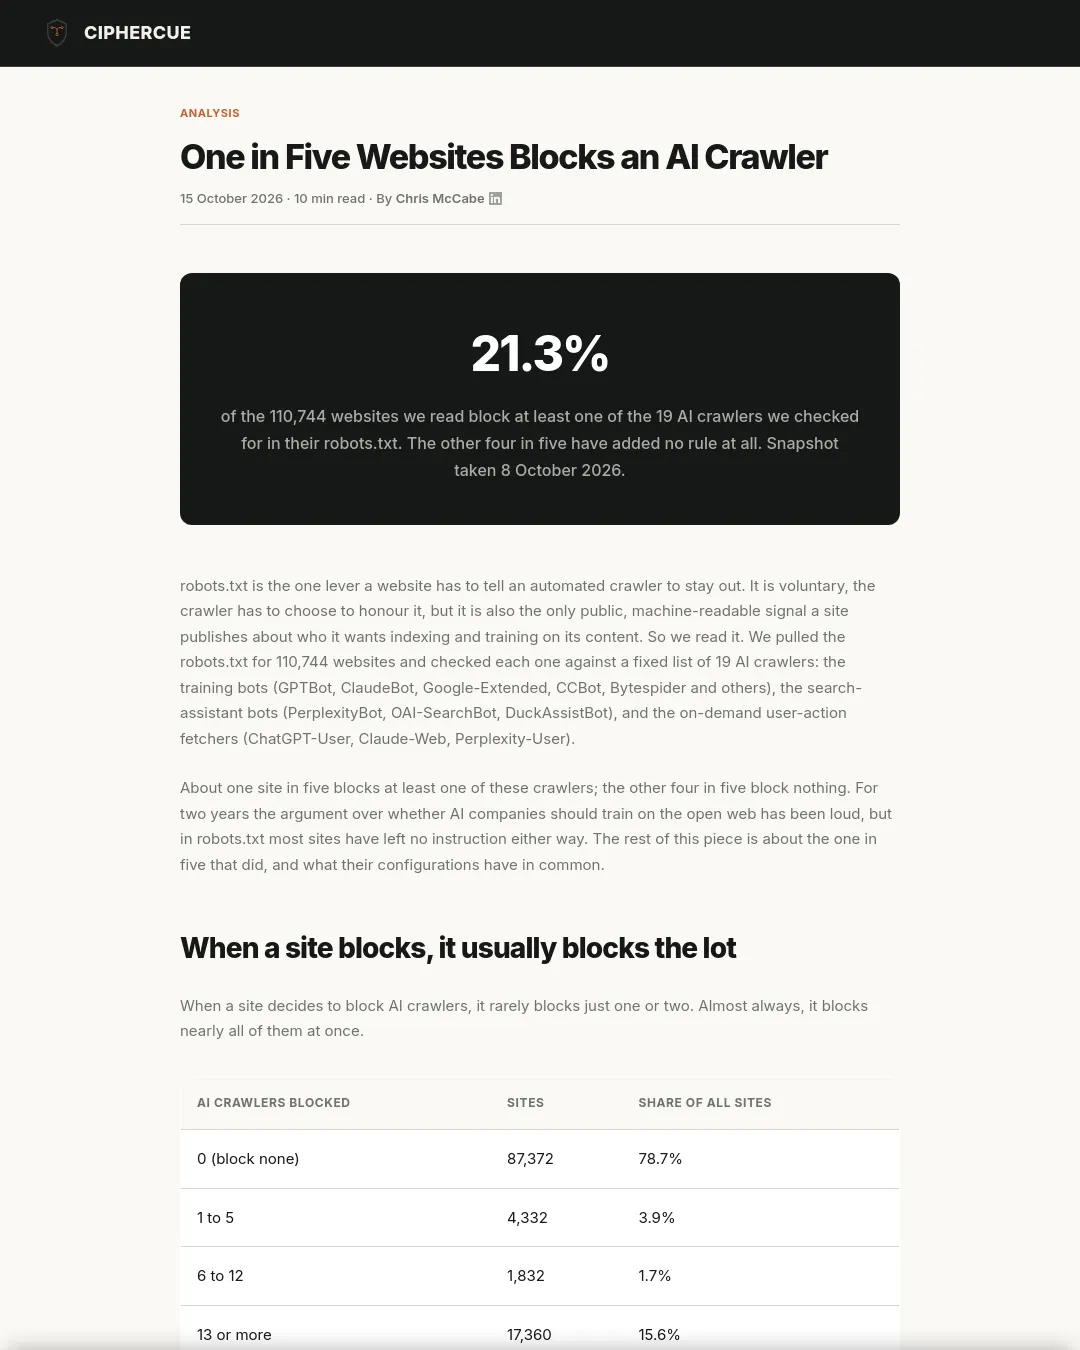
2026년 10월 8일 기준으로 조사한 웹사이트 11만744곳 가운데 21.3%가 robots.txt에서 AI 크롤러 19종 중 하나 이상을 차단했다. 나머지 약 5분의 4는 AI 크롤러에 관한 규칙을 두지 않았다.
robots.txt는 웹사이트가 자동 크롤러에 접근하지 말라고 알리는 공개 신호다. 자발적으로 설정하는 규칙이며 크롤러가 이를 따를 의무는 없지만, 사이트가 콘텐츠의 색인화나 학습에 관해 공개하는 기계 판독 가능 신호이기도 하다. 이번 조사는 사이트별 robots.txt를 확인해 학습용 GPTBot, ClaudeBot, Google-Extended, CCBot, Bytespider 등과 검색용 PerplexityBot, OAI-SearchBot, DuckAssistBot, 사용자 요청에 따라 페이지를 가져오는 ChatGPT-User, Claude-Web, Perplexity-User 등 정해진 AI 크롤러 19종과 대조했다.
| 차단한 AI 크롤러 수 | 사이트 수 | 전체 사이트 중 비율 |
|---|---|---|
| 0종 | 87,372 | 78.7% |
| 1~5종 | 4,332 | 3.9% |
| 6~12종 | 1,832 | 1.7% |
| 13종 이상 | 17,360 | 15.6% |
무언가를 차단한 사이트 10곳 중 7곳은 크롤러 19종 가운데 13종 이상을 차단했다. 특정 회사의 크롤러만 골라 차단하기보다는 알려진 크롤러 대부분을 한꺼번에 막는 경우가 많았다. 일부만 차단한 사이트는 전체 차단 사이트의 5분의 1에도 못 미쳤다.
차단된 크롤러 가운데 가장 많은 것은 오픈AI의 학습용 크롤러 GPTBot이다. 조사 대상 전체에서 20,654개 사이트가 이를 차단했다. 아마존, 앤스로픽, 메타, 구글, 애플의 주요 학습용 크롤러도 비슷한 규모로 뒤를 이었다.
| 크롤러 | 운영사 | 용도 | 차단 사이트 수 |
|---|---|---|---|
| GPTBot | 오픈AI | 학습 | 20,654 |
| Amazonbot | 아마존 | 학습 | 19,713 |
| ClaudeBot | 앤스로픽 | 학습 | 19,634 |
| Meta-ExternalAgent | 메타 | 학습 | 19,168 |
| Google-Extended | 구글 | 학습 | 18,870 |
| Applebot-Extended | 애플 | 학습 | 18,559 |
| PerplexityBot | Perplexity | 검색 | 17,926 |
| OAI-SearchBot | 오픈AI | 검색 | 17,367 |
| Claude-SearchBot | 앤스로픽 | 검색 | 17,005 |
| CCBot | Common Crawl | 학습 | 5,535 |
| Bytespider | ByteDance | 학습 | 5,176 |
CCBot과 Bytespider는 각각 약 20곳 중 1곳에서 차단돼, GPTBot의 약 5곳 중 1곳보다 비율이 낮았다. 지난달 하루치 표본을 조사했을 때는 Bytespider가 가장 많이 차단된 것으로 나타났지만, 더 큰 표본에서는 순위가 달라졌다. 두 크롤러는 사이트들이 재사용하는 차단 목록에서 대체로 빠져 있었다.
학습용 크롤러와 검색용 크롤러를 다르게 다루는 사이트
AI 기업 다수는 모델 학습용 크롤러와 AI 검색 서비스에서 답변할 페이지를 가져오는 크롤러를 따로 운영한다. 오픈AI는 학습에 GPTBot, 검색에 OAI-SearchBot을 사용하며 robots.txt에서 두 크롤러를 각각 제한할 수 있다.
오픈AI 크롤러 둘 중 하나를 차단한 사이트의 5분의 4는 둘 다 차단했다. 나머지에서는 검색용은 허용하고 학습용만 차단하는 경우가 그 반대보다 훨씬 많았다. 조사 대상 전체에서 검색용은 차단하면서 학습용은 허용한 사이트는 100곳이 채 되지 않았다. 앤스로픽과 Perplexity에서도 같은 경향이 나타났다.
따라서 두 종류를 다르게 설정한 사이트는 대체로 학습용 크롤러는 막고 검색용은 허용했다. 즉 콘텐츠를 학습에 쓰지는 말되 답변에서 인용하는 것은 허용하는 방식이다. 다만 이것이 의도적인 선택인지, 학습용 크롤러가 복사해 쓰는 차단 목록에 더 자주 포함되기 때문인지는 robots.txt만으로 알 수 없다.
국가별 차단 비율은 큰 차이를 보였다
국가별 비율은 가장 높은 곳과 낮은 곳 사이에 10배 이상 차이가 났다. 아래 국가별 표본은 각각 수백 곳 이상이며 대부분 수천 곳이지만, 각국 웹사이트를 대표하는 표본은 아니다. 업종, 기업 규모, 호스팅 제공업체의 구성이 국가마다 다르다.
| 국가 | 조사 사이트 수 | 하나 이상 차단한 비율 |
|---|---|---|
| 네덜란드 | 12,626 | 42.2% |
| 영국 | 23,579 | 32.0% |
| 독일 | 25,148 | 23.6% |
| 이탈리아 | 8,595 | 13.5% |
| 프랑스 | 9,196 | 12.2% |
| 스페인 | 5,239 | 12.1% |
| 폴란드 | 10,532 | 11.8% |
| 아일랜드 | 1,453 | 10.4% |
| 캐나다 | 598 | 3.5% |
| 미국 | 7,496 | 2.9% |
네덜란드에서는 5곳 중 2곳 이상, 영국에서는 거의 3곳 중 1곳, 독일에서는 약 4곳 중 1곳이 하나 이상의 크롤러를 차단했다. 반면 미국은 100곳 중 3곳에도 못 미쳤다. 조사 결과는 네덜란드와 영국의 차단 비율이 미국보다 훨씬 높다는 점을 보여주지만, 그 원인은 확인하지 못했다. 국가별 업종 구성, 호스팅 업체나 웹 에이전시가 제공하는 기본 설정, 관측된 사이트의 차이 등이 원인일 수 있으나 조사로 판별할 수는 없다.
차단 사이트에는 대형 언론사보다 일반 기업이 많았다. 독일과 네덜란드의 중소기업, 영국과 아일랜드의 소프트웨어 업체, 이탈리아의 골동품 거래 사이트, 아웃도어 장비점과 지역 서비스 업체 등이 포함됐다. 공통된 업종이나 규모는 확인되지 않았다. 아마존의 robots.txt는 크롤러 19종 가운데 15종을 차단했고, 리뷰 사이트 Trustpilot은 9종을 차단했다.
차단 사이트의 63.8%는 동일한 크롤러 17종을 차단했고, 6.1%는 19종 전체를 차단했다. 두 설정을 합치면 차단 사이트 10곳 중 7곳이 두 구성 중 하나를 사용했다. 상당수는 User-agent: *와 Disallow: /를 적용해 AI 크롤러뿐 아니라 구글을 포함한 모든 로봇을 막았다. 이런 설정은 대개 개발 단계 사이트, 비공개 앱 또는 로그인 화면에 쓰인다. 반면 약 7,000곳, 즉 차단 사이트 3곳 중 1곳은 AI 크롤러를 직접 지정해 차단했다.
크롤러 17종 목록에는 주요 서구권 학습용 크롤러와 사용자 대상 서비스의 페이지 수집기가 포함됐지만 CCBot과 Bytespider는 빠졌다. 그래서 두 크롤러는 개별 순위에서 낮게 나타났다. Disallow: / 같은 포괄 규칙은 이들까지 막지만, 크롤러를 직접 지정하는 사이트는 Common Crawl이나 ByteDance를 거의 목록에 넣지 않았다. 직접 지정한 설정은 1,000개가 넘는 조합으로 나뉘어 있었다.
차단 설정이 흔한 워드프레스 플러그인에서 비롯됐다는 가정과 달리, 조사에서는 반대 경향이 나타났다. 차단 사이트 가운데 워드프레스를 쓰는 비율은 4.0%였고, 아무것도 차단하지 않은 사이트에서는 21.5%였다. 차단 규칙이 호스팅 기본값, 에이전시의 공통 설정, 널리 복사된 문구에서 비롯됐는지는 확인되지 않았다.
내 사이트에서 AI 크롤러를 차단하려면
robots.txt는 도메인 최상위 경로인 /robots.txt에 둔다. 파일은 위에서 아래로 읽으며, 각 그룹은 User-agent 줄과 그 크롤러에 적용되는 규칙으로 구성된다. 크롤러는 사이트의 규칙을 따르기로 선택해야 하지만, 잘 알려진 AI 크롤러는 robots.txt를 읽는다고 밝히고 있다.
특정 크롤러 하나를 차단하려면 이름을 지정하고 모든 경로를 허용하지 않도록 설정한다.
User-agent: GPTBot
Disallow: /
여러 크롤러를 차단하려면 각각 별도 그룹을 둔다. 아래 목록은 조사 시점에 자주 언급된 학습용·검색용 크롤러다.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Amazonbot
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /
User-agent: *와 Disallow: /를 함께 쓰면 AI 크롤러뿐 아니라 구글과 빙의 검색 색인을 포함해 모든 자동 방문자를 차단한다. AI 크롤러만 제한하려면 제외할 크롤러의 이름을 지정하고 와일드카드 그룹은 그대로 두는 편이 범위를 좁힐 수 있다. Google-Extended와 Applebot-Extended는 그 자체로 크롤러가 아니라 학습 거부 신호다. 이를 차단하면 일반 검색에는 영향을 주지 않고 구글과 애플이 콘텐츠를 AI 학습에 쓰지 않도록 요청한다. 업체가 크롤러를 추가하거나 이름을 바꾸므로 목록은 바뀔 수 있다. robots.txt는 요청을 기록할 뿐 강제하지 않으며, 실제 준수 여부는 크롤러에 달려 있다.
이번 조사는 사이트 11만744곳에서 robots.txt를 한 번씩 가져와 분석한 결과다. 표본은 규모가 크지만 기업 웹사이트를 보유한 조직 쪽으로 치우쳐 있어 웹 전체를 대표하지 않는다. 따라서 결과는 ‘관측한 조직 가운데’의 수치로 봐야 한다. GPTBot 차단 규칙은 사이트가 오픈AI 크롤러에 접근하지 말라고 요청했다는 뜻이지, 크롤러가 실제로 이를 따랐다는 증거는 아니다. 규칙이 없다는 사실도 동의를 뜻하지 않는다. 이는 조사 대상 5곳 중 4곳에서 확인된 침묵이다. 트래픽이 많은 뉴스 도메인만 표본으로 삼으면 규칙을 추가한 언론사가 많이 포함되므로 차단 비율이 더 높게 나올 수 있다.
조사 방식은 사이트의 robots.txt를 실시간으로 한 번 가져와 사용자 에이전트 차단 규칙을 확인하는 것이었다. 오픈AI, 앤스로픽, 구글, 메타, 아마존, 애플, ByteDance, Common Crawl, Perplexity, Cohere, Mistral, DuckDuckGo의 학습·검색·사용자 요청 처리 목적을 아우르는 크롤러 토큰 19종(규칙 세트 v1.0)을 확인했다. 특정 사이트의 robots.txt가 해당 토큰을 직접 또는 와일드카드 규칙으로 차단하면 그 크롤러를 차단한 것으로 집계했다. Google-Extended와 Applebot-Extended는 크롤러 자체가 아니라 학습 거부 신호지만, 실제로는 해당 업체의 AI 사용을 거부하는 설정으로 집계했다. 집계는 도메인별 최신 가져오기 결과를 중복 제거해 사이트당 한 건으로 계산했다. 스냅샷 날짜는 2026년 10월 8일이다.
크롤러별 차단 조직 목록에서 조사 결과를 살펴볼 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요