추측 디코딩(speculative decoding)은 토큰을 생성할 때 연산량을 줄여서가 아니라, GPU가 놀리고 있던 연산 자원을 활용해 작은 배치에서 속도를 높인다. 다만 배치가 커지거나 초안 토큰이 많이 거부되면 추가 작업이 오히려 낭비가 될 수 있다.
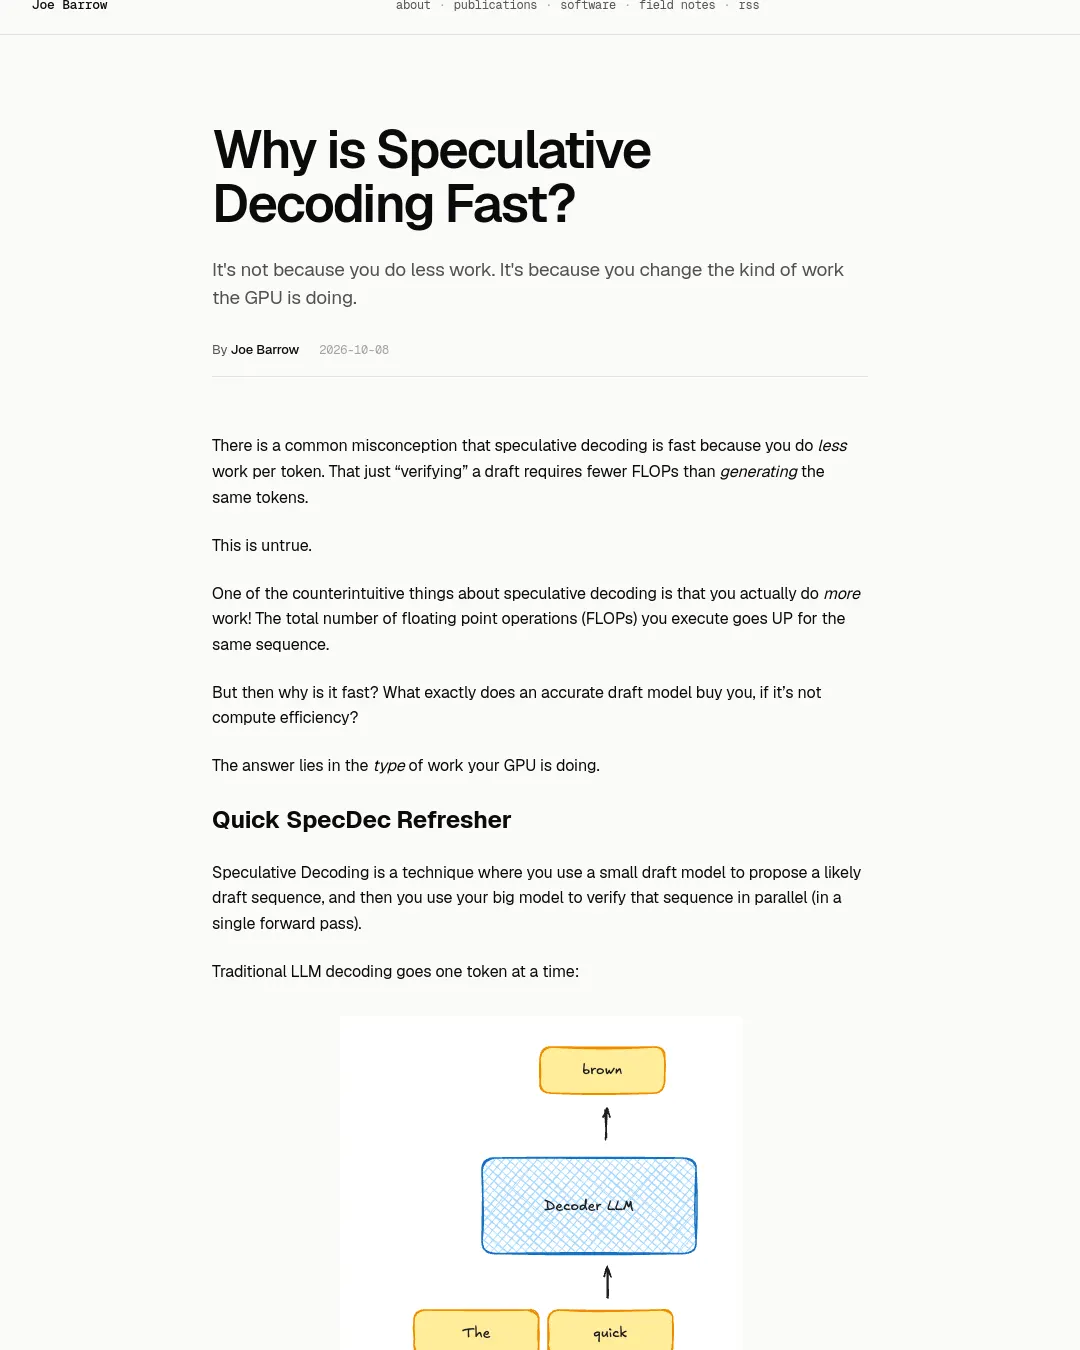
추측 디코딩은 작은 초안 모델이 다음 토큰 후보를 제안하고, 큰 모델이 한 번의 순전파로 후보들을 병렬 검증하는 방식이다. 같은 토큰을 생성하는 데 필요한 부동소수점 연산(FLOPs)은 오히려 늘어난다.
토큰을 하나씩 생성할 때는 모델의 활성 매개변수를 매번 메모리에서 불러와야 하므로 메모리 병목(memory-bound)이 생긴다. GPU가 연산을 더 할 수 있어도 데이터를 기다리느라 활용되지 않는 셈이다. 반면 한 번에 많은 토큰을 처리하면 연산 병목(compute-bound)이 된다. 메모리 병목 상태에서는 토큰 생성에 걸리는 시간이 크게 늘지 않은 채 여러 시퀀스를 처리할 수 있다.
가령 한 번의 순전파에서 처리하기에 적절한 토큰 수가 5개라면, 시퀀스 5개에서 토큰을 하나씩 생성하거나 한 시퀀스에서 추측 디코딩으로 토큰 5개를 검증할 수 있다. 두 경우 GPU의 작업량은 대체로 같지만, 전자는 5개 시퀀스가 조금씩 진행되고 후자는 한 시퀀스가 더 많이 진행된다. 배치가 작을 때 추측 디코딩은 남는 연산 자원으로 시퀀스를 더 빨리 완성하게 해준다. 그러나 배치를 늘린 상태에서 같은 깊이로 추측하면 연산 병목이 생겨 전체 시퀀스가 느려질 수 있다.
실제 처리량을 다룰 때는 이 차이가 중요하다. 초안 토큰이 승인되지 않으면 추가 작업이 낭비되며, 처리량이 높은 상황에서는 추측 디코딩을 끄는 편이 나을 수도 있다. vLLM은 --speculative-disable-by-batch-size 매개변수로 특정 배치 크기에서 추측 디코딩을 끌 수 있다. 이 설정은 vLLM 문서에 설명돼 있다.
이 글은 배치 크기에 따라 추측 깊이를 조절하거나 시퀀스마다 다르게 적용하는 아이디어도 소개한다. 이는 dSpark 같은 아이디어의 핵심 직관이다. GPU 작업 유형에 관한 자세한 배경은 Roofline 모델 시각 안내에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요