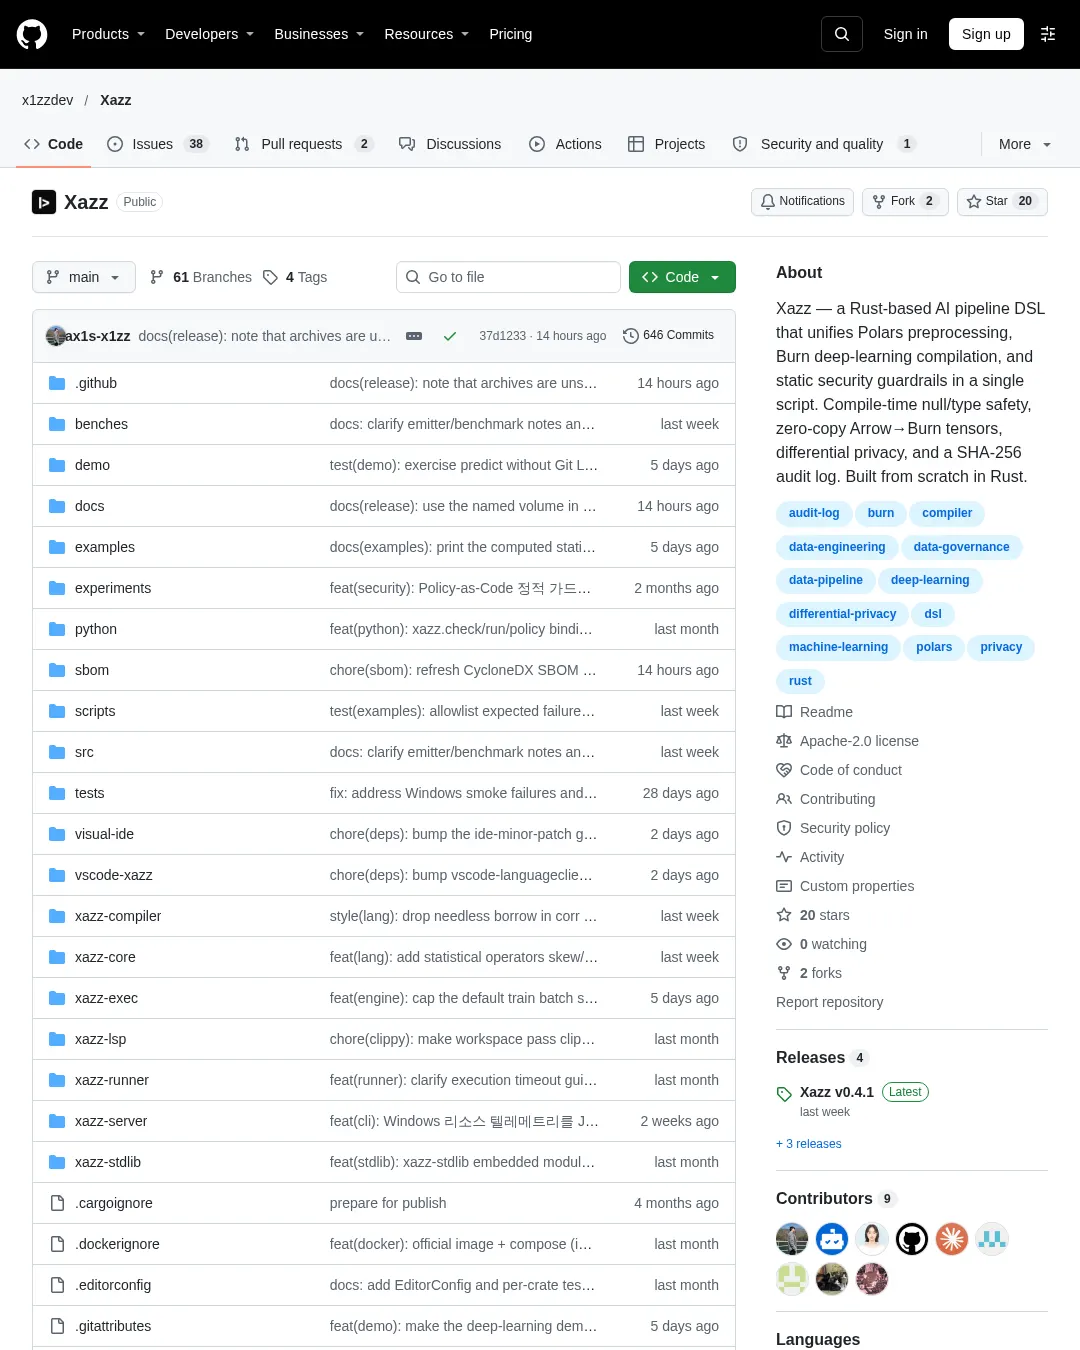
Xazz는 Rust로 만든 AI 파이프라인용 도메인 특화 언어(DSL)다. 스크립트를 컴파일하며 실행 전에 타입·개인정보·보안 정책을 검사하고, 차등 프라이버시 예산과 감사 기록을 관리한다. 제작자는 Python이나 데이터 처리 엔진을 대체하기보다 파이프라인의 거버넌스 계층을 목표로 한다.
저장소와 사용 안내는 GitHub 저장소에서 확인할 수 있다. 문서는 영어, 한국어, 일본어, 중국어로 제공된다.
파이프라인 검사와 실행
저장소는 서울 대기질 CSV 데이터를 읽고 결측치를 채운 뒤 구별로 미세먼지 농도를 집계하고, 차등 프라이버시를 적용해 차트를 만드는 예를 든다. 예제에서 pm25는 Option<float>로 선언돼 결측값이 타입에 포함된다. fillNull에 결측이 없는 컬럼을 전달하면 실행 중 문제가 생기는 대신 컴파일 단계에서 line:col 오류가 발생한다.
실행 로그 예시는 다음과 같다. 기본 개인정보 정책 검사를 통과하고, 가우시안 노이즈를 적용한 뒤 HTML 차트를 만든다.
$ xazz run report.xzz
[xazz] static guardrail: xazz-builtin-pii — policy check passed — no violations
[xazz] DP applied: gaussian (ε=0.5, δ=1.00e-5, Δf=2, noise parameter=19.3792) — columns ["pm25"] | budget ε 0.50/10.00 · δ 1.00e-5/1.00e-4
[xazz] Pipeline #4 'noised' done: 5 × 2
[xazz] 📊 chart generated HTML: bars_chart.html
제작자가 설명하는 실행 전후 보호 기능은 네 가지다.
- 컴파일 시
Option<T>타입과 결측값 처리를 검사한다. 잘못된fillNull사용은 실행 전line:col진단으로 표시한다. - 정책 검사는 직접 식별정보 노출, 개인정보·비밀정보 리터럴, 차등 프라이버시 없이 수행되는 민감한 집계를 차단하며, 기본적으로 실패 시 허용하지 않는다.
withDp는 테넌트별 ε/δ 예산을 관리한다. 기본·Rényi·zCDP 합성 방식으로 누적량을 계산하고, 설정된 한도를 넘는 쿼리를 거부한다.- 실행마다 SHA-256 해시를 추가한다.
GET /security/audit/chain은 체인을 검증하고 손상된 기록을 가리킨다.
설치와 첫 실행
미리 빌드한 프로그램은 Releases에서 운영체제에 맞는 압축 파일을 내려받아 설치한다. Windows x64 파일은 xazz-<version>-windows-x64.zip, Linux x64 파일은 xazz-<version>-linux-x64.tar.gz, macOS arm64 파일은 xazz-<version>-macos-arm64.tar.gz다. 압축을 풀고 실행 파일이 있는 디렉터리를 PATH에 추가한다. xazz, xazz-runner, xazz-exec는 같은 디렉터리에 둬야 한다. xazz run은 xazz-runner를 프로세스 격리된 하위 프로세스로 실행하고, runner가 같은 디렉터리의 xazz-exec를 실행 제한 시간과 함께 호출한다. 이는 격리이지 운영체제 수준의 샌드박스는 아니다.
배포 바이너리는 서명·공증되지 않았다. macOS Gatekeeper가 실행을 차단하면 xattr -dr com.apple.quarantine xazz/를 실행하거나 시스템 설정의 개인정보 보호 및 보안에서 허용한다. Windows SmartScreen은 ‘추가 정보’를 누른 뒤 실행하도록 안내할 수 있다. xazz --help의 기본 언어는 영어이며, 한국어 진단은 XAZZ_LANG=ko로 설정한다.
소스 빌드에는 안정 버전 Rust가 필요하다.
git clone https://github.com/x1zzdev/Xazz.git
cd Xazz
cargo build --release -p xazz -p xazz-runner -p xazz-exec
# the three binaries land in target/release/
GPU·ONNX 가속은 xazz-exec의 선택적 Cargo 기능으로 제공된다. wgpu, cuda, onnx, onnx-cuda, onnx-tensorrt, onnx-directml, onnx-coreml 중 빌드 기능을 선택하며, 실행 시 XAZZ_BACKEND와 XAZZ_DEVICE로 설정한다. 플랫폼별 빌드 조합과 장치 설정은 GPU 백엔드 문서에 있다.
브라우저 데모는 공개된 멀티아키텍처 Docker 이미지로 실행할 수 있다.
docker run --rm -p 8005:8005 -v xazz-data:/data ghcr.io/x1zzdev/xazz:0.4.1
# open http://127.0.0.1:8005
저장소를 복제한 경우 루트에서 docker compose up을 실행하면 xazz:local을 빌드한다. 이는 Rust 전체 빌드를 수행하므로 오래 걸릴 수 있다. IDE에는 합성 대기질 데이터와 Monitor 탭의 ‘안전한 예 확인’, ‘안전하지 않은 예 확인’ 버튼이 있다. 두 버튼은 정적 정책 검사만 하며 예제를 실행하지 않는다. ‘전체 실행’은 현재 파이프라인을 실행하고 명시적 확인을 요구한다. 두 방식 모두 실행 기록, 감사 기록, 업로드와 산출물에 Docker 관리 xazz-data 볼륨을 쓴다. 기존 ./data 바인드 마운트 사용자는 마운트를 바꾸기 전에 업그레이드 절차를 따라야 한다.
첫 파이프라인은 프로젝트와 CSV 예제를 만든 다음 CSV에서 스키마를 추론하고 실행하는 과정이다.
xazz new my-project # scaffold a project + sample CSV
cd my-project
xazz import data/sample.csv # auto-infer the schema → writes a type block into main.xzz
xazz run main.xzz # compile + execute
xazz run main.xzz --opt # optional: enable the typed-IR optimization pass
xazz import는 CSV를 읽고 컬럼 타입을 추론해 main.xzz에 스키마 선언을 만든다. EUC-KR/CP949는 자동 감지한다. 구분자가 다르면 --delimiter ';'처럼 ASCII 문자 하나를 지정하고, 첫 행이 헤더가 아니면 --no-header를 쓴다. 후자의 경우 컬럼 이름은 column_1..N이 된다. --opt는 실행 전에 타입 IR 최적화(예: 필터 재배치)를 적용하며, 저장소는 최적화 경로와 비최적화 경로의 동등성을 시험했다고 설명한다.
언어와 구현 구조
저장소는 pandas와 PyTorch를 조합하는 작업과 Xazz의 .xzz 파이프라인을 비교한다. Xazz 예제는 스키마에 pm10: Option<float>을 선언하고 Polars 전처리, Burn 모델 정의, 학습·예측·차트 생성을 하나의 파이프라인으로 표현한다. 제작자의 비교에 따르면 Xazz는 전처리부터 딥러닝까지 단일 DSL로 연결하고, Arrow 버퍼를 직접 전달하며, 타입·결측값을 컴파일 시 검사한다. 나머지 메모리 복사는 모델에 명시적으로 반영한다고 설명한다. 모델 입력 차원과 손실 함수는 자동 추론한다고 소개한다.
Xazz는 기존 라이브러리를 감싼 래퍼가 아니라고 제작자는 설명한다. 파서, AST, 정적 타입 검사기, 타입 IR, 하향 변환기와 딥러닝 컴파일 엔진을 Rust로 새로 구현했다. .xzz는 타입 IR로 한 번 컴파일되고 런타임은 그 IR을 소비한다. 소스를 다시 파싱해 원시 AST를 Polars/Burn에 직접 해석시키는 방식이 아니라는 설명이다.
Xazz는 Polars를 실행 엔진으로 사용한다. 제작자는 DuckDB와 Polars가 데이터 실행 엔진으로는 적합하지만, 타입·결측값 정확성, 개인정보·비밀정보 노출, 차등 프라이버시 예산과 감사 기록을 실행 허가 조건으로 자체 결정하지는 않는다고 구분한다. Xazz는 행을 읽기 전에 타입 IR을 정적 검사해 이런 게이트를 적용한다. 빠른 SQL·DataFrame 실행만 필요하다면 DuckDB나 Polars를 쓰고, 파이프라인 자체의 컴파일·정책 관리·감사가 필요한 경우를 Xazz의 대상으로 제시한다.
Python의 pandas→NumPy→PyTorch 경계에서는 메모리 복사가 반복될 수 있다는 점도 제작자가 문제로 든다. Xazz는 한 Rust 프로세스에서 Arrow 버퍼를 직접 읽으며, f64에서 f32로의 변환, 컬럼형에서 행 우선 형식으로의 변환, 호스트에서 장치로의 이동 등 남는 복사를 메모리 모델에 명시한다고 설명한다. Xazz의 목적은 pandas·Polars·DuckDB 같은 연산 엔진이나 PyTorch를 대체하거나 GPU 커널 성능으로 경쟁하는 것이 아니라, 그 위에서 컴파일과 거버넌스를 제공하는 것이다.
Rust 워크스페이스는 모듈식으로 나뉜다. CLI 바이너리 크기는 2~5MB이며 무거운 엔진은 xazz-runner 하위 프로세스 경계 뒤에 둔다.
xazz:run,check,import,emit,policy,sde,newCLI 진입점.xazz-core: AST, 토큰, 오류, 타입 IR, 공유 타입.xazz-compiler: 렉서, 파서, AST, 정적 분석, 타입 IR, 최적화, 출력.xazz-exec: 타입 IR 런타임.lower는 DataOp를 Polars로,dl은 Burn으로 처리하며 차등 프라이버시와 차트 기능도 맡는다.xazz-runner: 프로세스 격리 하위 프로세스 연결(IPC)과 실행 제한 시간.xazz-server: Axum REST API, SHA-256 감사 로그, 소형 언어 모델(sLM) 수정 훅, IDE 제공.
자세한 내용은 아키텍처 문서, 워크스페이스 문서, 용어집, 도표 편집 원본과 재생성 절차를 참고할 수 있다.
성능 측정과 조건
저장소는 pandas 3.0.6과 Xazz에서 같은 4단계 파이프라인(결측값 제거, 이중 필터, 그룹 집계, 채우기와 개수 계산)을 서울 대기질 원자료 8개(2008~2026년)로 실행했다. 워밍업 뒤 세 번 측정한 중앙값이며, 각 엔진의 내부 파이프라인 실행 시간을 비교했다. 저장소가 제시한 결과는 다음과 같다.
| 행 수 | Xazz와 pandas 비교 | pandas 시간 | Xazz 시간 |
|---|---|---|---|
| 228K | 2.04배 | 155ms | 76ms |
| 912K | 3.84배 | 548ms | 143ms |
| 4.09M | 2.14배 | 2,457ms | 1,148ms |
4.09M행에서 최대 RSS는 pandas 635MB, Xazz 405MB였으며 저장소는 모든 규모에서 Xazz의 최대 RSS가 낮았다고 보고한다. 속도 차이는 912K행에서 가장 컸다가 4.09M행에서 줄었다. 비교는 파이프라인 실행만 포함한다. pandas의 Python 인터프리터 시작 시간(약 0.3~0.7초)은 제외했고, Xazz는 [xazz:timing] 파이프라인 구간을 쓴다. 이 구간은 xazz-runner/xazz-exec 프로세스 생성·시작 시간도 제외한다. 따라서 228K행의 측정 시간은 셸에서 체감하는 전체 시간보다 짧을 수 있으며, 재현 시 시작 시간 차이는 startup_ms에 따로 기록된다. 최대 RSS는 양쪽 모두 프로세스 트리를 기준으로 계산했다.
제작자는 Arrow 컬럼형 메모리, Polars LazyFrame 쿼리 최적화, 멀티스레드 네이티브 실행을 성능 요인으로 든다. load()는 지연 스캔(scan_csv/scan_parquet/scan_ipc)을 반환해 최종 수집 단계 전까지 원본을 메모리에 전부 올리지 않는다. 대규모 작업은 XAZZ_STREAMING=1로 Polars 스트리밍 엔진을 사용할 수 있으며, 지원하지 않는 계획은 자동으로 메모리 내 처리로 돌아간다. 자세한 계획은 로드맵 Track A2에 있다.
저장소는 Polars의 멀티스레딩이 지연 시간을 줄이는 대신 최대 RSS를 높일 수 있다고 덧붙인다. pandas는 스레드마다 더 많은 행을 보유하고 Polars는 행을 병렬화한다는 설명이다. 벤치마크 데이터는 저장소에 포함되지 않고 서울 대기질 원자료에서 생성된다. 수치는 2026-10-13, Windows 11 단일 호스트(Intel Core Ultra 9 185H, 물리 코어 16개/논리 코어 22개, RAM 63.5GiB)에서 Python 3.12.12, pandas 3.0.6, NumPy 2.5.3, 커밋 f1e55cb의 릴리스 빌드로 측정했다. 호스트 사양, 라이브러리 버전, 바이너리 SHA-256, 입력 파일 해시는 benches/benchmark_results.json의 provenance에 기록돼 있고, 같은 실행을 행별로 다시 확인한 자료는 benches/results/windows-cpu-readme-2026-10-13.verification.json이다.
이 수치는 기록이 남지 않은 다른 호스트와 load()가 지연 스캔이 되기 전의 구 런타임에서 나온 이전 결과 0.76배/1.44배/1.30배를 대체한다. 입력 데이터와 파이프라인은 같다고 저장소는 설명한다. 다만 측정은 단일 Windows 노트북에서만 이뤄졌고 Linux·macOS나 두 번째 호스트에서 재현되지 않았다. 따라서 비율은 보장값이 아니라 참고 결과로 봐야 한다.
재현 명령은 다음과 같다.
git lfs pull # fetch examples/data (Git LFS)
python benches/make_scale_data.py # build scale datasets from examples/data
python benches/run_readme_benchmark.py # pandas vs xazz, median of 3
python benches/render_benchmark_chart.py # regenerate the chart above

# optional: 200M-row scale (out-of-core + streaming)
python benches/make_scale_data.py --xlarge # ~200M rows, several GB
python benches/run_readme_benchmark.py --xlarge
측정 자료와 재현 스크립트는 벤치마크 실행 파일과 성능 설명에 있다.
보안·프라이버시 기능
정책 규칙은 주민등록번호, 전화번호, Luhn 검증을 거친 카드 번호 패턴과 비밀정보를 검사하며 사용자 규칙도 지원한다. 위반은 구조화된 JSON 보고서와 함께 차단된다. 선택 기능인 로컬 sLM 훅은 Ollama(예: Qwen2.5-Coder)가 안전한 수정을 제안하도록 하고, 채택 전에 같은 정책 엔진으로 다시 검증한다. 기본적으로 코드는 장치 밖으로 나가지 않는다고 저장소는 설명한다. 구현 내용은 보안 가드레일 문서에 있다. 규정 근거는 감사 추적용 참고이지 법률 자문이 아니다. 규정 매핑 우선순위, 적용 범위·신뢰도와 검증 절차는 규정 매핑 문서에 설명돼 있다.
차등 프라이버시는 Laplace·Gaussian 메커니즘과 ε·δ 합성 회계를 지원한다. 각 쿼리는 (εᵢ, δᵢ)를 기록하고 PrivacyBudget은 Σεᵢ, Σδᵢ를 누적한다. 둘 중 하나의 한도를 넘는 쿼리는 거부되며, 예산 상태는 IDE 모니터에서 확인할 수 있다. 자세한 내용은 차등 프라이버시 사양에 있다.
SHA-256 추가 전용 감사 로그는 모든 작업을 해시로 연결한다. 변조 여부는 xazz-server API의 /security/audit와 /security/verify로 검증할 수 있다. GenAI 거버넌스 Track F에서는 추론과 LoRA/QLoRA 미세조정이 burn-engine에 포함되는 방향에 맞춰 프롬프트 리터럴 컴파일 단계 검사, LLM 응답 재검사, 학습 데이터가 엔진에 들어가기 전 개인정보 제거·중복·편향 검사로 세 게이트를 확장할 계획이다. 로드맵 Track F에 설명돼 있다.
기능 상태는 다음과 같다.
- 정적 가드레일: 개인정보·비밀정보 탐지, 실행 차단,
--fix제안 — 안정화. - 차등 프라이버시: Laplace/Gaussian, 세션별 ε·δ 합성 회계, IDE 모니터 — 안정화.
- 감사 인프라: SHA-256 해시 체인, 추가 전용 기록, API 검증 — 안정화.
- sLM 자동 수정: 로컬 Ollama(Qwen2.5-Coder) 훅과 결정론적 대체 경로 — 미리보기.
주요 기능과 상태
xazz run:.xzz컴파일·실행.--json은 기계 판독 결과,--opt는 타입 IR 최적화 기능이며 안정화됐다.xazz check: 미선언 변수·컬럼, 중복 선언, 잘못된 형 변환을 정적으로 분석하고 유사 항목 제안과line:col위치를 제공한다. 안정화됐다.xazz import: 스키마를 추론해type블록을 생성한다. CSV의 EUC-KR/CP949, Parquet, Arrow를 지원하며 CSV에는--delimiter와--no-header가 있다. 안정화됐다.import "mod.xzz": 파일 간type·model·v파이프라인 공유 모듈 기능. 순환 참조는 기본 거부 방식으로 처리한다. 안정화됐다.import "std/...":std/common의 스키마와std/math,std/models모델을 포함하는 표준 라이브러리. 안정화됐다.xazz-lsp:xazz check진단과 심볼 테이블 기반 호버·정의로 이동·이름 바꾸기를 제공한다(Track B3). 안정화됐다.- VS Code 확장
vscode-xazz/: LSP 클라이언트, Run/Check 명령, 구문 강조. 미리보기 상태다. - Docker 이미지:
Dockerfile,docker-compose.yml로 서버·runner·exec·IDE를 제공하고/data를 마운트한다. 포트·볼륨·권한은 Docker 문서에 있다. 공개 멀티아키텍처 GHCR 이미지0.4.1,latest는 linux/amd64에서 스모크 테스트를 거쳤다(Track E2, #176). 미리보기 상태다. - CI 액션:
.github/actions/xazz복합 액션과 정책 게이트 워크플로(Track E3). 미리보기 상태다. xazz new: 샘플 CSV와 실행 가능한 예제 프로젝트를 만든다. 안정화됐다.xazz emit rust:.xzz를 Polars LazyFrame과 Burn을 사용하는 Rust 소스로 변환한다. 안정화됐다.xazz policy: 실행 전 개인정보·비밀정보 유출을 차단한다. 안정화됐다.model {}와train(): Burn 딥러닝 모델 선언·학습, Adam과 MSE, 검증 분할, 조기 종료, 하이퍼파라미터 탐색과metric:선택,sort:/top:보고서 정렬, 체크포인트를 지원한다. 안정화됐다.withDp(epsilon:): Laplace/Gaussian 노이즈와 예산 추적을 지원한다. 안정화됐다.- 내장
chart {}: bar·line·pie·scatter 형식의 HTML 차트를 만든다. 안정화됐다. load()와save(): 확장자로.parquet/.arrow를 자동 감지하고 CSVsep:/header:옵션과 CSV·Parquet·Arrow 출력물을 지원한다. 안정화됐다.- DuckDB 연결:
load("duckdb://...?sql=...")로 메모리 또는 파일 기반 DuckDB를 파이프라인 소스로 사용한다. 시스템 설치 없이 포함되며 제한은 연결기 문서에 있다(Track A3). 안정화됐다. - PostgreSQL 연결:
load("postgres://...?sql=...")로 쿼리를 파이프라인 소스로 쓴다. 암호화되지 않은NoTlsTCP를 사용하며 제한은 같은 연결기 문서에 있다(Track A3). 안정화됐다. Option<T>타입 시스템: 결측 안전 컬럼 선언을 제공하며, null이 허용되지 않는 컬럼에fillNull을 쓰면 컴파일 오류가 난다. 안정화됐다.- 32개 파이프라인 연산자:
filter,groupBy,agg([...]),join,withColumn,cast,sample,median,std,skew,kurtosis,quantile,corr,histogram,outlierIqr등이 안정화됐다. - 시각 IDE: 노드 기반 파이프라인 편집기와 모니터를
xazz-server로 제공한다. 안정화됐다. - 실행 이력: SQLite에 실행 기록을 저장하며
GET /runs,GET /runs/:id를 지원한다(Track C1). 안정화됐다. - 인증·다중 테넌트:
XAZZ_SERVER_TOKEN/XAZZ_TENANT_TOKENS와X-Xazz-Tenant,XAZZ_ADMIN_TOKEN과X-Xazz-Actor를 지원한다.XAZZ_ADMIN_ACTORS=token:actor로 행위자를 고정하면X-Xazz-Actor를 무시하므로 CLI--actor도 영향을 주지 않는다. 실행 이력과 감사 기록은 테넌트별로 분리된다(Track C2). 안정화됐다. - 서버 설정: 인증, 차등 프라이버시 예산, 정책 이력 보존, 바인딩과 경로 환경 변수는 서버 문서에 있다(Track C2). 안정화됐다.
- 파이프라인 카탈로그:
POST /catalog가 타입 IR에서 파이프라인 카탈로그와 컬럼 계보를 제공한다(Track C3). 안정화됐다. - Python 바인딩: Python에서
xazz.check/run/policy를 호출하며 CLI와 같은 진단을 반환한다(Track C4). 안정화됐다. xazz sde: 합성 데이터 생성 엔진. 안정화됐다.xazz registry:xazz.policy.json정책 팩과std/표준 라이브러리 모듈을 오프라인에서 찾아 설치한다.registry deploy/registry undeploy는 서버를 통해 테넌트 팩을 배포·제거한다(Track E4/C2). 안정화됐다.xazz policy-status/xazz policy-ttl: 실행 중인 서버의 테넌트 정책 상태(history/ttl/ttl-history)를 읽고 정책 이력 보존 기간 재정의를 설정·해제한다.--json/--cursor/--actor를 지원한다(Track C2). 안정화됐다.xazz dp window/xazz dp budget/xazz dp reset: 서버에서 테넌트의 차등 프라이버시 예산을 읽거나 변경한다.window set/clear/history는--window-secs/--json/--cursor/--limit/--actor를 지원한다. 현재 지출과 잔여 한도는dp budget으로 보고,dp reset/dp reset-history는 장부를 지우고 행위자를 감사 기록에 남긴다. 둘 다 커서 페이지 처리를 지원한다(Track C2). 안정화됐다.xazz sanitize: 미세조정 데이터의 개인정보 검사, 중복 및 편향 검사를 수행한다(Track F3). 안정화됐다.- 모델 출처 확인: 정책 레지스트리 게이트가
hf://모델 참조를 검사하고 라이선스가 없거나 가중치가 불명확한 모델을 차단한다(Track F5). 안정화됐다.
--tenant에 관한 예외도 있다. 위 테넌트 명령은 --tenant를 받지만 서버가 단일 토큰 모드(XAZZ_SERVER_TOKEN)로 실행되면 X-Xazz-Tenant를 무시하고 빈 테넌트에서 작동한다. 이때 --tenant는 받아들이기만 할 뿐 효과가 없다. 향후 호환성을 위해 옵션을 유지한다. 자세한 내용은 서버 문서에 있다.
시연과 예제
저장소는 화면 자료가 저장소의 target/release 바이너리, demo/ 예제, visual-ide/ IDE와 포함된 서울 대기질 샘플로 만든 것이라고 설명한다. 정적 분석은 실행 전에 오타를 찾아 수정 제안을 주고 JSON 출력에 line:col을 포함한다. 재현 가능한 네 사례는 진단 모음에 있다. 예제 화면은 Polars 전처리와 HTML 차트(demo/preprocess_chart.xzz), Burn 학습(demo/deep_learning.xzz; 모델 선언을 Burn 계층으로 컴파일하고 실제 에포크 손실과 체크포인트를 기록), Laplace 메커니즘과 ε 예산을 사용하는 차등 프라이버시(demo/dp.xzz), SHA-256 코드 해시·학습 손실·예산 모니터링이 포함된 IDE 실행 영수증을 보여준다.
실행 가능한 .xzz 파이프라인은 examples/에 있다. 간단한 막대 차트부터 차등 프라이버시, Burn 학습, DuckDB/PostgreSQL 소스와 보안 가드레일 시연까지 포함한다. 목록에는 각 예제의 명령과 Git LFS 데이터·생성기·로컬 데이터베이스 등 선행 조건이 적혀 있다. CI의 Example smoke 작업은 예제를 모두 검사하고 실행한다.
제한과 미완성 항목
Xazz는 1.0 이전 버전이다. 저장소는 설치 뒤에야 알게 되는 일을 줄이겠다며 확인되지 않은 사항을 공개하고, 이 제한 목록을 릴리스 노트에도 반영한다고 밝힌다.
- 기본 실행 경로는 CPU다. GPU는 선택 기능이며
XAZZ_BACKEND/XAZZ_DEVICE로 실행 시 고른다..xzz실행에 GPU는 필요하지 않다.burn-wgpu는 Windows 11의 RTX 4070 Laptop과 Intel Arc 통합 GPU에서 실제 하드웨어 인수 시험을 통과했다(2026-09-25).burn-cuda의 네이티브 CubeCL 패리티는 Windows 11 RTX 4070(windows-gnu, 2026-10-06)에서 통과했지만XAZZ_DEVICE=cuda:*를 지정한 CLI 종단 간 실행은 아직 검증되지 않았다. ONNX Runtime 내보내기·추론은windows-msvc에서 CPU와 CUDA 실행 제공자 시험을 통과했고 macOS CoreML은 대기 중이다.ort-sys는*-windows-msvc용 사전 빌드 바이너리만 제공하며 Windows GNU 도구 체인은 실패한다. 자세한 내용은 GPU 백엔드 문서와 Windows ONNX 시험 기록에 있다. - 네이티브 Python 확장은 아직 없다.
import xazz는 PyO3 모듈이 아니라 CLI를 호출하는 순수 Python 어댑터다. CLI와 같은 진단을 반환하지만 하위 프로세스 경계를 거친다. PyO3 경로와 NumPy/Pandas에서 Arrow로 넘기는 기능은 미뤄졌다(로드맵 Track C4). xazz emit rust는 참조용 출력기이지 별도의 런타임이 아니다. 새 언어 기능은xazz-exec에 먼저 들어가며, 생성된 Rust는 일부 학습 옵션(예: 단일 실행의validation_split/조기 종료, 에포크별 탐색 컬럼)을 따라오지 못할 수 있다. 실행의 기준은xazz run이며 생성 코드는 읽을 수 있는 참고 출력으로 취급해야 한다. 파이프라인이 학습·예측을 수행하면 생성 파일에serde_json크레이트가 필요하고,predict단계는 학습 중 기록되는checkpoints/<Model>.stats.json보조 파일도 읽는다. 이 파일 없이 생성 코드만 실행하면 실패한다. 생성 헤더에 필요한 Cargo 의존성이 적히며 출력 형태는xazz-compiler/src/emitter.rs의 emitter 시험으로 고정돼 있다.- GHCR 이미지는 공개돼 있지만 linux/amd64에서만 스모크 테스트됐다.
docker pull ghcr.io/x1zzdev/xazz:0.4.1은 익명으로 가능하다. 기록된 2026-10-30 실행은 Windows 11 한 호스트의 Docker Desktop에서 상태 확인, IDE, 정책 검사, 전체 실행, 실행 이력, 차등 프라이버시·감사 API, 볼륨 보존을 다뤘다. linux/arm64 이미지는 빌드됐지만 arm64 장비에서는 실행하지 않았고 이미지도 서명·공증되지 않았다(Docker 릴리스 이미지). - 벤치마크는 단일 호스트에서만 측정됐다. 출처 정보가 붙어 있지만 다른 호스트나 Linux/macOS에서 재현되지 않았으므로 성능 보장으로 해석해서는 안 된다.
- 운영체제 샌드박스가 아니다.
xazz-runner는 실행 제한 시간이 있는 프로세스 격리다. 정책 규칙은 알려진 위험 파이프라인 형태를 실행 전에 차단하지만, 배포 시PATH가로채기 주의점이 있다. 자세한 내용은 보안 가드레일 문서에 있다.
로드맵과 참여
핵심 언어(DSL 문법, 타입 시스템, 컴파일러), 실행 계층(Polars 연결, CLI, 차트 출력), IDE 통합은 완료됐다. 타입 IR과 최적화 단계는 v0.3.0에서 완료됐고, 단일 타입 중간 표현, 중복 파싱 제거, --opt 최적화를 포함한다. 언어 확장 단계는 연산자 추가, 조인 개선, 스키마 변경을 진행 중이다. 데이터 규모 단계에서는 Parquet·Arrow load/save가 구현돼 완료로 표시됐다(#52). AI 확장 단계의 GPU 백엔드(burn-cuda/burn-wgpu), 분산 학습, NQP는 계획 단계다. GenAI 거버넌스는 프롬프트 입력 게이트, LLM 출력 재검사, burn-engine LoRA/QLoRA 연계 미세조정 데이터 정제와 모델 출처 확인을 계획한다(Track F). 다국어 문서, Discussions, 릴리스·기여 안내와 로컬 플레이그라운드를 포함한 커뮤니티 Track G는 진행 중이며 이슈 #155에서 다룬다. 데이터 규모, 프로그램 크기, 팀·조직 범위, ML 깊이를 확장하는 전체 계획은 로드맵 문서에 있다.
Xazz는 오픈소스 프로젝트다. 질문과 아이디어는 Discussions, 재현 가능한 버그는 Issues, 코드는 Pull Request로 제안할 수 있다. 취약점은 비공개 보안 제보로 전달한다. 로컬 빌드와 기여 방법은 CONTRIBUTING.md에 있다. 라이선스는 Apache-2.0이며 LICENSE에서 확인할 수 있다. 상용 이용 자격(제품 키)은 계약상 표식이며 법적으로 집행된다는 설명은 라이선스 설계 문서에 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요