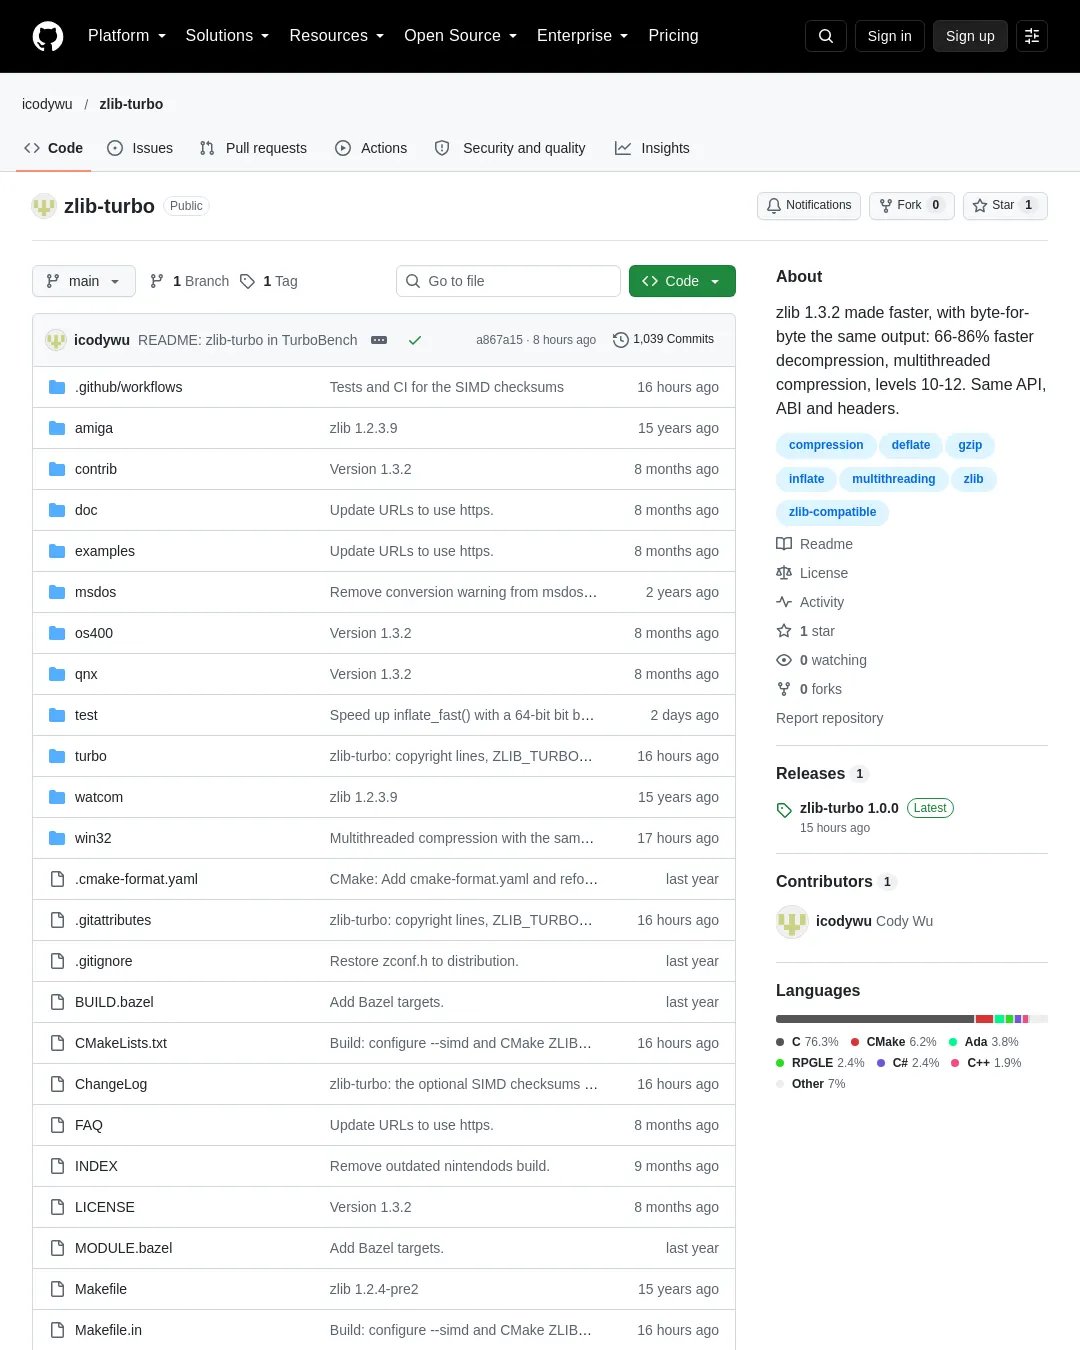
zlib-turbo는 더 빠르면서도 zlib과 바이트 단위로 동일한 결과를 내도록 만든 zlib 1.3.2다. zlib과 API, ABI, 헤더가 같고(zlib.h는 변경되지 않았다), zlib이 지원하는 모든 입력과 설정에서 압축 결과가 같다. 손상된 스트림을 포함해 모든 스트림을 zlib과 같은 출력과 오류로 해제한다고 프로젝트는 설명한다. 프로그램이나 패키지, 시스템에서 zlib을 대체할 수 있으며, 달라지는 것은 속도뿐이라는 주장이다.
벤치마크는 AMD EPYC 9334와 GCC 14 -O2에서 별도 언급이 없으면 코어 하나로 수행했다.
| 작업 | zlib 1.3.2 | zlib-turbo | 차이 |
|---|---|---|---|
| Silesia 해제, 레벨 6 스트림 | 438 MB/s | 739 MB/s | +69% |
| enwik8 해제, 레벨 6 스트림 | 349 MB/s | 621 MB/s | +78% |
| Silesia 압축, 레벨 1 | 114 MB/s | 151 MB/s | +32% |
| Silesia 압축, 레벨 6 | 31.9 MB/s | 36.0 MB/s | +13% |
| Silesia 압축, 레벨 6, 스레드 16개 | 31.9 MB/s | 218 MB/s | 6.8배 |
| Silesia 최소 출력 크기(zlib 레벨 9, zlib-turbo 레벨 12) | 67.64 MB | 64.58 MB | -4.5% |
| Silesia gzip 스트림 해제, 선택형 SIMD 체크섬 | 418 MB/s | 806 MB/s | +93% |
| 레벨 0~9 압축 출력 | 동일 |
zlib-turbo는 선택 기능도 세 가지 추가한다. 첫째, 멀티스레드 압축은 결과를 zlib과 동일하게 유지한다. 둘째, 준비된 사전을 사용하면 같은 사전으로 여러 작은 메시지를 압축할 때 최대 4배 빨라질 수 있다. 셋째, 레벨 10~12는 최적 파싱을 사용해 레벨 9보다 더 작게 압축한다. 이 레벨의 출력은 유효한 deflate 데이터지만 zlib에는 해당 레벨이 없어 zlib 출력과 같지 않다. 이 기능을 사용하지 않는 프로그램에서는 일반 zlib처럼 동작한다. x86 프로세서용 SIMD 체크섬은 빌드 옵션으로 켤 수 있으며 기본값은 꺼져 있다.
새로 추가한 기능과 근거
프로젝트는 zlib 1.3.2의 수정되지 않은 버전과 결과를 비교해 동일성을 확인했다고 밝힌다. 테스트에는 세 개 코퍼스, 손상된 스트림 약 3만 5,000개, 약 8,000만 회의 차등 퍼징, 여섯 가지 프로세서 아키텍처와 MSVC가 포함됐다(테스트 방법). 개발자 측 설명에 따르면 단일 코어에서 압축 해제는 66~86%, 압축은 4~39% 빨라졌으며 스레드를 사용하면 최대 12배 빨라진다.
- 출력을 바꾸지 않는 속도 개선: 레벨 0~9에서는 zlib의 작업 방식만 바꾸고 결정은 바꾸지 않는다는 것이 프로젝트의 보장이다. 같은 일치 구간을 같은 순서로 찾고, 같은 블록과 비트를 출력하며, 반환 코드도 같게 유지한다.
- zlib과 같은 결과를 내는 멀티스레드 압축: 레벨 4~9에서는 zlib의 해시 체인이 입력에만 좌우되므로, 지연 파싱이 찾을 일치 구간을 미리 검색할 수 있다. 작업 스레드는 입력 구간보다 조금 앞선 위치부터 zlib의 파싱을 재현하며, zlib이 검색할 위치와 체인 길이를 그대로 따른다. 호출 스레드는 zlib의 모든 결정을 유지하고 검색의 99.99%를 작업 스레드에서 가져온다. 완료된 블록도 zlib이 쓸 위치에서만 작업 스레드가 작성하므로 반환 코드와 대기 중인 출력까지 일치한다. 16개 스레드에서는 레벨 6이 zlib 1.3.2보다 6.8배, 레벨 9는 최대 12배 빠르며 바이트는 같다. 프로젝트는 단일 스레드 zlib과 같은 출력을 내는 다른 병렬 deflate 압축기를 알지 못한다고 설명한다. 일반적인 병렬 gzip 프로그램인 pigz는 별도 조각을 압축하므로 출력 바이트가 달라진다.
- 레벨 10~12: zlib API에서 libdeflate의 최고 설정보다 더 작게 압축하도록 최적 파싱 압축기를 구현했다. 구간마다 유지하는 이진 트리 매치 파인더, 정확한 비트 비용을 반복 계산하는 파싱, 동적 계획법에 따른 블록 경계, 블록별 최단 트리 부호화를 사용한다. 레벨 12는 Silesia, enwik8, Canterbury + Calgary에서 libdeflate 레벨 12보다 0.15~0.33% 작고 zlib 레벨 9보다 4.0~5.7% 작다. Zopfli와 비교하면 0.2% 이내의 크기이며 속도는 6~11배라고 프로젝트는 보고한다. zlib에 레벨을 지정할 수 있는 프로그램은 이 레벨도 요청할 수 있다.
- 준비된 사전: zlib은 스트림을 만들 때마다 사전을 다시 색인한다.
deflatePrepareDictionary()는 한 번 색인하고deflateUseDictionary()는 그 색인을 각 스트림에 복사한다. 그 결과deflateSetDictionary()와 정확히 같은 상태와 출력을 얻으며, 작은 메시지 압축은 최대 4.1배 빨라질 수 있다. - 빠른 해제기와 체크섬: 64비트 빠른 반복문, 분기 없는 비트 보충, 더 큰 첫 단계 테이블, 넓은 일치 구간 복사로 해제 속도를 66~86% 높이면서 유효하거나 손상된 모든 스트림에 대해 zlib과 같은 결과를 낸다는 설명이다. 이 해제기 변경은 zlib에 풀 리퀘스트 #793으로 제안됐다. 이식 가능한 SWAR Adler-32는 8바이트당 곱셈 세 번으로 zlib 형식 체크섬을 43% 빠르게 계산한다. 선택형 x86 SIMD 체크섬은 비트 단위로 같은 결과를 낸다. 캐리리스 곱셈을 쓰는 CRC-32는 5.5배, AVX2 Adler-32는 7.4배 빠르다. 이를 사용하면 gzip 스트림 해제 속도가 zlib 1.3.2보다 93% 높아진다.
- 측정 재현: 각 변경의 성능 향상을 따로 측정하고, 효과가 없었던 방법도 측정값과 함께
turbo/TECHNIQUES.md에 기록했다고 프로젝트는 밝힌다.turbo/스크립트로 임의의 zlib 소스 트리와 비교를 반복할 수 있다.
압축 결과가 같아야 하는 이유
zlib과 호환되는 더 빠른 라이브러리도 있지만, 프로젝트는 대표적인 사례인 zlib-ng가 단일 코어에서 zlib-turbo보다 빠른 대신 압축 방식이 달라 zlib이 쓸 바이트와 다른 결과를 만든다고 설명한다. 결과는 유효한 압축 데이터여도 압축된 데이터를 해시하거나 비교하는 시스템에는 문제가 될 수 있다.
- 2023년 1월 Git의 압축기를 바꾼 뒤 GitHub가 제공하는 소스 아카이브가 몇 바이트씩 달라졌다. 게시된 체크섬이 일치하지 않게 됐고, 변경을 되돌릴 때까지 Homebrew, Bazel 등 여러 프로젝트의 다운로드 검증 빌드가 실패했다.
- 컨테이너 이미지 계층은 압축된 바이트의 해시로 식별한다. 압축기가 달라지면 다이제스트가 새로 생겨 캐시를 놓치고 데이터를 다시 올려야 한다.
- 재현 가능한 빌드, 패키지 체크섬, 압축 파일을 저장해 두고 비교하는 테스트도 바이트를 비교한다.
zlib-turbo는 zlib의 결정을 바꾸지 않고 작업 방식만 빠르게 해 이러한 조건을 유지한다고 설명한다. 같은 일치 구간을 같은 순서로 찾고, 같은 블록을 만들며, 같은 비트를 쓴다는 것이다.
속도 측정
Silesia, Canterbury + Calgary, enwik8(enwik9의 처음 10^8바이트)를 각각 파일 전체 단위로 측정했다. AMD EPYC 9334(Zen 4, 2.7GHz)의 코어 하나, GCC 14.2 -O2, 두 번 측정한 값 중 빠른 결과다. 단위는 압축 해제 전 데이터 기준 MB/s다.
압축 출력은 모든 경우 zlib과 바이트 단위로 같다고 프로젝트는 보고한다.
| 레벨 | Silesia | Canterbury + Calgary | enwik8 |
|---|---|---|---|
| 1 | 114 → 151 (+32%) | 127 → 176 (+39%) | 99 → 138 (+39%) |
| 3 | 75 → 91 (+22%) | 72 → 90 (+24%) | 60 → 75 (+24%) |
| 6 | 31.9 → 36.0 (+13%) | 26.7 → 29.9 (+12%) | 24.4 → 27.2 (+12%) |
| 9 | 13.1 → 14.2 (+9%) | 8.3 → 8.6 (+4%) | 18.9 → 20.7 (+9%) |
아래 해제 수치는 각 레벨에서 zlib이 만든 zlib 스트림을 처리한 결과다. 한 번의 inflate() 호출 방식과, 입력 16KiB·출력 64KiB 조각 방식의 값을 함께 표시한다.
| 레벨 | Silesia | Canterbury + Calgary | enwik8 |
|---|---|---|---|
| 1 | 412 → 681 (+66%) / 385 → 592 (+54%) | 447 → 766 (+71%) / 419 → 659 (+57%) | 343 → 603 (+76%) / 318 → 496 (+56%) |
| 6 | 438 → 739 (+69%) / 409 → 649 (+59%) | 468 → 873 (+86%) / 437 → 755 (+73%) | 349 → 621 (+78%) / 325 → 528 (+62%) |
| 9 | 442 → 744 (+68%) / 413 → 653 (+58%) | 474 → 881 (+86%) / 441 → 762 (+73%) | 350 → 621 (+77%) / 325 → 528 (+62%) |
Silesia 레벨 6을 다른 컴파일러로 측정한 결과는 압축/해제 기준으로 GCC 11에서 +11%/+77%, clang 18에서 +12%/+62%였다. 64비트 연산을 에뮬레이션하는 32비트 x86에서는 +5%/+8%였다.
같은 기계와 컴파일러에서 zlib-ng 2.3.3 호환 모드는 zlib-turbo보다 해제가 15~20% 빠르다. SIMD 코드를 쓰지 않는 기본 빌드인 zlib-turbo는 zlib-ng 속도의 82~86%에 도달한다. zlib-ng는 압축이 2~3배 빠르지만 출력이 다르며, 레벨 1에서는 zlib보다 파일이 18~22% 크다. 전체 결과는 turbo/results/speed_epyc9334.txt에 있다.
zlib-turbo는 TurboBench에도 포함돼 있다. TurboBench는 여러 플랫폼에서 zlib, zlib-ng, libdeflate 등과 함께 성능을 측정하며, 결과는 벤치마크에서 볼 수 있다.
zlib 1.3.2에서 바뀐 점
변경 사항은 아홉 가지다.
- 해제(
inffast.c): 64비트 비트 버퍼와 넓은 복사를 추가했다. 새 빠른 반복문은 길이/거리 쌍마다 또는 리터럴 최대 세 개마다 8바이트씩 버퍼를 채우고, 일치 구간을 16바이트나 8바이트씩 복사한다. 첫 단계 디코딩 테이블을 리터럴·길이 10비트, 거리 8비트로 키워 두 번째 조회를 드물게 한다. 버퍼 끝 부근에서는 기존 반복문이 이전과 똑같이 마무리한다. - 64비트 대상의 Adler-32(
adler32.c): 8바이트씩 처리한다. 한 번의 곱셈으로 8바이트를 합산하고 두 번의 곱셈으로 가중치를 더하며, 나머지 연산은 2^20바이트마다 한 번만 한다. zlib 형식의 압축과 해제 모두 빨라진다. - 일치 구간 검색(
deflate.c): 2바이트 및 8바이트 비교를 사용한다. 후보를 2바이트씩 확인하고 8바이트씩 비교하지만, 같은 후보를 같은 순서로 시도하고 같은 길이를 찾는다. - 블록의 압축 데이터에 64비트 비트 기록기(
trees.c)를 추가했다. - 해시 테이블(
deflate.c)을 한 번에 8개 항목씩 이동해 컴파일러가 벡터화할 수 있게 했다. - 준비된 사전(
deflate.c, 새 헤더zturbo.h)을 추가했다. - 멀티스레드 압축(
deflate.c,trees.c,zturbo.h)을 추가했다. - 레벨 10~12(
deflate.c,zturbo.h)에 별도 최적 파싱 압축기를 추가했다. 레벨 9보다 4~6% 작고 libdeflate 레벨 12보다도 작지만 더 느리다. 출력은 zlib과 다르며 레벨 0~9는 바꾸지 않는다. - 선택형 SIMD 체크섬(
crc32.c,adler32.c)을 추가했다. 빌드에서 요청하면 캐리리스 곱셈 CRC-32와 AVX2 Adler-32를 사용한다.
각 변경의 작동 방식과 출력이 같은 이유, 성능 이득, 시험했다가 제외한 방법은 turbo/TECHNIQUES.md에 설명돼 있다.
기본 빌드는 이식 가능한 C89이며 SIMD 코드, 어셈블리, 실행 시 CPU 감지 기능을 사용하지 않는다. 따라서 zlib을 빌드할 수 있는 곳이면 같은 소스를 빌드할 수 있고, 최신 CPU를 대상으로 하는 컴파일러는 그에 맞는 코드를 생성할 수 있다. 예외는 빌드 시 선택하는 x86 SIMD 체크섬이다. 스레드는 POSIX 스레드 또는 Windows 자체 스레드를 사용한다.
멀티스레드 압축 사용과 조건
deflateSetThreads()로 스트림에 작업 스레드를 지정한다. 레벨 4~9에서는 작업 스레드가 파싱보다 앞서 일치 구간을 찾고 완성된 블록을 기록한다. 프로젝트는 스레드 수, 호출별 입력·출력 크기, 플러시, deflateParams(), 사전과 관계없이 압축 출력이 zlib과 바이트 단위로 같다고 설명한다.
#include "zturbo.h"
deflateInit(&strm, 6);
deflateSetThreads(&strm, 16); /* 0 or 1: back to one thread */
/* deflate() as usual */
아래는 Silesia/enwik8 기준 MB/s다.
| 레벨 | 스레드 1개 | 스레드 4개 | 스레드 8개 | 스레드 16개 | 스레드 24개 |
|---|---|---|---|---|---|
| 4 | 85.8 / 70.7 | 214 / 205 | 223 / 212 | 232 / 219 | 211 / 211 |
| 6 | 35.8 / 27.1 | 126 / 103 | 202 / 190 | 218 / 210 | 198 / 206 |
| 9 | 14.1 / 20.7 | 51 / 78 | 92 / 155 | 148 / 223 | 160 / 211 |
각 파일을 deflate() 한 번으로 통째로 압축했다. 스레드는 2 × 32코어 AMD EPYC 9334 한 소켓에서 사용했으며 GCC 14 -O2로 두 번 측정한 값 중 빠른 결과다. zlib 1.3.2는 레벨 6에서 31.9/24.4MB/s, 레벨 9에서 13.1/18.9MB/s를 기록했다. 스레드 16개를 사용하면 레벨 6은 zlib보다 6.8배, 레벨 9는 11~12배 빠르다. 호출 스레드가 zlib의 순서대로 모든 일치 구간을 결정하기 때문에 속도는 약 220MB/s에서 정체된다. Silesia의 레벨 9에서는 작업 스레드가 한계다. 레벨 1~3, Z_HUFFMAN_ONLY, Z_RLE는 한 스레드만 쓴다. 이 설정에서는 일치 구간이 앞선 매치에 좌우돼 같은 결과를 유지하면서 미리 찾을 수 없기 때문이다.
zturbo.h에는 스레드 사용 시 지켜야 할 조건이 두 가지 있다. deflate()가 입력을 남긴 채 반환하면 다음 호출에 같은 바이트를 다시 제공해야 한다. 주소는 달라도 되지만 작업 스레드가 미리 읽기 때문에 내용은 같아야 한다. 또한 작업 스레드는 해당 호출에 남은 출력 공간에 블록 전체가 들어갈 때만 블록을 기록한다. 위 속도를 얻으려면 호출마다 deflate()에 출력 공간을 256KiB 이상 제공해야 한다. 작업 스레드 하나당 메모리는 약 4MB다. 전체 결과는 turbo/results/threads_epyc9334.txt에 있다.
준비된 사전
deflateSetDictionary()는 스트림마다 사전을 다시 색인한다. 입력 첫 바이트를 처리하기 전 해시 삽입을 최대 32K회 수행할 수 있다. HTTP나 RPC 페이로드, 로그 레코드, 데이터베이스 행처럼 같은 사전을 사용해 짧은 메시지를 많이 압축할 때는 색인 작업이 대부분의 비용을 차지할 수 있다. 준비된 사전은 한 번 색인한 뒤 여러 스트림과 스레드에서 읽기 전용으로 공유한다.
#include "zturbo.h"
z_dict *dict;
deflatePrepareDictionary(&first, dictionary, dictionary_length, &dict); /* on a just-initialized stream */
...
deflateReset(&strm);
deflateUseDictionary(&strm, dict); /* same effect and output as deflateSetDictionary() */
...
deflateFreeDictionary(dict);
deflateUseDictionary()는 deflateSetDictionary()와 같은 상태를 스트림에 설정한다. 반환값, total_in, Adler-32, 압축 출력이 바이트 단위로 같다. 다른 windowBits나 memLevel을 사용하거나 스트림이 초기화 직후 또는 재설정 직후가 아니어서 복사할 수 없으면 deflateSetDictionary()를 호출한다.
| 메시지 크기 | 레벨 | zlib 1.3.2 | zlib-turbo, 준비된 사전 | 배수 |
|---|---|---|---|---|
| 256 B | 1 | 44.2 µs | 10.8 µs | 4.1배 |
| 1 KiB | 1 | 55.7 µs | 20.5 µs | 2.7배 |
| 4 KiB | 1 | 89.3 µs | 47.8 µs | 1.9배 |
| 256 B | 6 | 53.4 µs | 19.5 µs | 2.7배 |
| 1 KiB | 6 | 91.7 µs | 55.4 µs | 1.7배 |
메시지 하나당 시간이다. 각 메시지는 32KiB 사전을 쓰는 별도 zlib 스트림으로 압축했다. 메시지는 enwik8에서 가져왔으며 AMD EPYC 9334의 코어 하나, GCC 14에서 측정했다. DCLM-baseline 샤드의 JSON 레코드에서도 같은 양상이 나왔다. 전체 결과는 turbo/results/dictionary_epyc9334.txt에 있다.
이 함수들은 zlib.h가 아니라 zturbo.h에 선언돼 있고, 자체 버전 태그(ZLIB_TURBO_1.0)로 내보낸다. 따라서 zlib용으로 빌드한 프로그램에는 차이가 보이지 않는다. zlibTurboVersion()은 실행 중인 라이브러리가 zlib-turbo인지 알려주며, zlibVersion()은 기반이 된 zlib 버전을 반환한다.
레벨 10~12
레벨 10, 11, 12는 레벨 9보다 더 작게 압축하고 libdeflate 레벨 12보다도 작지만 속도는 초당 몇 MB 수준이다. 별도 압축기를 사용하므로 출력은 zlib과 다르다. 그러나 모든 압축 해제기가 처리할 수 있는 일반 deflate 데이터이며, 같은 입력·플러시·매개변수를 사용하면 입력을 어떤 방식으로 공급해도 출력이 같다. 다른 레벨과 마찬가지로 요청할 수 있다.
deflateInit2(&strm, 12, Z_DEFLATED, 15, 8, Z_DEFAULT_STRATEGY); /* or compress2(dest, &len, src, n, 12) */
아래 값은 원시 deflate 바이트 크기와 속도(MB/s)다.
| 압축기 | Silesia | enwik8 | Canterbury + Calgary |
|---|---|---|---|
| zlib 레벨 9 | 67,643,201 · 14.2 | 36,475,786 · 20.7 | 1,783,551 · 8.4 |
| libdeflate 1.26 레벨 9 | 66,715,085 · 35.8 | 36,244,245 · 39.2 | 1,739,956 · 27.4 |
| libdeflate 1.26 레벨 12 | 64,681,628 · 6.5 | 35,103,237 · 8.5 | 1,688,340 · 6.3 |
| Zopfli 1.0.3(반복 15회) | 64,713,006 · 0.29 | 34,966,060 · 0.65 | 1,680,016 · 0.32 |
| zlib-turbo 레벨 10 | 64,681,882 · 5.5 | 35,016,775 · 5.6 | 1,687,697 · 5.5 |
| zlib-turbo 레벨 11 | 64,613,145 · 4.4 | 35,012,093 · 5.1 | 1,684,734 · 4.4 |
| zlib-turbo 레벨 12 | 64,584,749 · 3.2 | 35,007,174 · 3.9 | 1,682,786 · 3.1 |
각 파일을 AMD EPYC 9334의 코어 하나에서 GCC 14 -O2로 통째로 압축했고, 두 번 측정한 시간 중 빠른 값을 썼다. 레벨 12는 libdeflate 레벨 12보다 0.15~0.33% 작지만 속도는 절반이다. 레벨 9보다는 4.0~5.7% 작다. Zopfli와 비교하면 Silesia에서는 0.2% 작고 다른 데이터에서는 0.1~0.2% 크며, 속도는 6~11배다. 레벨 10은 Silesia에서 libdeflate 레벨 12와 같은 크기다. 파일별 결과는 turbo/results/levels10-12_epyc9334.txt에 있다.
작동 방식은 다음과 같다. 입력을 앞의 32KiB를 포함해 256KiB씩 파싱한다. 윈도 안의 문자열을 이진 트리로 관리해 각 위치에서 가능한 모든 매치를 찾는다. 지연 파싱 통계의 비용으로 시작해 각 블록 자체의 허프만 코드 비용을 사용하는 방식까지 여러 차례 파싱을 반복하며, 주어진 비트 비용에서 가장 저렴한 경로를 찾는다. 블록 경계는 엔트로피 추정치에 대한 동적 계획법으로 결정한다. 각 블록은 동적, 고정, 저장 방식 중 가장 작은 것으로 기록한다. 자세한 내용은 turbo/TECHNIQUES.md에 있다.
스트림마다 약 24MB를 사용하며 압축 전에 최대 256KiB 입력을 보관한다. 플러시하면 현재까지의 입력을 압축한다. 스트림은 언제든 레벨 10~12 사이에서 바꿀 수 있지만, 레벨 0~9와 이들 레벨 사이의 변경은 첫 deflate() 호출 전에만 가능하다. 스레드는 아직 이 레벨의 속도를 높이지 않는다. Z_BEST_COMPRESSION은 계속 9다.
선택형 SIMD 체크섬
./configure --simd 또는 CMake의 -DZLIB_TURBO_SIMD=ON을 사용한다. 또는 -DZ_TURBO_SIMD와 함께 -mpclmul -mavx2, -march=x86-64-v3 또는 MSVC의 /arch:AVX2를 지정한다. CRC-32는 캐리리스 곱셈(PCLMULQDQ)으로 한 번에 64바이트를 처리하고, Adler-32는 AVX2로 한 번에 32바이트를 합산한다. 결과는 스칼라 코드와 비트 단위로 같다. 실행 시 CPU 감지는 하지 않으므로 이 빌드의 라이브러리는 AVX2와 PCLMULQDQ를 지원하는 프로세서에서만 실행된다. 해당 지원은 Intel에서는 2013년부터, AMD에서는 2015년부터 제공됐다. 기본 빌드는 이전처럼 순수 C다.
AMD EPYC 9334, GCC 14 -O2, 코어 하나에서 측정한 값이다.
| 작업 | zlib 1.3.2 | zlib-turbo | zlib-turbo, SIMD | SIMD 적용 시 차이 |
|---|---|---|---|---|
| CRC-32 | 2.77 GB/s | 2.77 GB/s | 15.3 GB/s | 5.5배 |
| Adler-32 | 3.87 GB/s | 5.52 GB/s | 41.1 GB/s | 7.4배 |
| gzip 해제, Silesia/enwik8 | 418 / 336 MB/s | 650 / 555 | 806 / 667 | +24% / +20% |
| zlib 스트림 해제, Silesia/enwik8 | 437 / 349 MB/s | 736 / 619 | 834 / 685 | +13% / +11% |
| gzip 압축, 레벨 1, Silesia | 113 MB/s | 147 | 154 | +5% |
레벨 6 스트림을 파일별로 한 번의 호출로 처리했다. 마지막 열은 SIMD를 사용하지 않는 zlib-turbo와 비교한 값이다. 입력 16KiB·출력 64KiB 조각으로 해제하면 gzip은 17~24%, zlib은 9~14% 빨라지고 압축은 1~5% 빨라지며 출력은 같다. 전체 결과는 turbo/results/simd_epyc9334.txt에 있다.
테스트 방법
모든 테스트는 예상 출력만 확인하는 대신 수정하지 않은 zlib 1.3.2와 zlib-turbo를 비교했다고 프로젝트는 밝힌다.
| 테스트 | 확인 내용 |
|---|---|
| 동일 출력 | 세 코퍼스의 모든 파일을 레벨 0~9로 압축해 바이트가 같은지 확인 |
| 손상된 스트림 | 무작위 입력·출력 조각에서 비트 반전, 바이트 덮어쓰기, 잘라내기로 손상한 스트림 34,860개를 처리해 각 스트림의 반환 코드, 출력 길이, CRC가 zlib과 같은지 확인 |
| 유효한 스트림 | 11개 압축 설정을 대상으로 한 호출, 크기가 제각각인 무작위 조각, inflateBack()을 포함해 2,809개 검사 수행 |
| 메모리 검사기 | 위 항목을 모두 AddressSanitizer와 UndefinedBehaviorSanitizer에서 실행. INFLATE_STRICT, INFLATE_ALLOW_INVALID_DISTANCE_TOOFAR_ARRR, PKZIP_BUG_WORKAROUND를 켠 빌드도 포함 |
| 아키텍처 | x86-64, 32비트 x86, arm64, ARMv5, ppc64le, 빅엔디안 s390x(QEMU)에서 같은 결과를 확인. 기본값으로 비활성화된 8바이트 Adler-32를 강제로 켠 경우와 Windows의 MSVC 2022도 검사 |
| 차등 퍼징 | zlib 1.3.2를 대상으로 libFuzzer 실행. 해제는 AddressSanitizer에서 3,600만 회, UndefinedBehaviorSanitizer에서 3,500만 회. 압축은 모든 플러시 모드, deflateParams(), 사전 설정·준비, deflatePrime(), deflateReset()을 포함해 AddressSanitizer에서 570만 회, UndefinedBehaviorSanitizer에서 280만 회 실행. 차이와 오류 보고가 없었다고 설명 |
| 사전 | 테스트 파일별로 레벨, 윈도, memLevel, 전략, 사전 길이의 조합 9,315개를 확인. zlib의 deflateSetDictionary()와 zlib-turbo의 deflateSetDictionary() 및 deflateUseDictionary()가 같은 결과를 냈는지 검사 |
| 스트리밍 | Z_SYNC_FLUSH에서 압축 바이트가 준비되는 즉시 플러시 지점 이전의 모든 바이트가 출력되는지 43,815개 메시지로 확인 |
| 스레드 | 레벨 4~9에서 설정별 23개 사례를 사용. 입력·출력을 1바이트까지 조각 내고 동기·전체 플러시, 다른 레벨과 전략으로의 deflateParams() 전환과 복귀, 원시 및 zlib 사전, 호출 사이 입력 이동·덮어쓰기를 포함해 파일 12개와 스레드 3~16개로 총 1,656개 사례 검사. 모든 출력 바이트와 반환 코드가 단일 스레드와 같은지 확인하고 어서션을 켰다. ThreadSanitizer(clang 및 GCC), AddressSanitizer, UndefinedBehaviorSanitizer, 32비트 x86, MSVC와 Windows 스레드에서도 검사 |
| 레벨 10~12 | 레벨별 23개 설정에서 입력·출력 1바이트 조각, 31~131,072바이트 간격의 플러시, 윈도 크기, memLevel, 원시·zlib·gzip 형식, 전략, 사전, deflateCopy(), 레벨 사이 deflateParams()를 코퍼스 파일 5개에 적용. AddressSanitizer와 UndefinedBehaviorSanitizer에서도 검사해 모든 스트림이 입력으로 해제되는지, 기본 zlib으로도 해제되는지, 입력 공급 방식과 관계없이 같은 바이트를 내는지 확인. zlib 1.3.2의 inflate를 대상으로 한 libFuzzer는 AddressSanitizer에서 409,943회, UndefinedBehaviorSanitizer에서 223,448회 실행했고 오류 보고가 없었다고 설명 |
| SIMD 체크섬 | CRC-32와 Adler-32를 바이트 단위 기준 구현과 비교. 길이 0~4096의 모든 경우를 정렬 위치 0~63에서 확인하고, 무작위 바이트와 Adler-32 합이 가장 커지는 모두 1인 긴 버퍼를 한 번 및 조각별로 검사. crc32_combine()과 adler32_combine()도 포함해 총 527,572개 사례를 GCC 14(또는 -march=x86-64-v3), clang 18, 32비트 x86, MSVC, AddressSanitizer와 UndefinedBehaviorSanitizer에서 확인. SIMD를 켠 상태에서도 레벨 0~9 압축 출력, 손상 스트림 테스트, make test, ctest가 같았다고 설명 |
| zlib 자체 테스트 | ZLIB_DEBUG 빌드를 포함해 make test 실행. 빠른 반복문을 위한 새 사례를 추가한 zlib의 test/infcover.c도 실행 |
빌드와 설치
zlib과 같은 방식으로 빌드할 수 있다. ./configure && make test && make install을 실행하거나 CMake 또는 win32/ 파일을 사용한다. 라이브러리 이름은 zlib과 같은 libz.so.1, zlib1.dll이며, zturbo.h를 zlib.h 옆에 설치한다.
스레드를 사용해 빌드하므로 필요한 플랫폼에서는 -pthread로 링크한다. 스레드 없이 빌드하려면 ./configure --no-threads 또는 CMake의 -DZLIB_TURBO_THREADS=OFF를 사용한다. 이 경우 deflateSetThreads()는 스레드 하나만 허용한다. win32/ 파일은 -DZ_TURBO_THREADS를 추가하지 않으면 스레드 없이 빌드한다. SIMD 체크섬을 추가하려면 ./configure --simd 또는 CMake의 -DZLIB_TURBO_SIMD=ON을 사용한다. 이 기능은 AVX2와 PCLMULQDQ를 지원하는 x86에서만 쓸 수 있다. win32/ 파일에서는 -DZ_TURBO_SIMD -arch:AVX2를 추가한다.
결과 재현
turbo/ 스크립트는 임의의 두 zlib 소스 트리를 비교한다.
git clone https://github.com/madler/zlib zlib-1.3.2 && git -C zlib-1.3.2 checkout v1.3.2
sh turbo/tests/run_compress.sh zlib-1.3.2 . silesia/ # identical output and compression speed, levels 0 to 9
sh turbo/bench/run_speed.sh zlib-1.3.2 . silesia/ > speed.txt && python3 turbo/bench/summarize.py speed.txt
sh turbo/tests/run_stress.sh zlib-1.3.2 . inputs/ # damaged streams, under the sanitizers
sh turbo/tests/run_dict.sh zlib-1.3.2 . silesia/xml # prepared dictionaries
sh turbo/tests/run_threads.sh . 8 silesia/* # threads: the same bytes as one thread
sh turbo/tests/run_opt.sh zlib-1.3.2 . silesia/* # levels 10 to 12: round trips, also through zlib
cc -O2 -DZ_TURBO_SIMD -mpclmul -mavx2 -I. adler32.c crc32.c zutil.c turbo/tests/zsum.c -o zsum && ./zsum check
TIME=3600 sh turbo/tests/fuzz/run_fuzz.sh zlib-1.3.2 . inputs/ # decompression, differential
TIME=3600 sh turbo/tests/fuzz/run_fuzz_deflate.sh zlib-1.3.2 . inputs/ # compression, differential
zlib과의 관계와 라이선스
zlib-turbo는 장루프 가이(Jean-loup Gailly)와 마크 애들러(Mark Adler)가 만든 zlib 1.3.2를 수정한 버전이다. zlib 라이선스 요구에 따라 수정본임을 명시하며, 원본 zlib이 아니고 원저자의 승인을 받은 제품도 아니다. zlib 릴리스를 따라간다. 해제 기능 변경은 zlib에 풀 리퀘스트 #793으로도 제안됐다. 마이크로컨트롤러용 inflate 라이브러리인 bitbank2/zlib_turbo와는 관련이 없다.
라이선스는 zlib과 같은 zlib 라이선스다. zlib의 저작권은 Copyright (C) 1995-2026 Jean-loup Gailly and Mark Adler이며, zlib-turbo의 변경 사항 저작권은 Copyright (C) 2026 Yingquan (Cody) Wu다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요